9  Aprendizaje Profundo para Visión por Computador

Los capítulos anteriores establecieron los fundamentos de la Visión por Computador (VC) mediante métodos clásicos de extracción y representación de características. En el Capítulo 7, descriptores como Local Binary Patterns (LBP) e Histogram of Oriented Gradients (HOG) mostraron cómo texturas y formas pueden codificarse mediante descriptores diseñados manualmente. En el Capítulo 8, algoritmos como Oriented FAST and Rotated BRIEF (ORB) y el detector Haar Cascade extendieron ese principio a tareas de correspondencia, detección y reconocimiento de objetos.

Estas técnicas siguen siendo relevantes por su interpretabilidad y eficiencia computacional, pero dependen de una etapa previa de definición manual de descriptores, denominada ingeniería de características (feature engineering). Esa dependencia limita la adaptación del modelo a escenarios para los cuales el descriptor no fue diseñado.

El Aprendizaje Profundo (Deep Learning) propone una alternativa: en lugar de especificar manualmente las características relevantes, el modelo aprende automáticamente representaciones a partir de los datos durante el entrenamiento —proceso conocido como aprendizaje de representaciones (representation learning) (GOODFELLOW, 2016). En la VC, esta estrategia se implementa principalmente mediante las Redes Neuronales Convolucionales (Convolutional Neural Networks — CNNs), en las cuales los filtros convolucionales dejan de tener coeficientes fijos y pasan a ser ajustados por algoritmos de optimización.

Aunque representan un cambio en la construcción de sistemas de reconocimiento de patrones, las CNNs preservan conceptos ya estudiados en este libro: la convolución, presentada en el Capítulo 3, sigue siendo la operación responsable de la extracción local de características, ahora aplicada con coeficientes aprendidos en lugar de diseñados.

Cabe señalar que el objetivo de este capítulo no es explorar exhaustivamente la teoría del Aprendizaje Profundo, sino ofrecer una visión general de sus fundamentos y demostrar cómo se aplican estas arquitecturas en el contexto de la VC. Los lectores interesados en una profundización teórica y conceptual en el área deben recurrir a referencias especializadas de la literatura, como Goodfellow (2016) y Lecun (2015).

9.1 Objetivos del Capítulo

Al final de este capítulo, el estudiante deberá ser capaz de:

  • Relacionar la convolución aprendida por las CNNs con la convolución de kernels fijos presentada en el Capítulo 3;
  • Describir la arquitectura básica de una CNN y la función de sus capas principales;
  • Implementar, entrenar y evaluar modelos de CNN para clasificación de imágenes;
  • Aplicar transferencia de aprendizaje (transfer learning) para adaptar modelos preentrenados a nuevos problemas;
  • Utilizar modelos preentrenados en tareas de clasificación, detección de objetos y segmentación;
  • Implementar, entrenar y evaluar una arquitectura U-Net para segmentación semántica, comparándola con enfoques clásicos;
  • Preparar conjuntos de datos anotados e integrarlos en un pipeline de entrenamiento mediante plataformas como Roboflow;
  • Integrar geometría computacional y Aprendizaje Profundo en aplicaciones de realidad aumentada y fotogrametría.

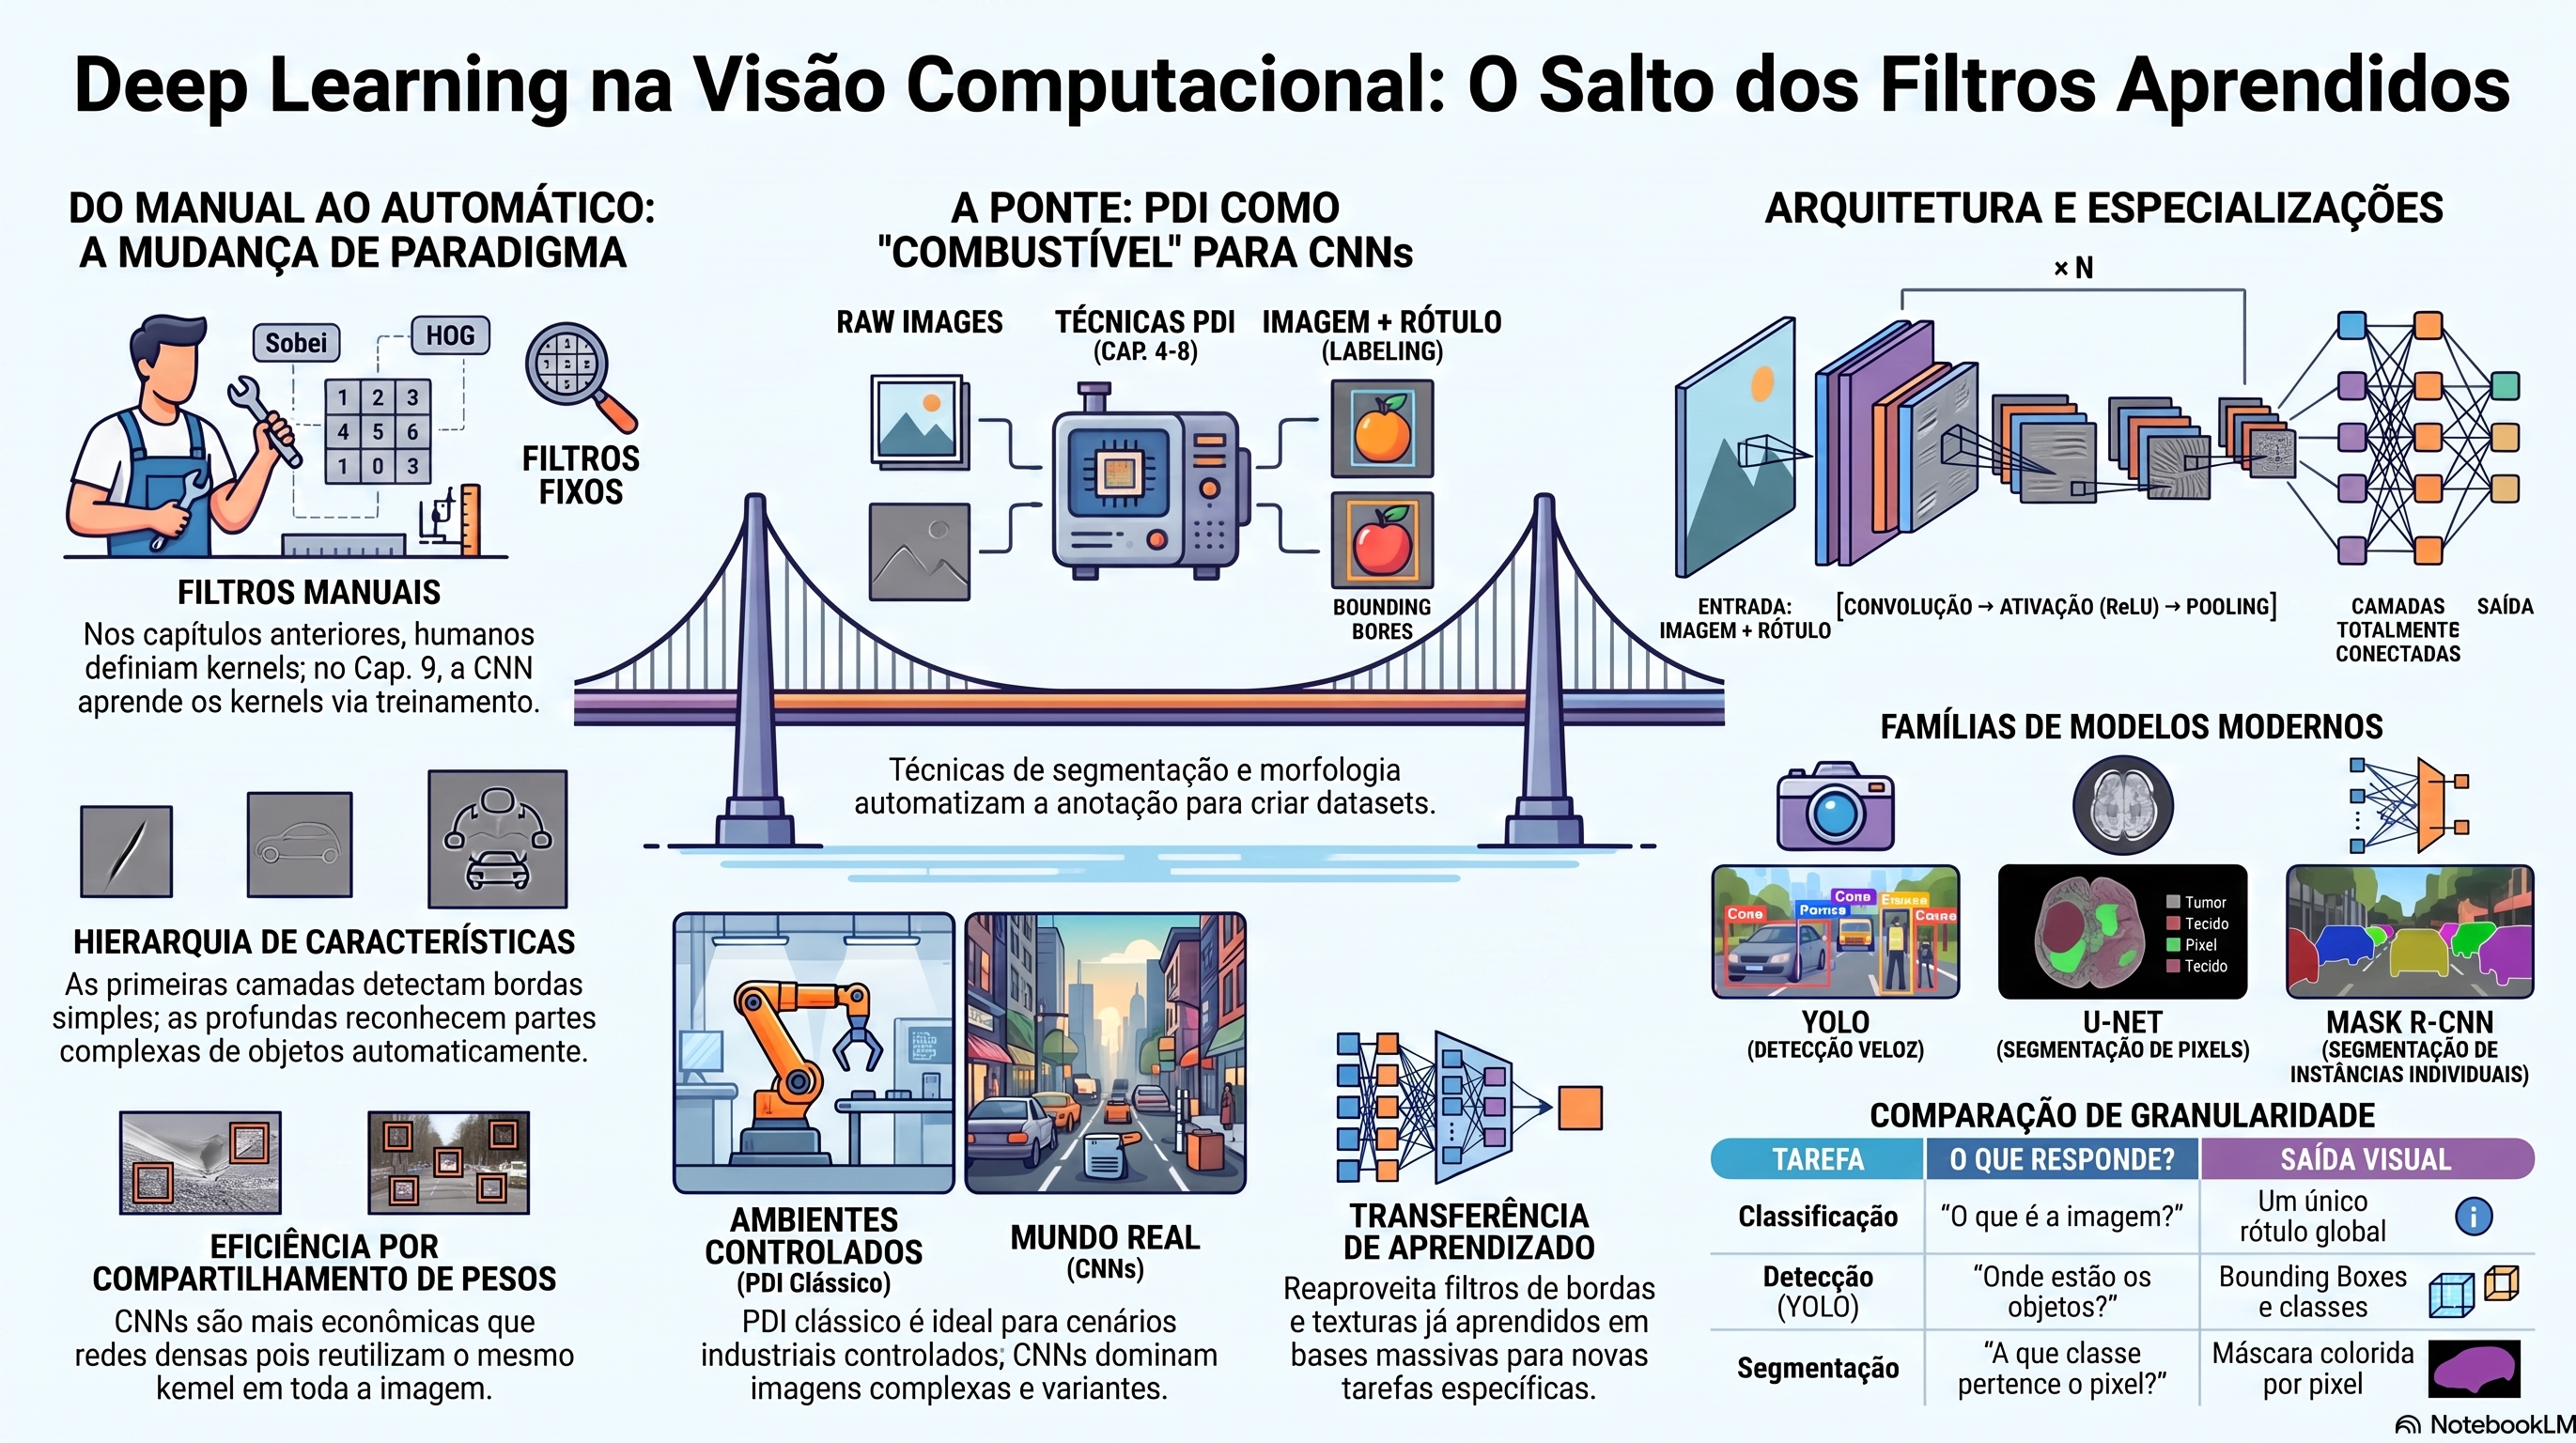
La Figura 9.1 sintetiza la organización de los conceptos estudiados en este capítulo y las relaciones entre ellos.

Figura 9.1: Visión general de los principales conceptos abordados en este capítulo. Fuente: elaborado con ayuda de Gemini Notebook ({GOOGLE}, 2025).

9.2 Panorama: Clasificación, Detección y Segmentación

Las tareas de VC se diferencian, sobre todo, por la información producida como salida. La clasificación asigna una única etiqueta a la imagen completa; la detección de objetos localiza e identifica los objetos presentes en la escena; la segmentación asocia una clase a cada píxel y, en algunos enfoques, distingue diferentes instancias de una misma categoría.

La Tabla 9.1 resume las tareas estudiadas a lo largo del libro, indicando la pregunta que cada una responde y la granularidad de la información producida.

Tabla 9.1: Comparativa entre las principales tareas de VC según la granularidad de la información producida.
Tarea Pregunta respondida Granularidad de la salida Capítulo
Clasificación “¿Cuál es la clase de esta imagen?” Una única etiqueta para la imagen completa 7 y 9
Detección de objetos “¿Qué objetos existen y dónde están?” Clase y caja delimitadora (bounding box) para cada objeto 8 y 9
Segmentación semántica “¿A qué clase pertenece cada píxel?” Una etiqueta de clase para cada píxel 8 y 9
Segmentación de instancias “¿Qué píxeles pertenecen a cada objeto?” Una etiqueta por píxel para cada instancia 8 y 9
Segmentación panóptica “¿Cuál es la clase y la identidad de cada objeto?” Clase e identificador de instancia para cada píxel 8 y 9

Estas tareas representan niveles crecientes de interpretación de la imagen: la clasificación describe la escena de forma global, la detección añade la localización de los objetos y la segmentación produce una representación espacial detallada, permitiendo analizar cada región individualmente. Este capítulo se centra, primero, en la clasificación por CNNs, para luego extender los mismos principios a la detección y a la segmentación.

9.3 Configuración del Entorno

Los ejemplos de este capítulo utilizan PyTorch, un framework ampliamente empleado en el desarrollo y entrenamiento de modelos de Aprendizaje Profundo. El siguiente código verifica la disponibilidad de las bibliotecas necesarias e instala, automáticamente, aquellas aún no presentes en el entorno de ejecución.

En caso de que PyTorch no esté instalado, se selecciona automáticamente una versión compatible con el hardware disponible: la versión con soporte para CUDA, si hay una GPU NVIDIA disponible, o la versión para ejecución en CPU, en caso contrario.

A continuación, el entorno se inicializa con la importación de las bibliotecas utilizadas a lo largo del capítulo, la definición de una semilla aleatoria para favorecer la reproducibilidad de los experimentos y la obtención del archivo morph.py — la biblioteca didáctica de procesamiento morfológico ya utilizada en capítulos anteriores —, en caso de que aún no esté disponible en el directorio de trabajo.

import contextlib, importlib, importlib.metadata, importlib.util
import io, os, random, shutil, subprocess, sys, urllib.request, warnings

# Suprime avisos de PyTorch y advertencias generales
warnings.filterwarnings("ignore", category=UserWarning)

url = ("https://raw.githubusercontent.com/fzampirolli/"
       "pdi-vc/master/morph/config.py")
if not os.path.exists("config.py"):
    urllib.request.urlretrieve(url, "config.py")

import config

# Silencia stdout y stderr tanto a nivel de Python como de descriptores de archivo del SO
def setup_silencioso():
    with open(os.devnull, "w") as fnull:
        old_out = os.dup(1)
        old_err = os.dup(2)
        try:
            os.dup2(fnull.fileno(), 1)
            os.dup2(fnull.fileno(), 2)
            with contextlib.redirect_stdout(fnull), contextlib.redirect_stderr(fnull):
                config.setup()
        finally:
            os.dup2(old_out, 1)
            os.dup2(old_err, 2)
            os.close(old_out)
            os.close(old_err)

setup_silencioso()
from morph import mm


def setup_cap09():
    """Instala librerías faltantes para este capítulo de forma 100% silenciosa."""
    pkgs = {
        "skimage": "scikit-image", "numpy": "numpy",
        "sklearn": "scikit-learn", "matplotlib": "matplotlib",
        "torchviz": "torchviz", "ultralytics": "ultralytics",
        "roboflow": "roboflow",
    }
    for mod, pkg in pkgs.items():
        if importlib.util.find_spec(mod) is None:
            subprocess.run([sys.executable, "-m", "pip", "install", "-q", pkg],
                           stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

    if importlib.util.find_spec("torch") is None:
        args = (["torch", "torchvision"] if shutil.which("nvidia-smi")
                 else ["--index-url",
                       "https://download.pytorch.org/whl/cpu",
                       "torch", "torchvision"])
        subprocess.run([sys.executable, "-m", "pip", "install", "-q", *args],
                       stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

    if not shutil.which("dot") and shutil.which("apt-get"):
        subprocess.run(["apt-get", "install", "-y", "-qq", "graphviz"],
                       stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL, check=False)


setup_cap09()

import cv2, numpy as np, torch
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import torchvision.models as models
import torchvision.transforms as T
from PIL import Image
from skimage import data as skdata
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from torch.utils.data import DataLoader, TensorDataset
from torchvision.datasets import OxfordIIITPet
from torchvision.models.detection import (
    fasterrcnn_resnet50_fpn, FasterRCNN_ResNet50_FPN_Weights)
from torchvision.models.segmentation import deeplabv3_resnet50
from torchvision.transforms.functional import to_tensor
from torchviz import make_dot
from ultralytics import YOLO

torch.manual_seed(42)
FLAG_LIMPAR_DADOS = False
device = "cuda" if torch.cuda.is_available() else "cpu"
gpu = f" ({torch.cuda.get_device_name(0)})" if device == "cuda" else ""
ver = importlib.metadata.version("ultralytics")
print(f"✅ Ambiente listo. OpenCV {cv2.__version__} | "
      f"morph {getattr(mm, '__version__', 'local_file')} | "
      f"PyTorch {torch.__version__} | Ultralytics {ver} | {device}{gpu}")
✅ Ambiente listo. OpenCV 5.0.0 | morph local_file | PyTorch 2.6.0+cu124 | Ultralytics 8.4.113 | cuda (NVIDIA GeForce GTX TITAN X)

9.4 Fundamentos del Aprendizaje Profundo para VC

Las CNN son la principal arquitectura de Aprendizaje Profundo aplicada al análisis de imágenes. Su funcionamiento se basa en la composición de operaciones convolucionales organizadas en capas sucesivas, en las cuales los filtros aprendidos durante el entrenamiento transforman la imagen en representaciones progresivamente más abstractas. En esta sección, se presentan los conceptos fundamentales que conectan la convolución espacial estudiada anteriormente con los modelos modernos de VC, incluyendo la extracción jerárquica de características, el proceso de entrenamiento y la utilización de modelos preentrenados.

9.4.1 De la Convolución Fija a la Convolución Aprendida

El Capítulo 3 presentó la convolución espacial con kernels fijos, como los operadores de Sobel, diseñados para resaltar características específicas de una imagen. En los Capítulos 7 y 8, el mismo principio sustentó descriptores como HOG, LBP y ORB, además del detector Haar Cascade: en todos estos casos, los filtros se definen antes de la ejecución del algoritmo y permanecen inalterados durante el procesamiento.

La Figura 9.2 retoma el funcionamiento de la convolución espacial: el simulador permite seleccionar diferentes kernels y seguir el desplazamiento de la ventana de convolución sobre una imagen. En cada posición, los coeficientes del kernel se combinan con la vecindad local de la imagen —denominada campo receptivo (receptive field)— para producir un valor del mapa de características (feature map), ilustrando también el compartimiento de pesos (weight sharing).

Las CNNs preservan esta operación, pero sustituyen kernels fijos por filtros aprendidos: en lugar de coeficientes definidos previamente, la red ajusta estos valores durante el entrenamiento a partir de ejemplos etiquetados, buscando minimizar una función de pérdida (loss function), que mide la diferencia entre las predicciones del modelo y las respuestas esperadas.

La diferencia esencial entre los métodos clásicos y las CNNs, por tanto, no reside en la operación de convolución en sí, sino en la forma en que se obtienen los filtros: mientras que los primeros utilizan filtros diseñados manualmente, las CNNs aprenden, a partir de los datos de entrenamiento, representaciones adecuadas para la tarea.

🎯 Simulador: Operación de Convolución 2D Clásica Entrada 12×12 · Kernel 3×3 · Paso 1
IMAGEN DE ENTRADA (12×12)
FILTRO (KERNEL 3×3)
Posición Actual: (0, 0) [Salida 10×10]
Entrada (12×12)
Kernel (3×3)
Mapa de Salida (10×10)
∑ (xᵢ × wᵢ) = cálculo de la posición actual...
Figura 9.2: Simulador interactivo de convolución 2D clásica: elige entre las tres imágenes sintéticas de entrada 12×12 (casa, cara feliz o triste) y un filtro 3×3 (Sobel V, Sobel H, Nitidez o Identidad) y avanza paso a paso para observar cómo los productos internos locales del campo receptivo construyen el mapa de características célula a célula.

Para comprender cómo ocurre ese aprendizaje, es necesario estudiar la unidad básica de procesamiento de las redes neuronales: el neurona artificial.

9.4.2 Neurona Artificial

La neurona artificial (artificial neuron) es la unidad fundamental de procesamiento de una red neuronal. Su primer modelo matemático —un conjunto de entradas combinadas y comparadas con un umbral— fue propuesto por Mcculloch (1943), aún sin ningún mecanismo de aprendizaje. El Perceptrón (ROSENBLATT, 1958) avanzó sobre esta formulación al introducir una regla de ajuste de los pesos a partir de ejemplos, convirtiéndose en el primer modelo de neurona artificial capaz de aprender y en la base de las arquitecturas modernas de Aprendizaje Profundo (Deep Learning). El término Aprendizaje Profundo se refiere al uso de redes con múltiples capas de procesamiento, capaces de aprender representaciones jerárquicas de los datos: las primeras capas aprenden características simples, como bordes y texturas, y las capas más profundas combinan progresivamente estas representaciones para identificar estructuras y objetos más complejos.

Cada neurona recibe un conjunto de entradas, calcula una combinación lineal de estos valores y aplica una función de activación (activation function), produciendo un único valor de salida. Matemáticamente, la combinación lineal está dada por

\[ z=\sum_{i=1}^{n}w_i x_i+b, \]

donde \(x_i\) representan las entradas, \(w_i\) los pesos asociados a cada entrada y \(b\) el sesgo (bias). La salida de la neurona se obtiene aplicando la función de activación:

\[ y=f(z). \]

En las CNNs, este principio adopta formas distintas según la capa. En las capas convolucionales (convolutional layers), cada neurona procesa solo una pequeña región de la entrada, denominada campo receptivo (receptive field), preservando la organización espacial de la imagen. En las capas totalmente conectadas (fully connected layers), cada neurona recibe todas las salidas de la capa anterior, combinando las características extraídas para producir la salida final de la red, como la clase asignada a la imagen.

La Figura 9.3 ilustra el funcionamiento de una neurona artificial: el simulador permite modificar las entradas (\(x_1\) y \(x_2\)), los pesos (\(w_1\) y \(w_2\)), el sesgo (\(b\)) y la función de activación, observando en tiempo real el cálculo de la combinación lineal y de la salida correspondiente.

⚙️ Simulador: Neurona Artificial en una CNN y = f(∑ wᵢxᵢ + b)
x₁ w₁
x₂ w₂
b
Los valores de x varían de -3 a 3 porque, en una CNN, los píxeles (0–255) se normalizan antes de entrar a la red. El dibujo al lado traduce ese valor normalizado de vuelta a un tono de gris, solo para dar intuición visual — los números que valen para el cálculo son los de las barras.
Campo Receptivo → Convolución → Mapa de Características
Activación en f(z)
x₁, x₂ = intensidad de los píxeles en el campo receptivo · w₁, w₂ = pesos del kernel (filtro) · z = resultado de la convolución en esta posición · y = valor del píxel producido en el mapa de características, tras la activación.
z = (1.00 × 0.80) + (-1.50 × 0.50) + 0.20 = 0.25 → y = 0.25
Figura 9.3: Simulador interactivo de la Neurona Artificial en contexto de CNN: alterne entre una neurona de capa convolucional (donde x_i son intensidades de píxel en un campo receptivo y w_i son pesos del kernel) y una neurona de capa totalmente conectada, ajustando entradas, pesos, sesgo y función de activación para visualizar el cálculo de z y de la salida y en tiempo real.

En una CNN, miles de neuronas se organizan en capas con funciones específicas: las primeras son responsables de la extracción de características mediante la convolución, y las últimas realizan la clasificación a partir de las características aprendidas.

9.4.3 Capa Convolucional

La capa convolucional (convolutional layer) es responsable de la extracción de características de la imagen. Cada filtro genera un mapa de características (feature map), cuya intensidad en cada posición indica la respuesta del filtro a la región correspondiente de la entrada.

La operación realizada sigue el mismo principio de desplazamiento y combinación local presentado en el Capítulo 3 para la convolución espacial. Considerando un kernel \(K\) de dimensión \(k \times k\), el valor producido en la posición \((i,j)\) está dado por

\[ F(i,j)=\sum_{u=0}^{k-1}\sum_{v=0}^{k-1}K(u,v)\,I(i+u,j+v). \]

Cabe registrar una distinción terminológica: la expresión anterior corresponde, formalmente, a una correlación cruzada (cross-correlation), y no a la convolución matemática estricta, que exige la reflexión del kernel antes de la combinación. La mayoría de los frameworks de Aprendizaje Profundo, incluido PyTorch, implementa esta operación sin reflexión y la designa, por convención, como convolución — convención adoptada también en este capítulo. Esta diferencia no tiene efecto práctico sobre el entrenamiento, ya que los coeficientes del kernel se aprenden y no se imponen previamente.

La principal diferencia respecto a los métodos clásicos radica, así, en la obtención del kernel \(K\): en filtros tradicionales, sus coeficientes se definen manualmente para resaltar características específicas de la imagen; en las CNNs, los coeficientes se inicializan automáticamente y se ajustan durante el entrenamiento mediante la retropropagación del error (backpropagation), lo que hace que cada filtro se especialice en identificar patrones relevantes para la tarea en estudio.

Dos conceptos caracterizan esta capa:

  • Compartición de pesos (weight sharing): el mismo filtro se aplica en todas las posiciones de la imagen, reduciendo significativamente el número de parámetros del modelo.
  • Campo receptivo (receptive field): cada neurona convolucional procesa solo una pequeña vecindad de la imagen, preservando la estructura espacial de los datos.

Al apilar varias capas convolucionales, la red aprende una jerarquía de características: las primeras capas tienden a detectar patrones simples, como bordes y texturas, y las capas más profundas combinan esta información para representar estructuras progresivamente más complejas. Tras la convolución, el mapa de características se somete a una función de activación, introduciendo no linealidad en el modelo y ampliando su capacidad para representar relaciones complejas entre las variables de entrada.

La Figura 9.4 presenta esta capa de forma interactiva.

⚙️ Simulador: Operação de Convolução & Mapa de Características F(i,j) = f(∑ K(u,v) · I(i+u, j+v))
IMAGEM DE ENTRADA
KERNEL (FILTRO FIXO)
Zero-Padding (p = 1)
pixel real margem fixa da imagem (0) padding do algoritmo (0)
O mesmo kernel desliza sobre toda a imagem reutilizando seus coeficientes (compartilhamento de pesos). Cada imagem já vem cercada por uma margem fixa de 1 pixel de fundo (zeros, contorno tracejado âmbar), isolando a forma nos quatro lados. Escolha uma imagem e um kernel fixo acima, depois use ◀ ▶ ou "Auto" para percorrer o campo receptivo — o Feature Map à direita é preenchido célula a célula, na mesma ordem em que a convolução é calculada (as células ainda não visitadas aparecem como "···").
📌 A saída F(i,j) vem do campo receptivo entre (i,j) e (i+2,j+2); seu centro real é (i+1,j+1) — 1 linha e 1 coluna abaixo/à direita do índice usado para rotular a célula, sempre nas duas direções. Esse deslocamento só fica visível no eixo em que o kernel diferencia a imagem (por isso o Sobel V parece deslocar só para o lado, e o Sobel H, só para baixo).
Ativação em f(z)
🔍 Cálculo Detalhado no Campo Receptivo Atual
z = 0.00 → y = ReLU(z) = 0.00
Figura 9.4: Simulador interativo da Camada Convolucional: escolha entre três imagens de entrada 12×12 (casa, rosto feliz ou rosto triste) para observar como os mesmos kernels fixos reagem a diferentes bordas e formas. Navegue pelo campo receptivo com os botões ou reprodução automática, ajuste a função de ativação e alterne o zero-padding, acompanhando o mapa de características sendo revelado célula a célula, com o cálculo detalhado termo a termo e a fórmula da dimensão de saída em tempo real.

9.4.4 Función de Activación

La convolución es una operación lineal. Para que la red pueda modelar relaciones no lineales entre entradas y salidas, se aplica una función de activación (activation function) tras cada capa convolucional.

La función más utilizada en CNNs es la ReLU (Rectified Linear Unit), definida por

\[ \mathrm{ReLU}(x)=\max(0,x). \]

Esta función preserva los valores positivos y reemplaza por cero los valores negativos, introduciendo no linealidad en el modelo y favoreciendo el entrenamiento de redes profundas con bajo costo computacional.

La Figura 9.5 ilustra el funcionamiento de la ReLU aplicada tanto a valores individuales como a un mapa de características, permitiendo comparar la salida antes y después de la activación.

⚡ Simulador: Función de Activación ReLU ReLU(x) = max(0, x)
x = x = -2.50 → ReLU(x) = 0.00
Curva de la función ReLU
Mapa de características: antes / después
Figura 9.5: Simulador interactivo de la función de activación ReLU: arrastre el control para ver cómo los valores negativos se ponen a cero y los valores positivos se conservan, tanto en la curva como en un mapa de características real.

Los mapas de características resultantes de la convolución y de la activación preservan la estructura espacial de la imagen. En muchas arquitecturas, la etapa siguiente reduce su resolución mediante una operación de pooling.

9.4.5 Pooling

La capa de pooling reduce la resolución espacial de los mapas de características, preservando la información más relevante para las etapas siguientes del procesamiento. La operación más utilizada es el max-pooling, que selecciona el mayor valor en cada ventana de la imagen:

\[ P(i,j)=\max_{(u,v)\in\text{janela}(i,j)}F(u,v). \]

Esta reducción disminuye el costo computacional de las capas subsiguientes y hace que la representación sea más robusta ante pequeñas variaciones en la posición de los patrones presentes en la imagen.

La Figura 9.6 presenta esta operación sobre un mapa de características de 8×8 píxeles, reducido a 4×4 mediante ventanas de 2×2 con paso igual a 2, alternando entre max-pooling y average-pooling — que calcula, en lugar del máximo, el promedio de los valores de la ventana correspondiente.

🔻 Simulador: Pooling ventana 2×2, stride 2
Tipo:
Ventana actual: (0, 0) de 4×4
O max-pooling mantiene solo el valor más grande de cada ventana 2×2, reduciendo la resolución espacial a la mitad y preservando las respuestas más fuertes del mapa de características.
Mapa de entrada (8×8) — ventana actual resaltada
Mapa reducido (4×4)
Figura 9.6: Simulador interactivo de pooling: elija entre max-pooling y average-pooling y avance paso a paso para observar la reducción de la resolución espacial del mapa de características.

En conjunto, convolución, función de activación y pooling forman el bloque básico utilizado en la construcción de una CNN.

9.4.6 Entrenamiento de Redes Neuronales: Cómo Aprenden las CNNs

Una CNN aprende ajustando automáticamente sus parámetros — los coeficientes de los filtros convolucionales, los pesos de las capas totalmente conectadas y los sesgos (biases) — a partir de ejemplos etiquetados. Este entrenamiento es iterativo e involucra tres etapas: medir el error producido por la red mediante una función de pérdida (loss function), calcular cómo depende ese error de cada parámetro mediante la retropropagación (backpropagation) y actualizar los parámetros con un algoritmo de optimización (optimizer).

9.4.6.1 Función de Pérdida (Loss Function)

La función de pérdida (loss function) cuantifica la diferencia entre la predicción de la red y la respuesta correcta, denominada verdad de referencia (ground truth). El resultado es un escalar \(L\): cuanto menor es la pérdida, más cercana está la predicción a la respuesta esperada.

En problemas de clasificación multiclase, la función más utilizada es la Entropía Cruzada (Cross-Entropy Loss), aplicada a las probabilidades producidas por la capa Softmax:

\[ L=-\sum_{c=1}^{C} y_c \log(\hat{y}_c), \]

donde \(C\) es el número de clases, \(y_c\) es la etiqueta real en codificación one-hot y \(\hat{y}_c\) es la probabilidad prevista para la clase \(c\). La pérdida se aproxima a cero cuando la red asigna alta probabilidad a la clase correcta y crece rápidamente a medida que esa probabilidad disminuye.

La Figura 9.7 ilustra este comportamiento: el simulador permite seleccionar la clase correcta y alterar las probabilidades producidas por la Softmax, mostrando en tiempo real la variación de la función de pérdida.

📉 Simulador: Función de Pérdida (Entropía Cruzada) L = -log(ŷ_alvo)
CLASE REAL DE LA IMAGEN (GROUND TRUTH: y_c = 1)
PROBABILIDADES ESTIMADAS POR LA SOFTMAX (ŷ_c)
🏠 Casa (ŷ_1): 0.70
😊 Feliz (ŷ_2): 0.20
😢 Triste (ŷ_3): 0.10
Curva de Penalización L = -log(ŷ_alvo)
CÁLCULO DE LA PÉRDIDA:
Pérdida L = 0.3567
Figura 9.7: Simulador interactivo de la Función de Pérdida (Cross-Entropy): seleccione la clase real de la imagen (Casa, Feliz o Triste) y ajuste las probabilidades estimadas por la Softmax para visualizar el cálculo de la penalización escalar y el gráfico del logaritmo negativo en tiempo real.

9.4.6.2 Retropropagación (Backpropagation)

Tras el cálculo de la pérdida, es necesario determinar cómo contribuye cada parámetro de la red a dicho resultado. Esta etapa se lleva a cabo mediante la retropropagación (backpropagation), que aplica la Regla de la Cadena del cálculo diferencial para obtener el gradiente de la función de pérdida con respecto a cada parámetro.

Para un parámetro \(w\), este gradiente se expresa como

\[ \frac{\partial L}{\partial w}. \]

El gradiente indica cómo varía la pérdida ante pequeños cambios en \(w\): un gradiente positivo señala que aumentar \(w\) incrementa la pérdida, mientras que un gradiente negativo refleja el efecto opuesto.

La Figura 9.8 presenta este proceso de forma visual, mostrando la propagación del gradiente desde la capa de salida hasta las primeras capas convolucionales.

⬅️ Simulador: Retropropagación (Backpropagation) ∂L/∂w = (∂L/∂y) · (∂y/∂z) · (∂z/∂w)
Paso 1 de 4: Salida (Loss & Softmax)
DIRECCIÓN DE LA PROPAGACIÓN DEL ERROR (FLUJO INVERSO ⟵)
Conv1 Kernels
∂L/∂K
⟵
Max-Pooling
∂L/∂X_pool
⟵
Capas FC
∂L/∂W_fc
⟵
Loss / Softmax
∂L/∂y_pred
🔗 Regla de la Cadena en la Capa Actual:
Figura 9.8: Simulador interactivo de Backpropagation: avance los pasos de la Regla de la Cadena para acompañar el flujo de la señal de error en el sentido inverso de la red, observando el cálculo de las derivadas parciales del gradiente en cada capa.

9.4.6.3 Algoritmos de Optimización

Tras el cálculo de los gradientes, un algoritmo de optimización (optimizer) actualiza los parámetros de la red para reducir la función de pérdida. En redes profundas, esta búsqueda ocurre en un espacio de alta dimensión y, en general, no convexo, lo que convierte la optimización en un problema desafiante.

Para facilitar la comprensión, la Figura 9.9 utiliza una superficie de pérdida simplificada, con un mínimo global, un mínimo local y una barrera entre estas regiones. El mínimo global corresponde al menor valor de la función de pérdida y representa el mejor conjunto de parámetros de la red; un mínimo local también presenta baja pérdida, pero puede estar lejos de la mejor solución. Cuando la optimización queda atrapada en un mínimo local, los ajustes de filtros, pesos y sesgos se vuelven muy pequeños, y el entrenamiento se detiene antes de alcanzar un modelo con menor error.

9.4.6.3.1 Descenso de Gradiente Estocástico (SGD)

El Descenso de Gradiente Estocástico (Stochastic Gradient Descent — SGD) actualiza los parámetros en la dirección opuesta al gradiente:

\[ w_{\text{novo}} = w_{\text{atual}} - \eta \frac{\partial L}{\partial w}, \]

donde \(\eta\) es la tasa de aprendizaje (learning rate), responsable de controlar el tamaño de la actualización. El SGD utiliza únicamente el gradiente de la iteración actual; cuando la búsqueda alcanza un mínimo local, los gradientes se vuelven muy pequeños y las actualizaciones prácticamente cesan.

9.4.6.3.2 Optimizadores Adaptativos: Adam

El Adam (Adaptive Moment Estimation) combina estimaciones adaptativas de los primeros y segundos momentos de los gradientes (KINGMA, 2015), adaptando la tasa de aprendizaje de cada parámetro individualmente. Esta adaptación favorece, en muchos casos, la superación de mínimos locales que retendrían al SGD.

La Figura 9.9 compara la trayectoria del SGD y del Adam sobre la misma superficie de pérdida no convexa.

⚡ Simulador: Optimización con Curvas de Nivel (SGD vs. Adam) Relieve No Convexo: Mínimo Local vs. Global
💡 Cómo leer este mapa: a flecha amarilla apunta en la dirección de descenso (−∇L), que es el sentido opuesto al vector gradiente (∇L). El optimizador avanza en esa dirección para reducir la pérdida L(w1, w2) hasta alcanzar las regiones más profundas (tonos más oscuros).
ALGORITMO PRINCIPAL (línea sólida)
TASA DE APRENDIZAJE (η)
Mapa de Calor de la Pérdida L(w₁, w₂) — clic para elegir el inicio
Mínimo Global Mínimo Local Gradiente (↓ descenso) Trayectoria principal Fantasma (otro optimizador)
ESTADO DE LA OPTIMIZACIÓN:
w₁ = 1.80, w₂ = 0.20
Pérdida L = 2.450
PASO
0
|∇L| (MAGNITUD)
0.000
Estado: Punto Inicial
Figura 9.9: Simulador interactivo de los Algoritmos de Optimización: compare la trayectoria del SGD y del Adam sobre una superficie de pérdida no convexa con mapa de calor y curvas de nivel. La línea sólida muestra el optimizador seleccionado avanzando paso a paso; la línea discontinua muestra, para comparación instantánea, el camino completo que el otro optimizador recorrería desde el mismo punto inicial. Observe cómo el SGD queda atrapado en el Mínimo Local a la derecha, mientras que el Adam puede o no cruzar la barrera central dependiendo del impulso acumulado y de la tasa de aprendizaje. Haga clic en cualquier punto del mapa para restablecer el punto inicial de los pesos.

9.4.7 Arquitectura de una CNN

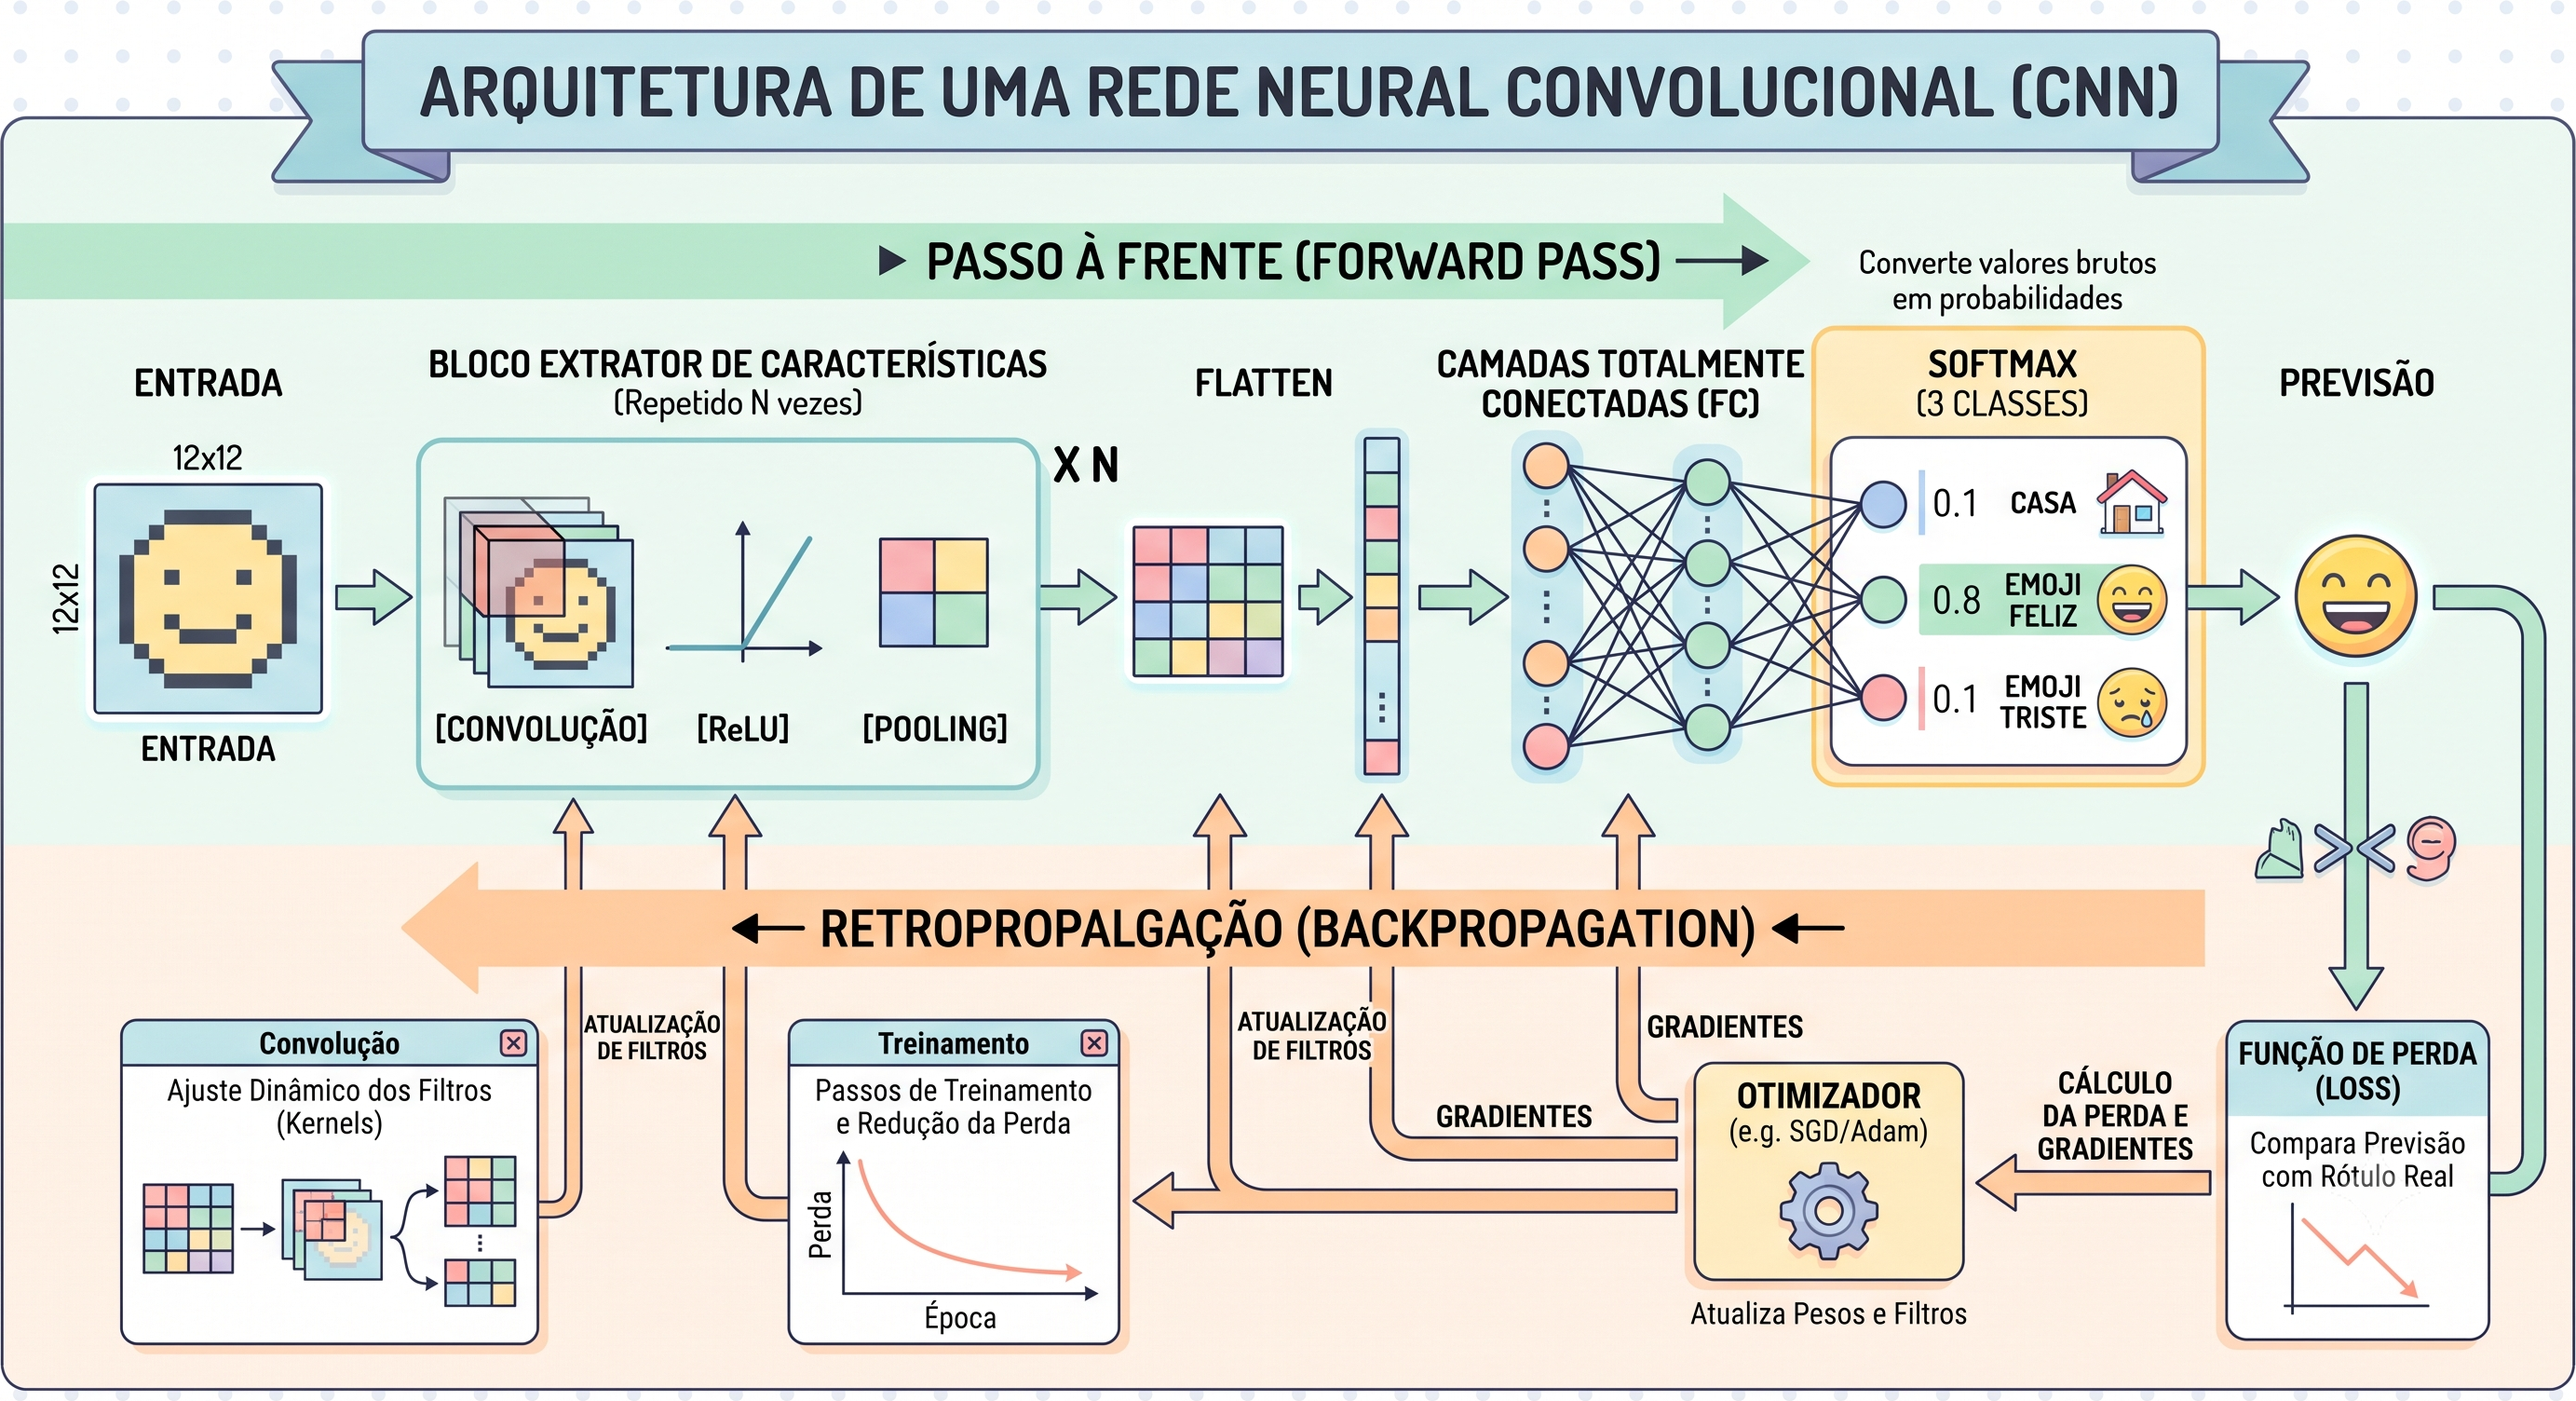
Una CNN para clasificación de imágenes combina las capas presentadas en las secciones anteriores. Durante el paso hacia adelante (forward pass), la imagen recorre sucesivamente las capas convolucionales, las funciones de activación, las operaciones de pooling, la etapa de Flatten, las capas totalmente conectadas y, por último, la capa Softmax, que produce las probabilidades de las clases. Durante el entrenamiento, esta predicción se compara con la etiqueta correcta para calcular la función de pérdida, realizar la retropropagación y actualizar los parámetros mediante un algoritmo de optimización.

La Figura 9.10 presenta este flujo de procesamiento y entrenamiento.

Figura 9.10: Arquitectura simplificada de una CNN para clasificación de imágenes, destacando el forward pass y las etapas de entrenamiento mediante la función de pérdida, la retropropagación y el algoritmo de optimización.

Después del último bloque convolucional, la operación Flatten reorganiza los mapas de características en un vector unidimensional, que alimenta las capas totalmente conectadas (fully connected layers), responsables de combinar las características extraídas para producir los puntajes (logits) de cada clase. La capa Softmax convierte estos puntajes en una distribución de probabilidades, utilizada tanto para la clasificación como para el cálculo de la función de pérdida durante el entrenamiento.

La Figura 9.11 presenta una versión interactiva de esta arquitectura, permitiendo ejecutar sucesivas etapas de entrenamiento y observar la reducción de la pérdida, la retropropagación de los gradientes y la actualización de los filtros de la red.

⚙️ Simulador: Arquitectura Completa de una CNN Entrada (12×12) → Conv → Pool → FC → Softmax
IMAGEN DE ENTRADA DEL PIPELINE (12×12)
🎯 Entrenamiento (Forward Pass + Retropropagación)
Entrada ▸ Conv+ReLU ▸ Pool ▸ Flatten ▸ FC ▸ Softmax ▸ Predicción
Pérdida ◂ Optimizador ◂ Retropropagación ◂ (en cada paso)
PÉRDIDA (LOSS)
EXACTITUD
Loss: —
Exactitud: —
Paso de entrenamiento: 0
Los kernels y pesos comienzan aleatorios (ya no son los filtros fijos del simulador anterior). En cada paso, la red hace el forward pass en las 3 imágenes, calcula la pérdida (cross-entropy) e a exactitud (cuántas de las 3 imágenes se clasifican correctamente), retropropaga el error y ajusta todos los pesos (incluidos los kernels de la convolución) mediante descenso de gradiente. ⚠️ Como el "conjunto de entrenamiento" tiene solo 3 ejemplos, esto demuestra el mecanismo del entrenamiento (pérdida cayendo, exactitud subiendo, pesos cambiando) — no la capacidad de generalizar a imágenes nuevas, que exigiría muchos más datos.
Figura 9.11: Simulador interactivo de la arquitectura de una CNN: elige una de las imágenes de entrada 12×12 (casa, rostro feliz o triste), haz clic en cada bloque del pipeline — Entrada, Conv+ReLU, Pooling, Flatten, FC y Softmax — y ejecuta pasos de entrenamiento reales (forward pass + retropropagación) para observar la pérdida y la precisión evolucionando, los kernels siendo ajustados y el Softmax empezando a apuntar a la clase correcta.

9.4.8 Cómo el Gradiente Ajusta los Kernels de la Convolución

La comprensión del proceso de aprendizaje en una Red Neuronal Convolucional (CNN) requiere la elucidación de un mecanismo fundamental: cómo los coeficientes aleatorios de un filtro inicial se transforman en detectores precisos de bordes, texturas y patrones complejos.

La respuesta reside en el principio del compartimiento de pesos (weight sharing). Durante la etapa de propagación hacia adelante (forward pass), el mismo filtro de dimensión \(3\times3\) se desliza por toda la extensión de la imagen de entrada. En consecuencia, cada peso del kernel — como el elemento \(K[0][0]\) en la esquina superior izquierda — se reutiliza múltiples veces a lo largo de las diferentes regiones espaciales del dato de entrada.

Durante la etapa de retropropagación (backpropagation), esa reutilización establece una dinámica directa: cada posición espacial procesada por el filtro genera una contribución individual (“voto”) para la actualización del respectivo peso.

9.4.8.1 La Intuición Detrás del Cálculo

Sea \(Z[r][c]\) el mapa de características preactivación en la posición \((r,c)\) de la ventana deslizante, obtenido mediante la correlación cruzada entre el kernel \(K\) y la entrada \(X\):

\[ Z[r][c] = \sum_{k_r} \sum_{k_c} K[k_r][k_c] \cdot X[r + k_r][c + k_c] \]

Aplicando la regla de la cadena para determinar la contribución de un peso específico \(K[k_r][k_c]\) en la función de pérdida \(L\), se obtienen las siguientes etapas:

  1. Error Local (\(dZ\)): En cada posición \((r,c)\), se calcula la derivada parcial de la función de pérdida con respecto a la preactivación: \[dZ[r][c] = \frac{\partial L}{\partial Z[r][c]}\] que cuantifica la responsabilidad de esa posición específica en el error total de la red (\(L\)).

  2. Contribución del Peso: Como \(\frac{\partial Z[r][c]}{\partial K[k_r][k_c]} = X[r + k_r][c + k_c]\), la influencia de un peso específico \(K[k_r][k_c]\) en el error de la posición \((r,c)\) se obtiene multiplicando el error local \(dZ[r][c]\) por el valor del píxel de entrada alineado con ese peso en el instante del cálculo: \[dZ[r][c] \cdot X[r + k_r][c + k_c]\]

  3. Acumulación de Gradientes: El gradiente final del peso corresponde a la suma de las contribuciones (“votos”) de todas las posiciones recorridas por la ventana deslizante:

\[ \frac{\partial L}{\partial K[k_r][k_c]} = \sum_{(r,c)} dZ[r][c] \cdot X[r + k_r][c + k_c] \]

Esta formulación asegura paridad directa entre la derivación analítica y los valores computados en el simulador de inspección del gradiente (Figura 9.12).

9.4.8.2 El Papel de la Función ReLU como “Filtro de Relevancia”

La aplicación de la función de activación ReLU (\(\max(0, z)\)) inmediatamente después de la convolución introduce una propiedad de selectividad al gradiente:

  • Activación Positiva (\(Z[r][c] > 0\)): La derivada de la ReLU es \(1\). El error local se propaga integralmente (\(dZ \neq 0\)), permitiendo que la posición contribuya a la actualización de los pesos del kernel.
  • Activación Inactiva (\(Z[r][c] \le 0\)): La derivada de la ReLU es \(0\). El error local se anula (\(dZ = 0\)), suprimiendo la contribución de la posición al gradiente final.

Nota didáctica: La ReLU asegura que solo las regiones espaciales que produjeron respuestas activas durante la propagación hacia adelante posean capacidad de modificar los pesos del kernel en el proceso de retropropagación.

9.4.8.3 Actualización de los Pesos mediante Descenso de Gradiente

Tras la consolidación de los gradientes acumulados de todas las posiciones, la actualización del peso ocurre según el algoritmo del Descenso de Gradiente Estocástico (SGD):

\[ K[k_r][k_c] \leftarrow K[k_r][k_c] - \eta \cdot \frac{\partial L}{\partial K[k_r][k_c]} \]

donde \(\eta\) denota la tasa de aprendizaje (learning rate).

  • Si la suma de los gradientes es positiva, el valor del peso se reduce.
  • Si la suma es negativa, el valor del peso se incrementa.

9.4.8.4 Explorando el Simulador Interactivo

Nota🔗 De la Arquitectura Global a la Inspección del Gradiente

En el simulador de arquitectura (Figura 9.11), se observa el error \(dZ\) derivado de la retropropagación multicapa completa, originado en la pérdida de entropía cruzada (Softmax) sobre las imágenes de entrada \(12\times12\).

Para viabilizar la verificación analítica del gradiente sin la sobrecarga de \(100\) posiciones de convolución y retropropagación multicapa, el simulador de aprendizaje del kernel (Figura 9.12) adopta un modelo de inspección reducido (\(6\times6\)). En ese escenario, se simplifica el problema sustituyendo la clasificación compleja por un metadato de calibración escalar: se ajusta el filtro para producir una respuesta acumulada predefinida (\(\text{alvo} = 9\)) al identificar un patrón específico (como un borde a 45 grados). El mecanismo de acumulación de gradientes (\(dZ \cdot X\)) permanece rigurosamente idéntico en ambas formulaciones.

Para inspeccionar esta dinámica a nivel numérico, se utiliza el simulador en la Figura 9.12:

  • Imagen de Entrada (\(X\)): Matriz \(6\times6\).
  • Filtro Convolucional (\(K\)): Matriz \(3\times3\) (9 pesos).
  • Mapa de Salida (\(Z\) / \(A\)): Matriz \(4\times4\) (16 posiciones de la ventana).
  • Función de Pérdida (\(L\)): Definida por \(L = \frac{1}{2}(S - \text{alvo})^2\), donde \(S = \sum A[r][c]\) representa la suma global de las activaciones post-ReLU.

El papel del \(\text{alvo} = 9\): El valor escalar \(\text{alvo} = 9\) representa la “energía de activación” ideal estipulada para la imagen con borde diagonal. Como el mapa \(A\) posee 16 posiciones, ese valor equivale a buscar una respuesta media de \(\frac{9}{16} \approx 0,56\) por píxel activado. Cuando \(S > 9\), la red identifica que el filtro está reaccionando con intensidad excesiva al patrón, generando un error \(dZ > 0\) que fuerza la reducción de los pesos \(K\). Cuando \(S < 9\), los pesos se incrementan para amplificar la señal.

9.4.8.4.1 Ruta Sugerida de Experimentación:
  1. Selección de Peso: En la cuadrícula \(3\times3\), elija el peso a analizar (ej.: \(K[0][0]\)).
  2. Barrido de la Ventana: Utilice el botón “▶ Avanzar posición” para acompañar el desplazamiento de la ventana por las 16 posiciones espaciales. Note el resaltado visual en la celda del mapa de entrada que alinea el píxel \(X\) con el peso seleccionado.
  3. Análisis del Voto Local: Examine el producto del error local por el píxel de entrada (\(dZ \cdot X\)) en el panel de cálculo de la posición.
  4. Verificación del Historial: Acompañe la consolidación de los 16 resultados parciales organizados en las cuatro columnas de historial, observando la acumulación del gradiente final.
  5. Actualización del Kernel: Haga clic en “▶ Aplicar paso de descenso de gradiente” para visualizar la convergencia de la curva de pérdida y la adaptación del kernel aleatorio al patrón de entrada seleccionado.
🧮 Simulador: Gradiente de un Peso del Kernel ∂Pérdida / ∂K[kr][kc] = Σ dZ · X
PATRÓN DE ENTRADA (IMAGEN 6×6)? Elige qué imagen 6×6 alimenta la convolución.
TASA DE APRENDIZAJE (η)? Tasa de aprendizaje. Ajusta para ver la diferencia entre convergencia suave (0.002) y colapso por overshooting (0.02).
Ejemplo reducido: imagen 6×6 y filtro 3×3 generando mapas 4×4. Haz clic en las pestañas "🔍 ¿Cómo se calcula?" debajo de cada matriz para entender los cálculos paso a paso. Pasa el mouse sobre cualquier celda de X, Z, A, dZ o K para ver el cálculo exacto de ese valor, con los elementos usados en las capas relacionadas resaltados con contorno discontinuo/azul.
1. PESO DEL KERNEL? Selecciona qué peso del kernel deseas analizar individualmente.
KERNEL ACTUAL (K)? Valores del filtro 3×3. El peso seleccionado está resaltado en azul. Pasa el mouse sobre un peso para ver dónde se usa.
🔍 ¿Cómo se actualiza?
Regla del Gradiente:
K ← K − η · ∇K
• η = tasa de aprendizaje.
• ∇K = suma de los 16 votos dZ × X.
ENTRADA X (6×6)? Imagen 6×6. Píxel azul = superposición con el peso K seleccionado en la ventana actual. Pasa el mouse sobre un píxel para ver en qué posiciones de Z se usa.
🔍 ¿Cómo funciona X?
Matriz de entrada. En la posición (r,c), el peso K multiplica el píxel:
X[r + kr][c + kc]
PRE-ACTIVACIÓN Z (4×4)? Resultado de la convolución antes del ReLU: Z = Σ K · X. Pasa el mouse sobre una celda para ver los 9 términos de la suma, resaltando la ventana en X y todo el kernel K.
🔍 ¿Cómo calcula Z?
Correlación cruzada:
Multiplicación punto a punto del filtro 3×3 sobre X:
Z[r][c] = Σ K · X
ACTIVACIÓN A (4×4)? Resultado post-ReLU: A = max(0, Z). Si Z ≤ 0, la activación se anula. Pasa el mouse sobre una celda para resaltar el Z correspondiente.
🔍 ¿Cómo calcula A?
Función ReLU:
A[r][c] = max(0, Z[r][c])
Suma Global (S):
S = Σ A[r][c]
ERROR dZ (4×4)? Error propagado: dZ = (S - objetivo) · I(Z > 0). Donde A=0, el error dZ también es 0. Pasa el mouse sobre una celda para ver el cálculo completo, resaltando el Z correspondiente y todas las 16 celdas de A que forman S.
🔍 ¿Cómo calcula dZ, S y Loss?
1. Pérdida (Loss L):
L = ½ (S − objetivo)²
2. Error propagado dZ:
dZ = (S − objetivo) · deriv_ReLU(Z)
2. CÁLCULO Y SUMA DE LOS "VOTOS" DE CADA POSICIÓN? Cada posición (r,c) genera un voto = dZ[r][c] × X[r+kr][c+kc]. La suma de todos los 16 votos forma el gradiente del peso.
CÁLCULO DE ESTA POSICIÓN? Muestra el error local (dZ) y el píxel de entrada (X) multiplicados en la posición actual de la ventana deslizante.
SUMA ACUMULADA (GRADIENTE)? El valor acumulado de los productos dZ × X de todas las posiciones ya recorridas. Cuando llega a 16/16, este es el gradiente final del peso.
HISTORIAL DE LAS 16 POSICIONES (COLUMNAS c=0, c=1, c=2, c=3)? Sigue la lista de todas las 16 posiciones organizadas en 4 columnas para corresponder al movimiento de la ventana sobre la imagen de salida.
3. USA EL GRADIENTE PARA ACTUALIZAR EL KERNEL? Aplica la regla del Descenso de Gradiente (K ← K − η · gradiente) para todos los 9 pesos.
PÉRDIDA A LO LARGO DE LAS ACTUALIZACIONES? Evolución del error L = ½(S − objetivo)²:
• Objetivo: L → 0 (S → objetivo).
• Si se bloquea en L = 40.5: Ocurrió "overshooting" (salto exagerado). Los pesos quedaron muy negativos, generando Z ≤ 0 (muerte de la ReLU). Con S = 0, la pérdida se bloquea en ½(0 − 9)² = 40.5.
Figura 9.12: Simulador interactivo del cálculo del gradiente de un peso del kernel convolucional.
Nota🧠 Síntesis — De la convolución al aprendizaje de representaciones

Los simuladores de esta sección demuestran, de forma secuencial, cómo una CNN transforma una imagen de entrada en una estimación probabilística y cómo se optimizan sus parámetros durante el entrenamiento:

  • Convolución: aplica filtros sobre la imagen para extraer características locales, generando mapas de características mediante el uso compartido de pesos.
  • ReLU: introduce no linealidad al sistema, permitiendo el modelado de relaciones complejas entre los datos.
  • Pooling: reduce la resolución espacial de los mapas de características, disminuyendo el costo computacional y otorgando invariancia a pequeñas traslaciones locales.
  • Flatten: reorganiza los mapas multidimensionales en un vector unidimensional para alimentar las capas subsiguientes.
  • Capa totalmente conectada: combina las características extraídas para producir las puntuaciones brutas (logits) asociadas a cada clase.
  • Softmax: convierte los logits en una distribución de probabilidades normalizada.
  • Función de pérdida: compara la distribución prevista con la verdad de referencia (ground truth), cuantificando escalarmente el error de la red.
  • Retropropagación: aplica la regla de la cadena para calcular la derivada parcial (gradiente) de la función de pérdida con respecto a cada parámetro entrenable.
  • Optimizador: actualiza los coeficientes de los filtros, pesos y sesgos en la dirección opuesta al gradiente, reduciendo la pérdida en cada iteración.

A lo largo de las iteraciones, los filtros convolucionales se convierten de valores estocásticos en detectores especializados: las capas iniciales aprenden primitivas visuales de bajo nivel (como bordes y texturas), mientras que las capas más profundas consolidan estas representaciones en estructuras abstractas y semánticas.

9.5 Aplicaciones Prácticas en VC

Tras la consolidación teórica de los fundamentos de las CNNs y la verificación visual de cada una de sus operaciones elementales mediante los simuladores interactivos, resulta esencial observar la integración de estas etapas en pipelines completos de programación.

En las secciones siguientes, la teoría se traduce en código ejecutable en PyTorch, explorando las tres tareas fundamentales de la VC: clasificación, detección de objetos y segmentación semántica. Esta progresión práctica permite analizar desde la construcción de una arquitectura convolucional entrenada desde cero hasta la aplicación de estrategias avanzadas de transferencia de aprendizaje (transfer learning) en modelos preentrenados para conjuntos de datos sintéticos y reales.

9.5.1 Clasificación de Imágenes con CNNs

La clasificación de imágenes es una de las aplicaciones más tradicionales de las CNNs. En esta tarea, el objetivo es asignar una única etiqueta a la imagen de entrada, como identificar una categoría de objeto, una especie de animal o una clase de diagnóstico. Para ello, la CNN transforma progresivamente los valores de los píxeles en representaciones de mayor nivel de abstracción, combinando capas convolucionales, funciones de activación y operaciones de reducción espacial hasta producir una distribución de probabilidades entre las clases posibles. En esta sección, se presentan la arquitectura básica de una CNN clasificadora, el flujo de transformación de los datos a lo largo de la red y el proceso de entrenamiento para el ajuste de los parámetros aprendidos.

9.5.1.1 Entrenamiento de una CNN desde Cero en Dígitos

Para establecer una comparación directa con los enfoques presentados en el Capítulo 7, se desarrolla en esta sección una CNN entrenada sobre el mismo conjunto de datos de dígitos manuscritos (load_digits). La diferencia fundamental reside en la etapa de representación: mientras que los métodos clásicos dependen de píxeles brutos o de descriptores calculados manualmente, como el Histogram of Oriented Gradients (HOG), la CNN aprende automáticamente los coeficientes de los filtros convolucionales durante el proceso de optimización.

Los códigos siguientes (consolidados en la Figura 9.15) realizan la preparación de los datos, definen una arquitectura convolucional simple en PyTorch, ejecutan el bucle de entrenamiento mediante el algoritmo Adam y generan las curvas de evolución de la función de pérdida y de la precisión.

9.5.1.1.1 Bloque 1: Preparación y Estructuración de los Datos

La etapa inicial de cualquier pipeline de Aprendizaje Profundo consiste en la conversión y adecuación de los datos de entrada al formato exigido por el framework de computación científica.

9.5.1.1.1.1 El Concepto de Tensor

En Aprendizaje Profundo, la estructura fundamental de datos es el tensor. Desde el punto de vista computacional, un tensor consiste en un arreglo multidimensional de números generalizado para \(n\) dimensiones:

  • Un tensor de orden 0 es un escalar (un único valor).
  • Un tensor de orden 1 es un vector (longitud).
  • Un tensor de orden 2 es una matriz (filas y columnas).
  • Un tensor de orden 3 o superior representa un volumen o hiper-arreglo de datos.

En el contexto de PyTorch, la clase torch.Tensor extiende la funcionalidad de los arreglos numéricos multidimensionales (como los de NumPy) al ofrecer soporte para operaciones aceleradas en hardware mediante GPUs (Graphics Processing Units) y soporte para el cálculo automático de derivadas (autograd), esencial para el algoritmo de retropropagación.

9.5.1.1.1.2 Análisis del Código de Preprocesamiento
  1. Carga y Normalización de las Intensidades: El conjunto load_digits posee \(1.797\) muestras de dígitos manuscritos de \(8 \times 8\) píxeles, cuyas intensidades originales varían en la escala entera de \(0\) a \(16\). La división por \(16.0\) realiza la normalización de los datos al rango \([0.0, 1.0]\). Esta transformación a escala flotante (float32) es indispensable en redes neuronales para evitar la saturación de las funciones de activación y estabilizar el cálculo de los gradientes en el algoritmo de optimización.

  2. División Estratificada (70% Entrenamiento / 30% Prueba): La función train_test_split separa el \(70\%\) de las muestras para el ajuste de los parámetros de la red y reserva el \(30\%\) para la evaluación del modelo en datos no vistos. El parámetro stratify=y garantiza el muestreo estratificado, manteniendo la proporción exacta de cada una de las 10 clases de dígitos (\(0\) a \(9\)) en ambos conjuntos, previniendo sesgos de distribución.

  3. Adecuación Dimensional para Convolución 2D (unsqueeze): En las CNN, las capas convolucionales bidimensionales (nn.Conv2d) exigen que el tensor de entrada posea estrictamente 4 dimensiones en el orden \((N, C, H, W)\):

    • \(N\): número de muestras (batch size).
    • \(C\): número de canales de color (\(1\) para escala de grises, \(3\) para RGB).
    • \(H\): altura de la imagen en píxeles (\(8\)).
    • \(W\): ancho de la imagen en píxeles (\(8\)).

    Como el arreglo original posee un formato \(3\text{D}\) del tipo \((N, 8, 8)\), la llamada .unsqueeze(1) inserta una dimensión unitaria específicamente en el índice 1 (la posición reservada para el canal de color \(C\)), transformando la estructura en un tensor \(4\text{D}\) de formato \((N, 1, 8, 8)\), conforme lo exige PyTorch.

  4. Conversión de las Etiquetas (dtype=torch.long): Las etiquetas de las clases \(y\) se convierten en tensors enteros de 64 bits (torch.long). Esta especificación de tipo es un requisito de la función de pérdida de Entropía Cruzada (nn.CrossEntropyLoss), que utiliza enteros no negativos como índices para asociar la clase correcta a los logits de salida de la red.

Atención a las Dimensiones: La estructura final se representa mediante el tensor (N, 1, 8, 8), donde N es el número de muestras (batch size), 1 es el canal de color (escala de grises) y 8×8 es la resolución espacial de la imagen en píxeles.

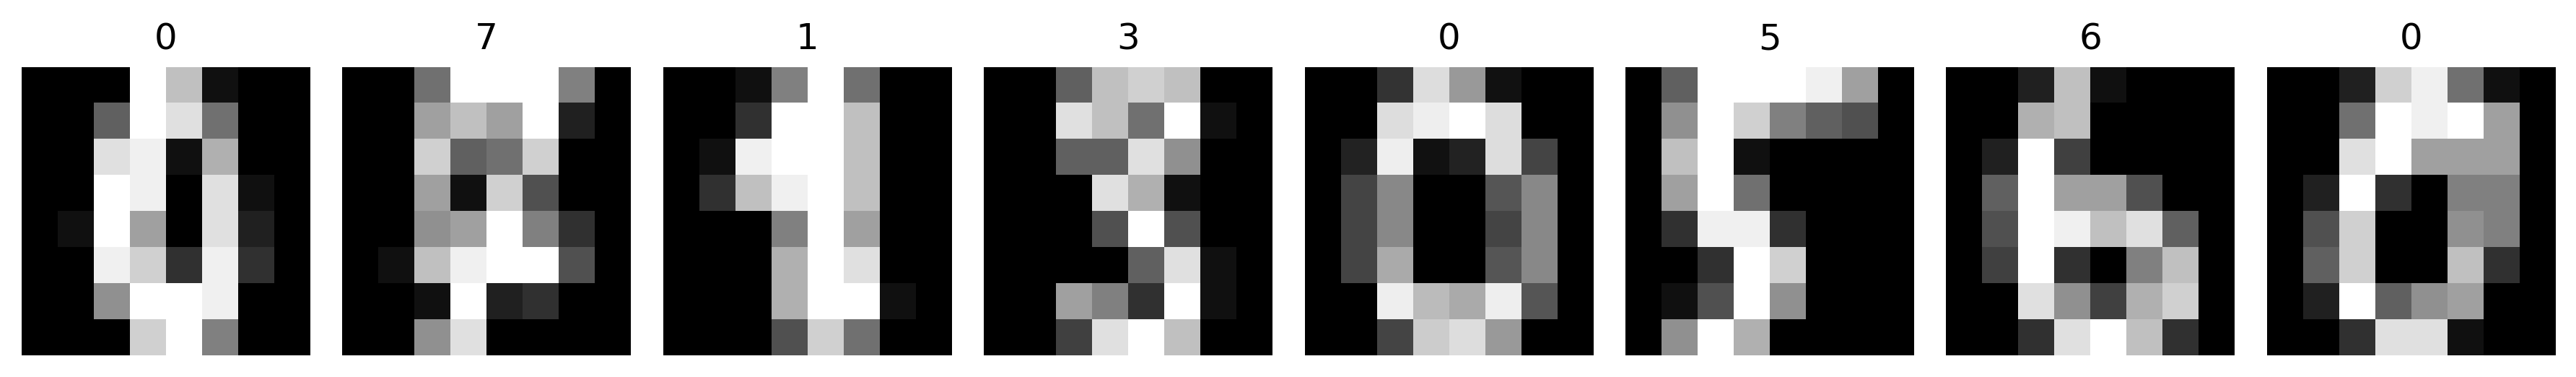
La Figura 9.13 ilustra una secuencia de muestras del conjunto de entrenamiento después del preprocesamiento y la adecuación dimensional a los tensors de PyTorch. En la etapa de visualización, la llamada img.squeeze().numpy() encadena dos transformaciones: el método .squeeze() elimina la dimensión unitaria redundante del canal de color, reduciendo el tensor \(3\text{D}\) de formato (1, 8, 8) a una matriz \(2\text{D}\) de (8, 8); a continuación, el método .numpy() convierte la estructura de PyTorch en una matriz nativa de NumPy, formato exigido por las herramientas de renderizado gráfico como mm.show().

# 1. Carga y preprocesamiento de los datos
digits = load_digits()
X = digits.images.astype(np.float32) / 16.0  # Normalización al rango [0, 1]
y = digits.target

# División estratificada en conjuntos de entrenamiento (70%) y prueba (30%)
X_treino, X_teste, y_treino, y_teste = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# Adecuación a la dimensión esperada por PyTorch: (N_muestras, Canales, Altura, Anchura)
X_treino_t = torch.tensor(X_treino).unsqueeze(1)   # Dimensión: (N, 1, 8, 8)
y_treino_t = torch.tensor(y_treino, dtype=torch.long)
X_teste_t = torch.tensor(X_teste).unsqueeze(1)
y_teste_t = torch.tensor(y_teste, dtype=torch.long)

# Mostrar una muestra
n_amostras = 8
imgs = [img.squeeze().numpy() for img in X_treino_t[:n_amostras]]
imgs_titles = [str(label.item()) for label in y_treino_t[:n_amostras]]
mm.show(imgs, titles=imgs_titles, cols=n_amostras, figsize=(12, 2.5))
Figura 9.13: Muestras de dígitos del conjunto de entrenamiento tras conversión a tensores PyTorch y normalización.
9.5.1.1.2 Bloque 2: Definición de la Arquitectura Convolucional

La construcción de modelos en PyTorch se estructura a partir del paradigma de orientación a objetos, creándose una clase específica para representar la red neuronal (en este ejemplo, la clase CNNDigitos), la cual hereda todas las funcionalidades de la clase base nn.Module. El constructor __init__ es responsable de instanciar las capas y declarar sus parámetros entrenables, mientras que el método forward establece la secuencia numérica de la propagación hacia adelante (forward pass).

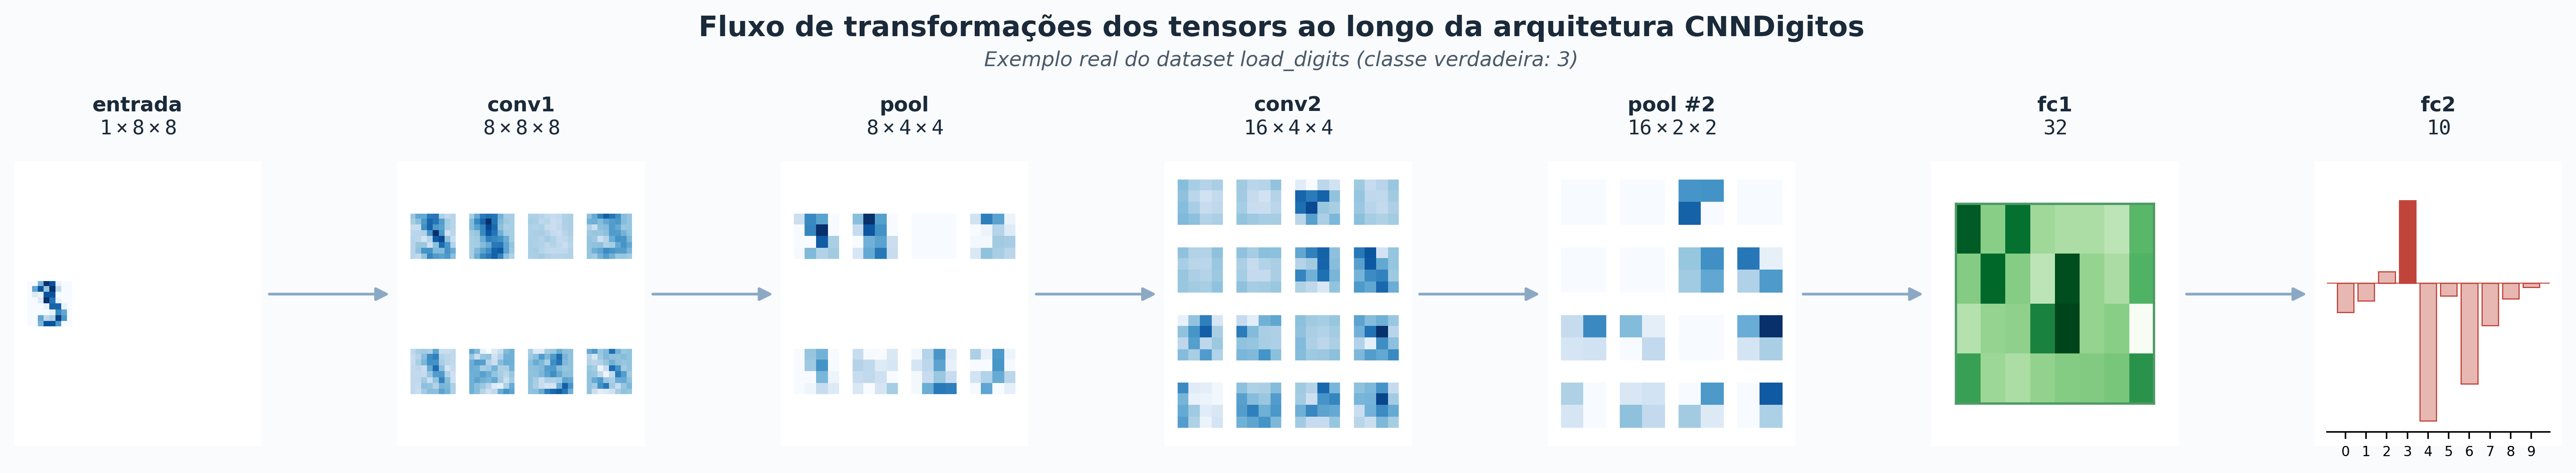
Figura 9.14 sintetiza las transformaciones espaciales de los tensores y el flujo de datos a lo largo de la clase CNNDigitos.

Figura 9.14: Representación del flujo de transformaciones dimensionales de los tensores a lo largo de la arquitectura CNNDigitos.
  1. Constructor (__init__) e Instanciación de los Componentes:
    • Capa Convolucional 1 (self.conv1): Aplica \(8\) filtros \(3 \times 3\) con padding=1 sobre la entrada en escala de grises (\(1\) canal), preservando la resolución espacial de \(8 \times 8\) píxeles.
    • Capa Convolucional 2 (self.conv2): Procesa los \(8\) mapas de características recibidos de la capa anterior aplicando \(16\) filtros \(3 \times 3\) con padding=1.
    • Submuestreo (self.pool): Instancia la operación de Max-Pooling con ventana \(2 \times 2\) y paso (stride) \(2\), reduciendo la dimensión espacial (altura y anchura) a la mitad en cada aplicación.
    • Capas Totalmente Conectadas (self.fc1 y self.fc2): La primera proyección densa recibe el tensor aplanado de dimensión \(16 \times 2 \times 2 = 64\) y produce \(32\) características intermedias. La segunda proyecta esas \(32\) características en los \(10\) logits finales de salida.
  2. Propagación hacia Adelante en el Método forward:
    • Primer Bloque Convolucional: El tensor de entrada de formato \((N, 1, 8, 8)\) pasa por conv1 + ReLU y es submuestreado por pool, resultando en el formato \((N, 8, 4, 4)\).
    • Segundo Bloque Convolucional: El tensor \((N, 8, 4, 4)\) es procesado por conv2 + ReLU y reducido por pool al formato \((N, 16, 2, 2)\).
    • Aplanamiento (Flatten): El método x.view(x.size(0), -1) reconfigura la estructura \(3\text{D}\) en un vector \(1\text{D}\) de \(64\) elementos por muestra, preservando la dimensión del lote \(N\).
    • Clasificación: El vector de \(64\) elementos alimenta fc1 con activación ReLU (\(32\) neuronas) y finaliza en fc2, produciendo los \(10\) logits no normalizados para el cálculo de la función de pérdida.
# 2. Definición de la Arquitectura Convolucional
class CNNDigitos(nn.Module):
    """
    Arquitectura convolucional compacta:
    2 capas convolucionales con ReLU y Max-Pooling + 2 capas densas.
    """
    def __init__(self, n_classes=10):
        super().__init__()
        
        # Conv1: 1 canal de entrada, 8 filtros 3x3 con padding 1 (salida: 8x8)
        self.conv1 = nn.Conv2d(1, 8, kernel_size=3, padding=1)
        # Conv2: 8 canales de entrada, 16 filtros 3x3 con padding 1 (salida: 4x4)
        self.conv2 = nn.Conv2d(8, 16, kernel_size=3, padding=1)

        self.relu = nn.ReLU()

        # Max-Pooling 2x2 con paso (stride) 2
        self.pool = nn.MaxPool2d(2, 2)

        # Capas totalmente conectadas (FC)
        self.fc1 = nn.Linear(16 * 2 * 2, 32)
        self.fc2 = nn.Linear(32, n_classes)

    def forward(self, x):
        # Primer bloque: Conv (8x8) -> ReLU -> Pool (4x4)
        x = self.pool(self.relu(self.conv1(x)))

        # Segundo bloque: Conv (4x4) -> ReLU -> Pool (2x2)
        x = self.pool(self.relu(self.conv2(x)))
        
        # Aplanamiento (Flatten): reconfigura la matriz 3D (16, 2, 2) en vector 1D (64)
        x = x.view(x.size(0), -1)

        # Capa densa intermedia con ReLU
        x = self.relu(self.fc1(x))

        # Capa final de clasificación (logits)
        return self.fc2(x)
9.5.1.1.2.1 Análisis de las Capas y del Flujo de la Clase CNNDigitos
  1. Constructor (__init__) e Instanciación de los Componentes:
    • Capa Convolucional 1 (self.conv1): Aplica \(8\) filtros \(3 \times 3\) con padding=1 sobre la entrada en escala de grises (\(1\) canal), preservando la resolución de \(8 \times 8\) píxeles.
    • Capa Convolucional 2 (self.conv2): Procesa los \(8\) mapas de características recibidos aplicando \(16\) filtros \(3 \times 3\) con padding=1.
    • Submuestreo (self.pool): Instancia la operación de Max-Pooling con ventana \(2 \times 2\) y paso (stride) \(2\), reduciendo las dimensiones espaciales (alto y ancho) a la mitad en cada aplicación.
    • Capas Totalmente Conectadas (self.fc1 y self.fc2): La primera proyección densa recibe el tensor aplanado de dimensión \(16 \times 2 \times 2 = 64\) y produce \(32\) características intermediarias. La segunda proyecta esas \(32\) características en los \(10\) logits de salida.
  2. Propagación hacia Adelante en el Método forward:
    • Primer Bloque: El tensor \((N, 1, 8, 8)\) pasa por conv1 + ReLU y es reducido por pool a \((N, 8, 4, 4)\).
    • Segundo Bloque: El tensor \((N, 8, 4, 4)\) pasa por conv2 + ReLU y es reducido por pool a \((N, 16, 2, 2)\).
    • Aplanamiento (Flatten): El método x.view(x.size(0), -1) convierte la estructura \(3\text{D}\) en un vector \(1\text{D}\) de \(64\) elementos por muestra.
    • Clasificación: El vector de \(64\) elementos alimenta fc1 con activación ReLU (\(32\) neuronas) y finaliza en fc2, que produce los \(10\) logits finales para el cálculo de la pérdida de Entropía Cruzada.
9.5.1.1.3 Bloque 3: Instanciación y Parámetros de Optimización

La etapa de configuración del aprendizaje exige la instanciación de la arquitectura definida y la elección de dos componentes centrales: la función de pérdida, que cuantifica el error del modelo, y el algoritmo de optimización, responsable de ajustar los parámetros hacia el mínimo de dicha función.

  1. Instanciación y Conteo de Parámetros: El modelo se crea a partir de la instanciación del objeto modelo_cnn de la clase CNNDigitos. La expresión sum(p.numel() for p in modelo_cnn.parameters()) recorre todos los tensores de parámetros entrenables de la red (pesos y sesgos de cada capa) y calcula la cardinalidad total del modelo, cuantificando su capacidad de representación.

  2. Función de Pérdida (nn.CrossEntropyLoss): La pérdida de Entropía Cruzada (Cross-Entropy Loss) es la elección estándar para problemas de clasificación multiclase. En PyTorch, esta implementación combina internamente la aplicación de la función LogSoftmax con la Pérdida de Log-Verosimilitud Negativa (NLLLoss). Por esta razón, la capa de salida de la red produce logits brutos, prescindiendo de la aplicación explícita de la función Softmax al final del método forward.

  3. Optimizador Adaptativo (optim.Adam): La actualización de los parámetros utiliza el algoritmo Adam (Adaptive Moment Estimation), con una tasa de aprendizaje inicial \(\eta = 0,01\) (lr=1e-2). El Adam combina los principios del momento con la adaptación del tamaño del paso basada en la media móvil de las derivadas de primer y segundo orden, ajustando individualmente la tasa de aprendizaje de cada parámetro de la red.

# 3. Inicialización del modelo y parámetros de optimización
modelo_cnn = CNNDigitos()
num_params = sum(p.numel() for p in modelo_cnn.parameters())
print(f"Parámetros entrenables del modelo: {num_params}")

criterio = nn.CrossEntropyLoss()
otimizador = optim.Adam(modelo_cnn.parameters(), lr=1e-2)
Parámetros entrenables del modelo: 3658
9.5.1.1.4 Bloque 4: Bucle de Entrenamiento y Evaluación

El entrenamiento de una CNN ocurre de forma iterativa mediante el algoritmo de Descenso de Gradiente Estocástico por mini-lotes (Mini-batch SGD).

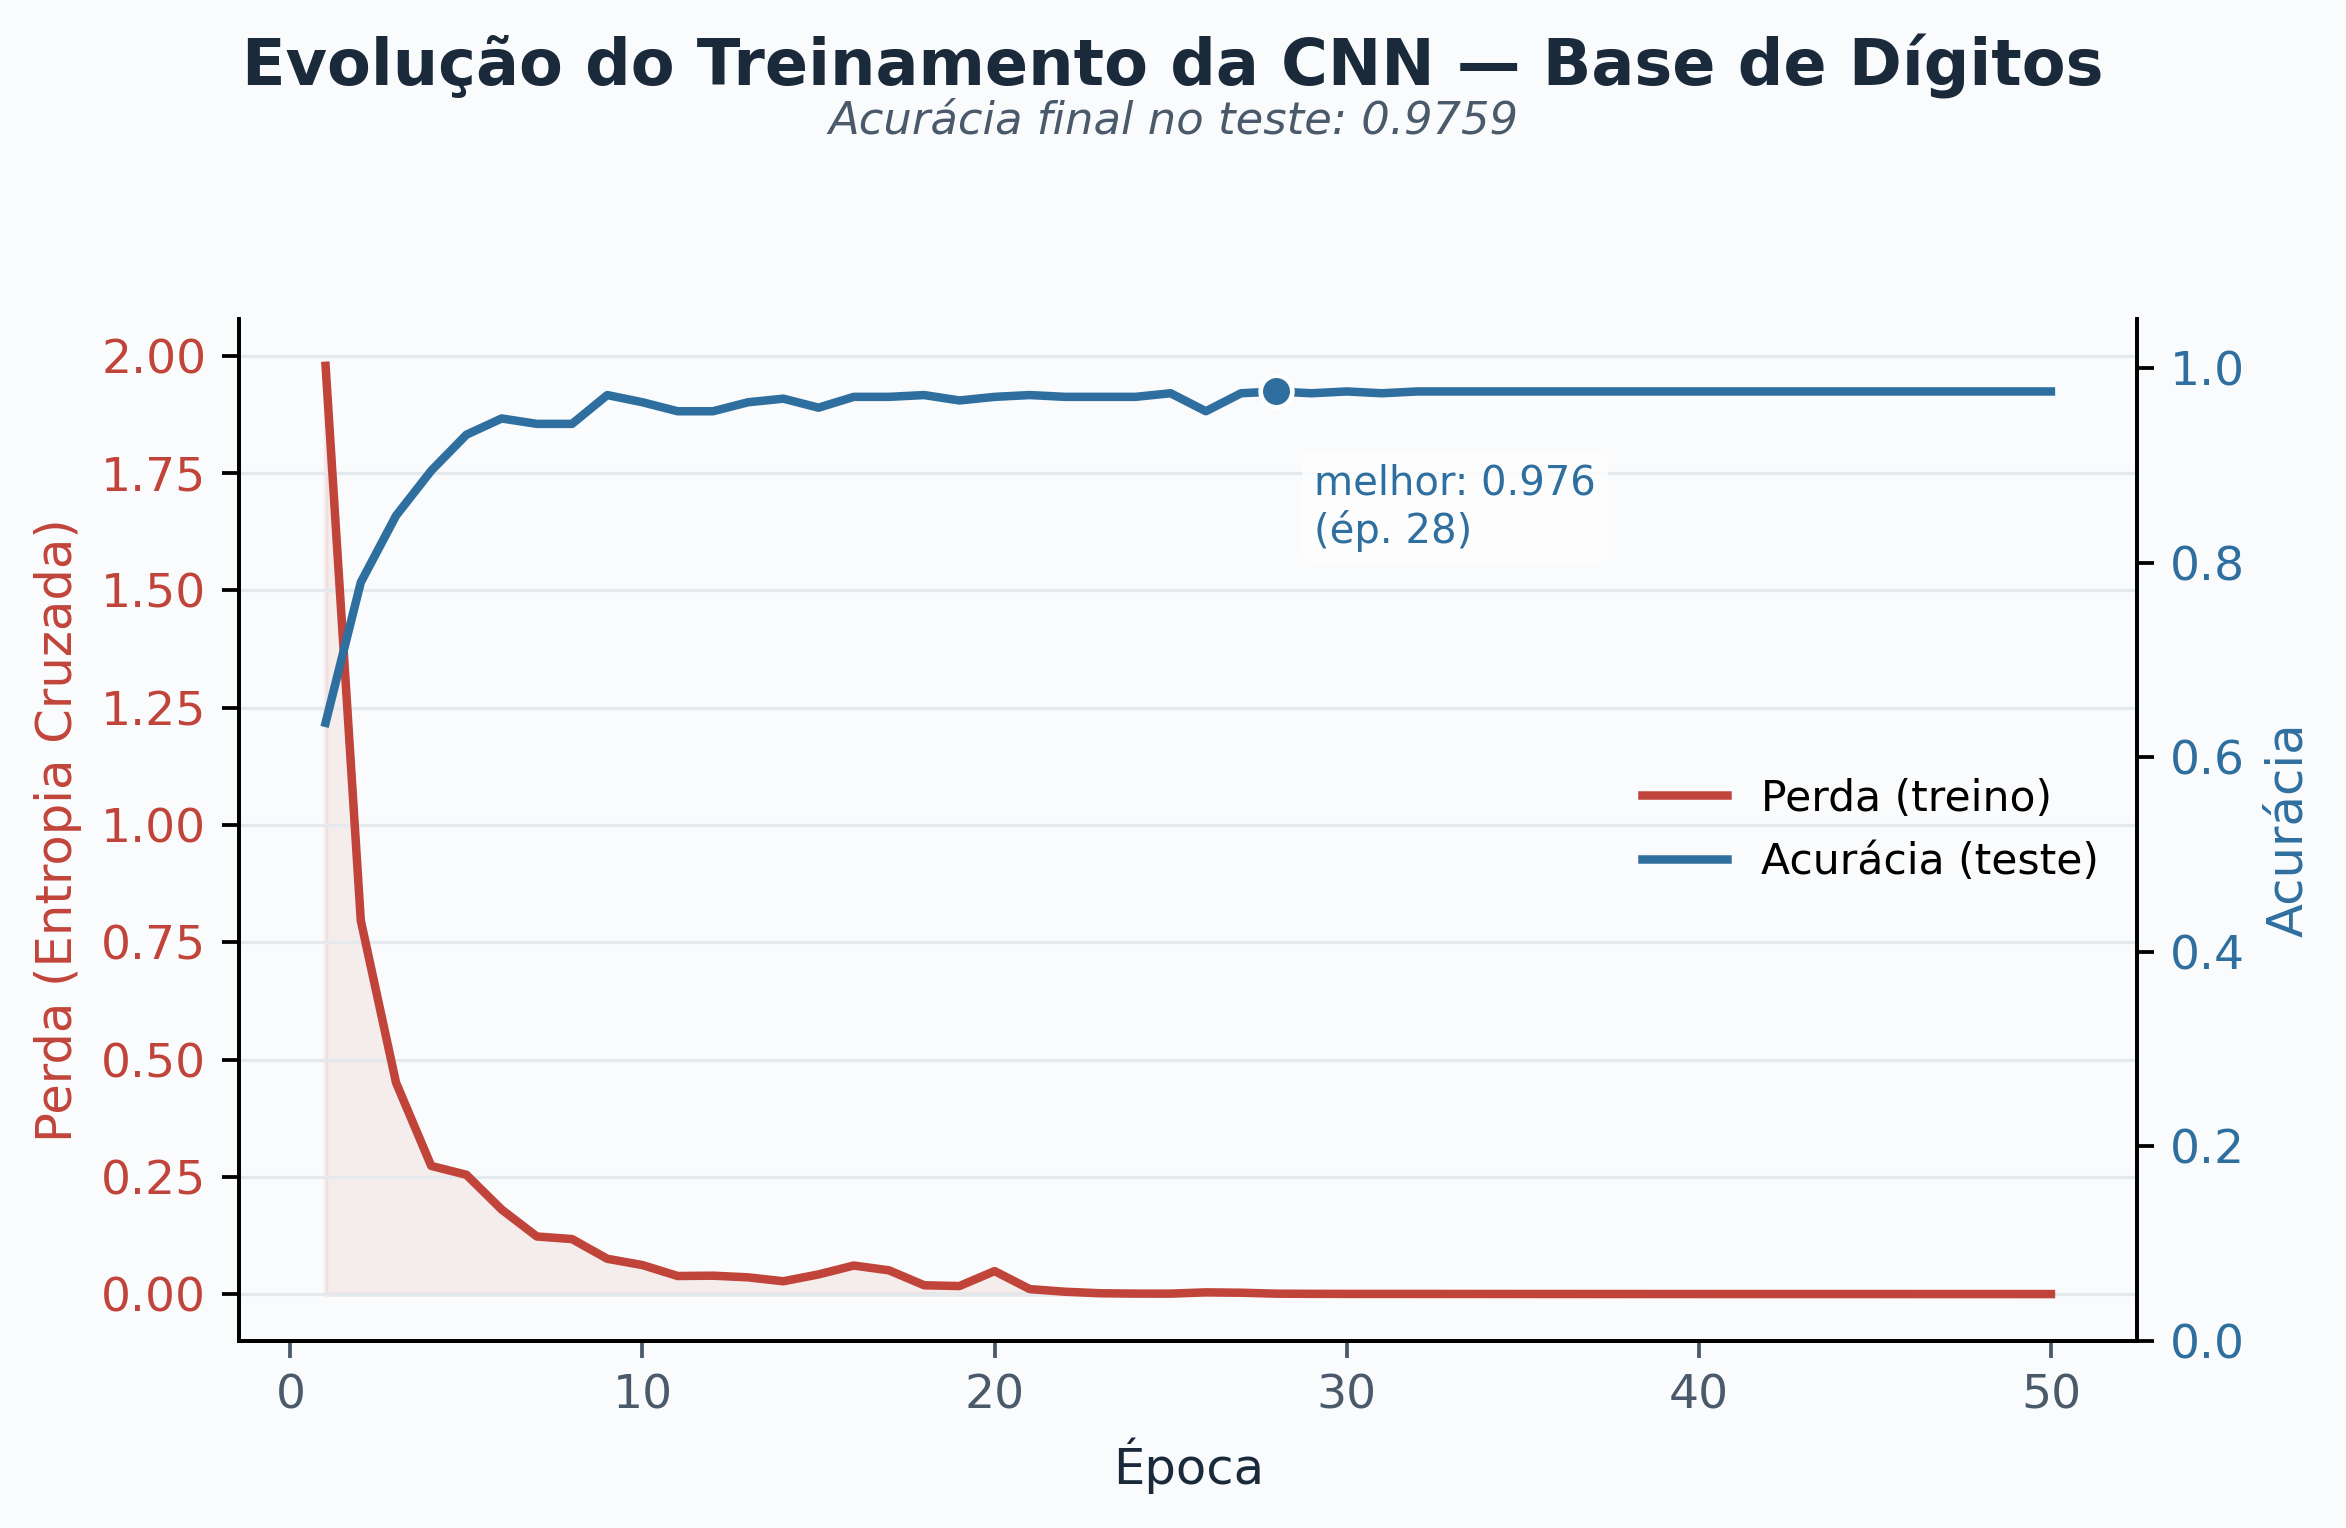
Las curvas de aprendizaje resultantes de este proceso se presentan en la Figura 9.15, generada al final de la ejecución.

  1. Fase de Entrenamiento (modelo_cnn.train()): El bucle principal ejecuta el entrenamiento a lo largo de \(50\) épocas. En cada época, ocurren las siguientes etapas:

    • Barajado Estocástico: La función torch.randperm(n) genera una permutación aleatoria de los índices de las muestras, garantizando que la ordenación de los mini-lotes varíe en cada época para evitar sesgos de muestreo.
    • División en Mini-lotes: El conjunto de entrenamiento se divide en lotes de \(32\) muestras (tam_lote = 32).
    • Poner a cero los Gradientes (otimizador.zero_grad()): Limpia los gradientes acumulados en el tensor en la iteración anterior, evitando la suma no deseada de derivadas entre lotes distintos.
    • Paso hacia Adelante y Pérdida: El forward pass calcula las predicciones saida, y la llamada criterio(saida, y_treino_t[idx]) cuantifica el error del lote.
    • Retropropagación (perda.backward()): Aplica la regla de la cadena para calcular las derivadas parciales de la pérdida con respecto a cada parámetro (\(\frac{\partial L}{\partial w}\)).
    • Actualización de los Pesos (otimizador.step()): Actualiza los parámetros del modelo según las ecuaciones del optimizador Adam.
  2. Fase de Evaluación (modelo_cnn.eval()): Al final de cada época, el modelo se cambia al modo de evaluación. El contexto with torch.no_grad() desactiva temporalmente el motor de cálculo automático de derivadas (autograd), reduciendo el consumo de memoria y acelerando la inferencia sobre el conjunto de prueba (X_teste_t). La operación .argmax(dim=1) extrae la clase de mayor probabilidad para cada muestra, permitiendo calcular la precisión de prueba.

  3. Visualización con la Biblioteca morph: La función mm.showTrainCurves de la biblioteca didáctica morph consolida el historial de pérdida de entrenamiento y la precisión de prueba en un único panel gráfico, permitiendo diagnosticar la convergencia del modelo y monitorear la estabilidad del aprendizaje a lo largo de las épocas.

# 4. Bucle de Entrenamiento (Mini-batch SGD)
n = X_treino_t.size(0)                    # Número de muestras
tam_lote = 32                             # Tamaño del mini-lote
epocas = 50                               # Total de épocas
historico_perda, historico_acc = [], []   # Historial de métricas

for epoca in range(epocas):                  # Repite por época
    modelo_cnn.train()                       # Modo entrenamiento
    perm = torch.randperm(n)                 # Baraja muestras
    perda_epoca = 0.0                        # Acumula pérdidas
    for i in range(0, n, tam_lote):          # Recorre mini-lotes
        idx = perm[i:i + tam_lote]           # Índices del lote
        otimizador.zero_grad()               # Pon a cero gradientes
        saida = modelo_cnn(X_treino_t[idx])  # Propagación hacia adelante
        perda = criterio(saida, y_treino_t[idx]) # Calcula pérdida
        perda.backward()                         # Retropropagación
        otimizador.step()                        # Actualiza pesos
        perda_epoca += perda.item() * len(idx)   # Suma pérdida

    # Evaluación del modelo en el conjunto de prueba al final de cada época
    modelo_cnn.eval()                            # Modo evaluación
    with torch.no_grad():                        # Sin gradientes
        pred_teste = modelo_cnn(X_teste_t).argmax(dim=1)  # Predicciones
        acc_teste = (pred_teste == y_teste_t).float().mean().item()  # Exactitud
    historico_perda.append(perda_epoca / n)      # Registra pérdida
    historico_acc.append(acc_teste)              # Registra exactitud

acc_final_cnn = historico_acc[-1]                # Última exactitud
print(f"Exactitud final de la CNN en el conjunto de prueba: {acc_final_cnn:.4f}")  # Muestra resultado

final = mm.showTrainCurves(                      # Traza curvas
    historico_perda, historico_acc,
    titulo="Evolução do Treinamento da CNN — Base de Dígitos",
    subtitulo=f"Acurácia final no teste: {acc_final_cnn:.4f}",
)
Exactitud final de la CNN en el conjunto de prueba: 0.9759
Figura 9.15: Curvas de entrenamiento y evaluación de la CNN en la base de dígitos: evolución de la pérdida de entropía cruzada en el conjunto de entrenamiento y de la exactitud en el conjunto de prueba a lo largo de 50 épocas.
9.5.1.1.5 Bloco 5: Visualización del Flujo de Activaciones

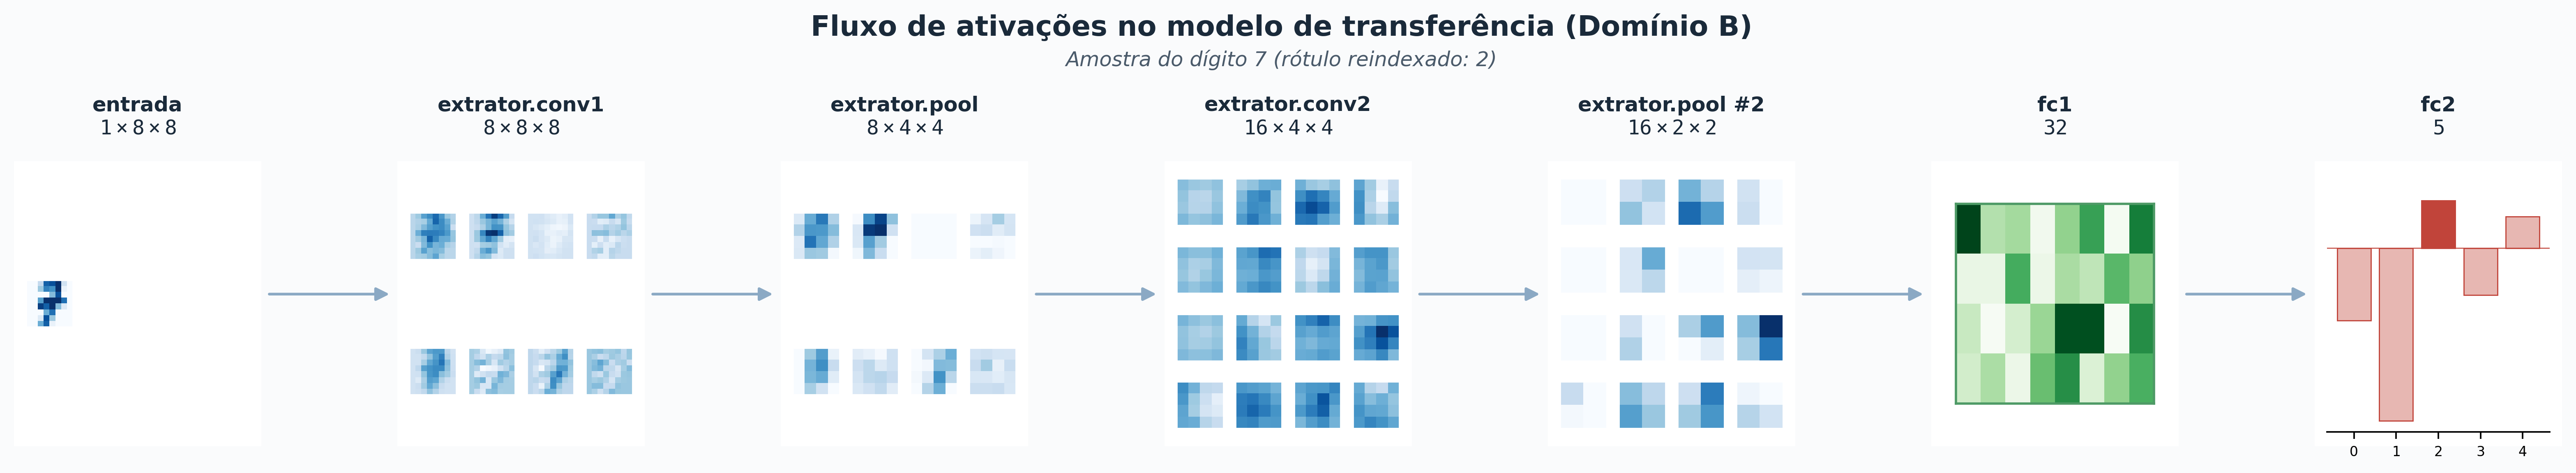
La inspección de la red entrenada permite observar la transformación progresiva del tensor de entrada a lo largo de las capas de la arquitectura CNNDigitos. La Figura 9.16 ilustra las dimensiones y las activaciones intermedias obtenidas al procesar un ejemplo real del dígito \(3\).

  1. Selección y Preparación de la Muestra: La semilla estocástica se fija con torch.manual_seed(7) para asegurar la reproducibilidad de los resultados. La primera ocurrencia del dígito \(3\) en el conjunto de datos load_digits se aísla, se normaliza al intervalo \([0.0, 1.0]\) y se reconfigura como un tensor x de dimensión \((1, 1, 8, 8)\).

  2. Inspección Intermedia con mm.showNet: La función mm.showNet de la biblioteca morph ejecuta la propagación hacia adelante (forward pass) del tensor x en la instancia modelo_cnn previamente entrenada. Utilizando hooks de forward, la función intercepta el estado numérico de las activaciones en las capas convolucionales (nn.Conv2d), de agrupamiento (nn.MaxPool2d) y totalmente conectadas (nn.Linear), devolviéndolas en el diccionario acts. Las funciones de activación no lineal (nn.ReLU) no se registran como etapas independientes, ya que su aplicación ocurre directamente sobre el tensor de salida de la capa correspondiente.

  3. Verificación de los Resultados: La instrucción list(acts.keys()) muestra la secuencia de identificadores de las capas monitoreadas, permitiendo confirmar la reducción dimensional progresiva y la generación del logit de valor máximo en el índice correspondiente a la clase \(3\), según se demuestra en la Figura 9.16..

torch.manual_seed(7)
digits = load_digits()
idx = np.where(digits.target == 3)[0][0]
img = digits.images[idx] / 16.0
x = torch.tensor(img, dtype=torch.float32).view(1, 1, 8, 8)

# Reutilización de la instancia del modelo previamente entrenado
acts = mm.showNet(
    modelo_cnn,
    x,
    titulo="Fluxo de transformações dos tensors ao longo da arquitetura CNNDigitos",
    subtitulo=f"Exemplo real do dataset load_digits (classe verdadeira: {digits.target[idx]})",
)
print("Capas capturadas:", list(acts.keys()))
Figura 9.16: Flujo de activaciones de la CNN entrenada al procesar un ejemplo real del dígito 3, del dataset load_digits: dimensiones de los tensores capa a capa, de la entrada al logit de salida.
Capas capturadas: ['conv1', 'pool', 'conv2', 'pool #2', 'fc1', 'fc2']
9.5.1.1.6 Inspeccionando el Grafo Computacional con torchviz

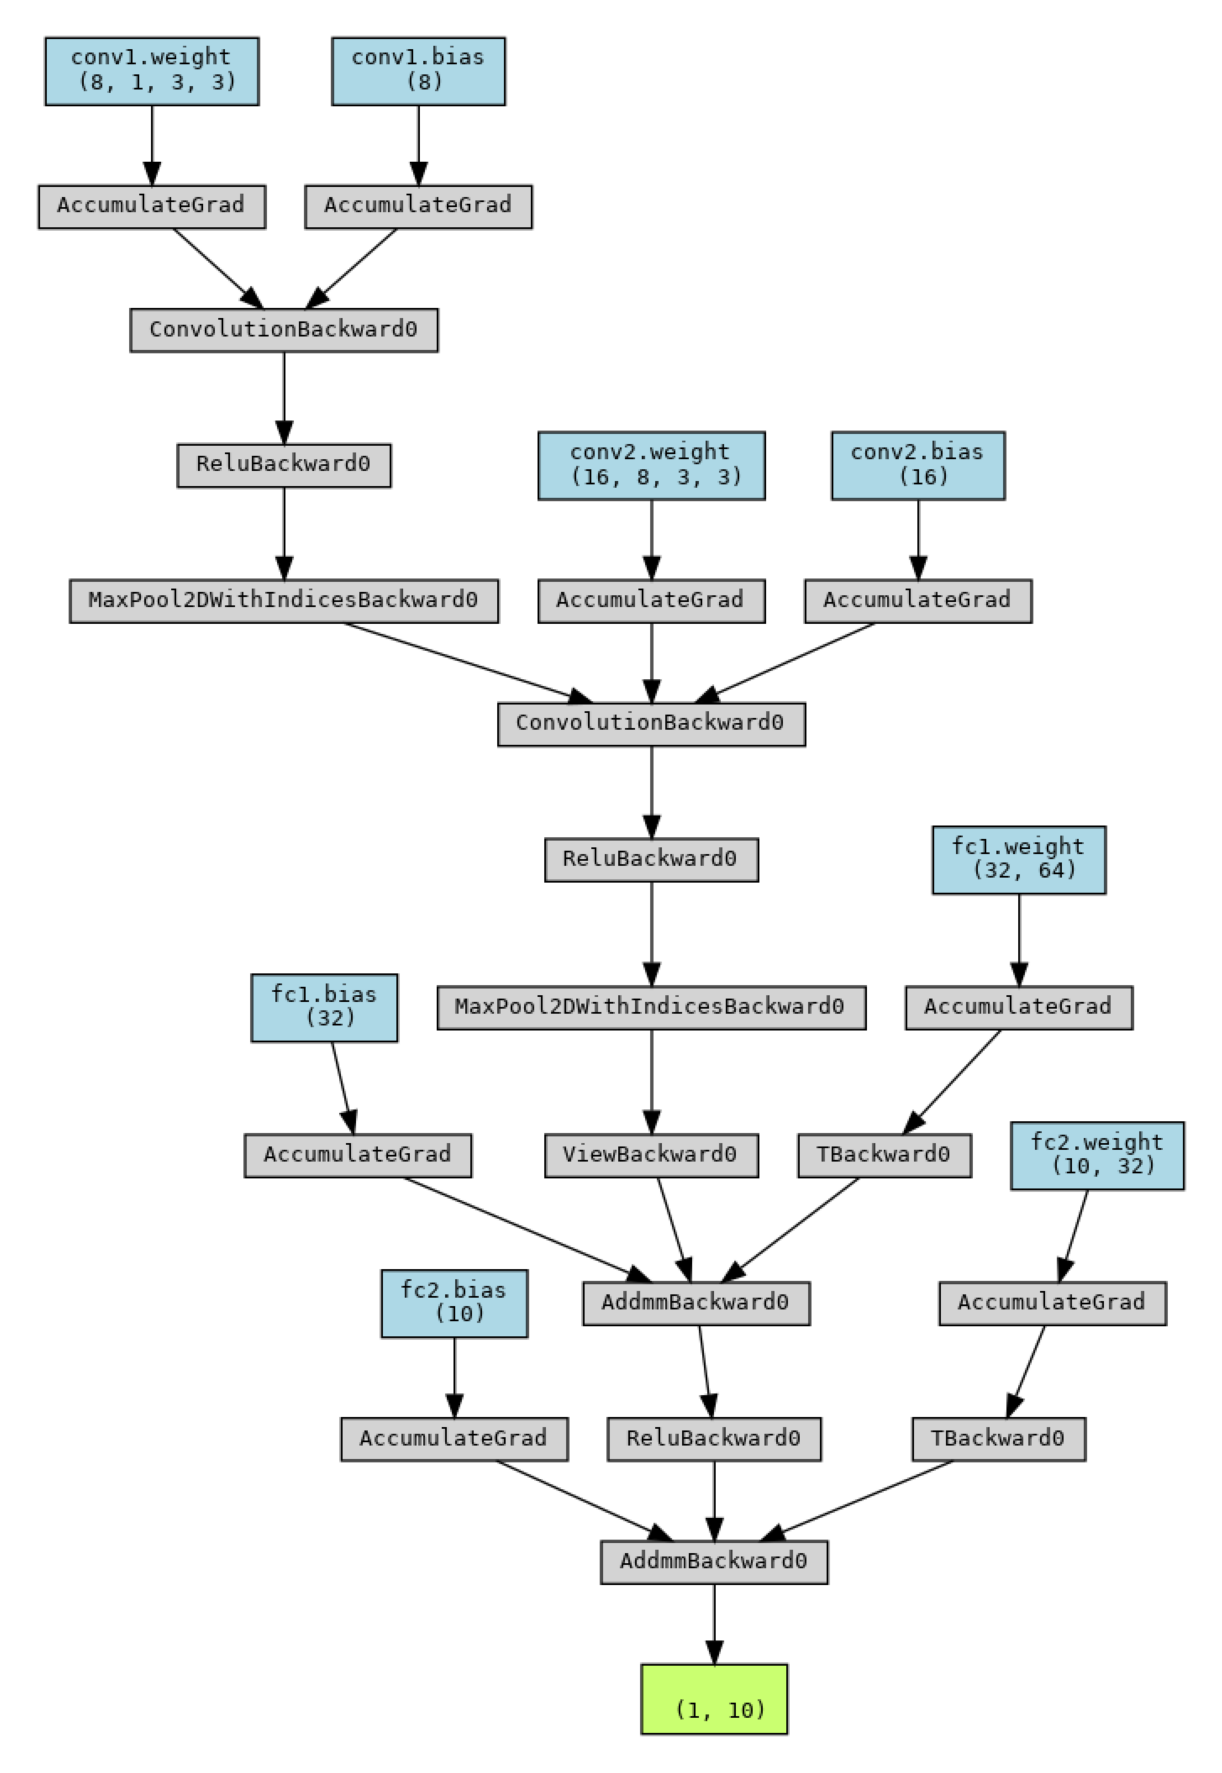
Mientras que mm.showNet prioriza la claridad didáctica —mostrando una columna por capa con parámetros entrenables—, la biblioteca torchviz proyecta el grafo de autograd exactamente como PyTorch lo construye internamente para el cálculo de gradientes. La Figura 9.17 ilustra esta perspectiva al representar la arquitectura CNNDigitos.

  1. Propagación hacia adelante rastreada: Con el modelo entrenado en modo eval(), el forward pass sobre el tensor x del dígito \(3\) es suficiente para que el motor de autograd registre todas las operaciones ejecutadas, incluyendo aquellas sin parámetros entrenables, como la función de activación ReLU y la reconfiguración dimensional view.

  2. Generación del grafo (make_dot): La función make_dot(saida, params=...) construye el grafo a partir del tensor de salida, recorriendo retroactivamente el historial de operaciones hasta los nodos hoja (los parámetros entrenables del modelo). Cada nodo del diagrama representa una operación del backward pass (como ReluBackward o AddmmBackward), y no solo un bloque conceptual del nn.Module.

  3. Exportación y renderizado (.render): El método .render(..., format="png", cleanup=True) invoca el ejecutable dot de Graphviz para compilar la imagen en formato PNG, eliminando automáticamente los archivos intermedios de código fuente.

La Figura 9.17 evidencia cómo este grafo computacional, incluso para una arquitectura compacta, presenta mayor densidad que el panel de mm.showNet, pues detalla cada operación atómica responsable del flujo de gradientes.

# 1. Forward pass con rastreo de gradiente habilitado
modelo_cnn.eval()
saida = modelo_cnn(x)  # Reutilización del tensor x (dígito 3)

# 2. Grafo básico: flujo de operaciones hasta la salida
grafo_simples = make_dot(saida, params=dict(modelo_cnn.named_parameters()))
caminho_simples = grafo_simples.render("cnn_digitos_grafo_simples", format="png", cleanup=True)

# 3. Visualización directa en el entorno Quarto/Jupyter
# El .render() devuelve la ruta del archivo PNG generado; necesitamos abrirlo como imagen
imagem_simples = np.array(Image.open(caminho_simples).convert("RGB"))
mm.show(imagem_simples, figsize=(5,10))
Figura 9.17: Grafo computacional de la CNNDigitos generado vía torchviz, mostrando las operaciones de forward y los nodos de gradiente (backward) asociados a cada parámetro entrenable.
9.5.1.1.7 Visão Detallada del Grafo Computacional con torchviz

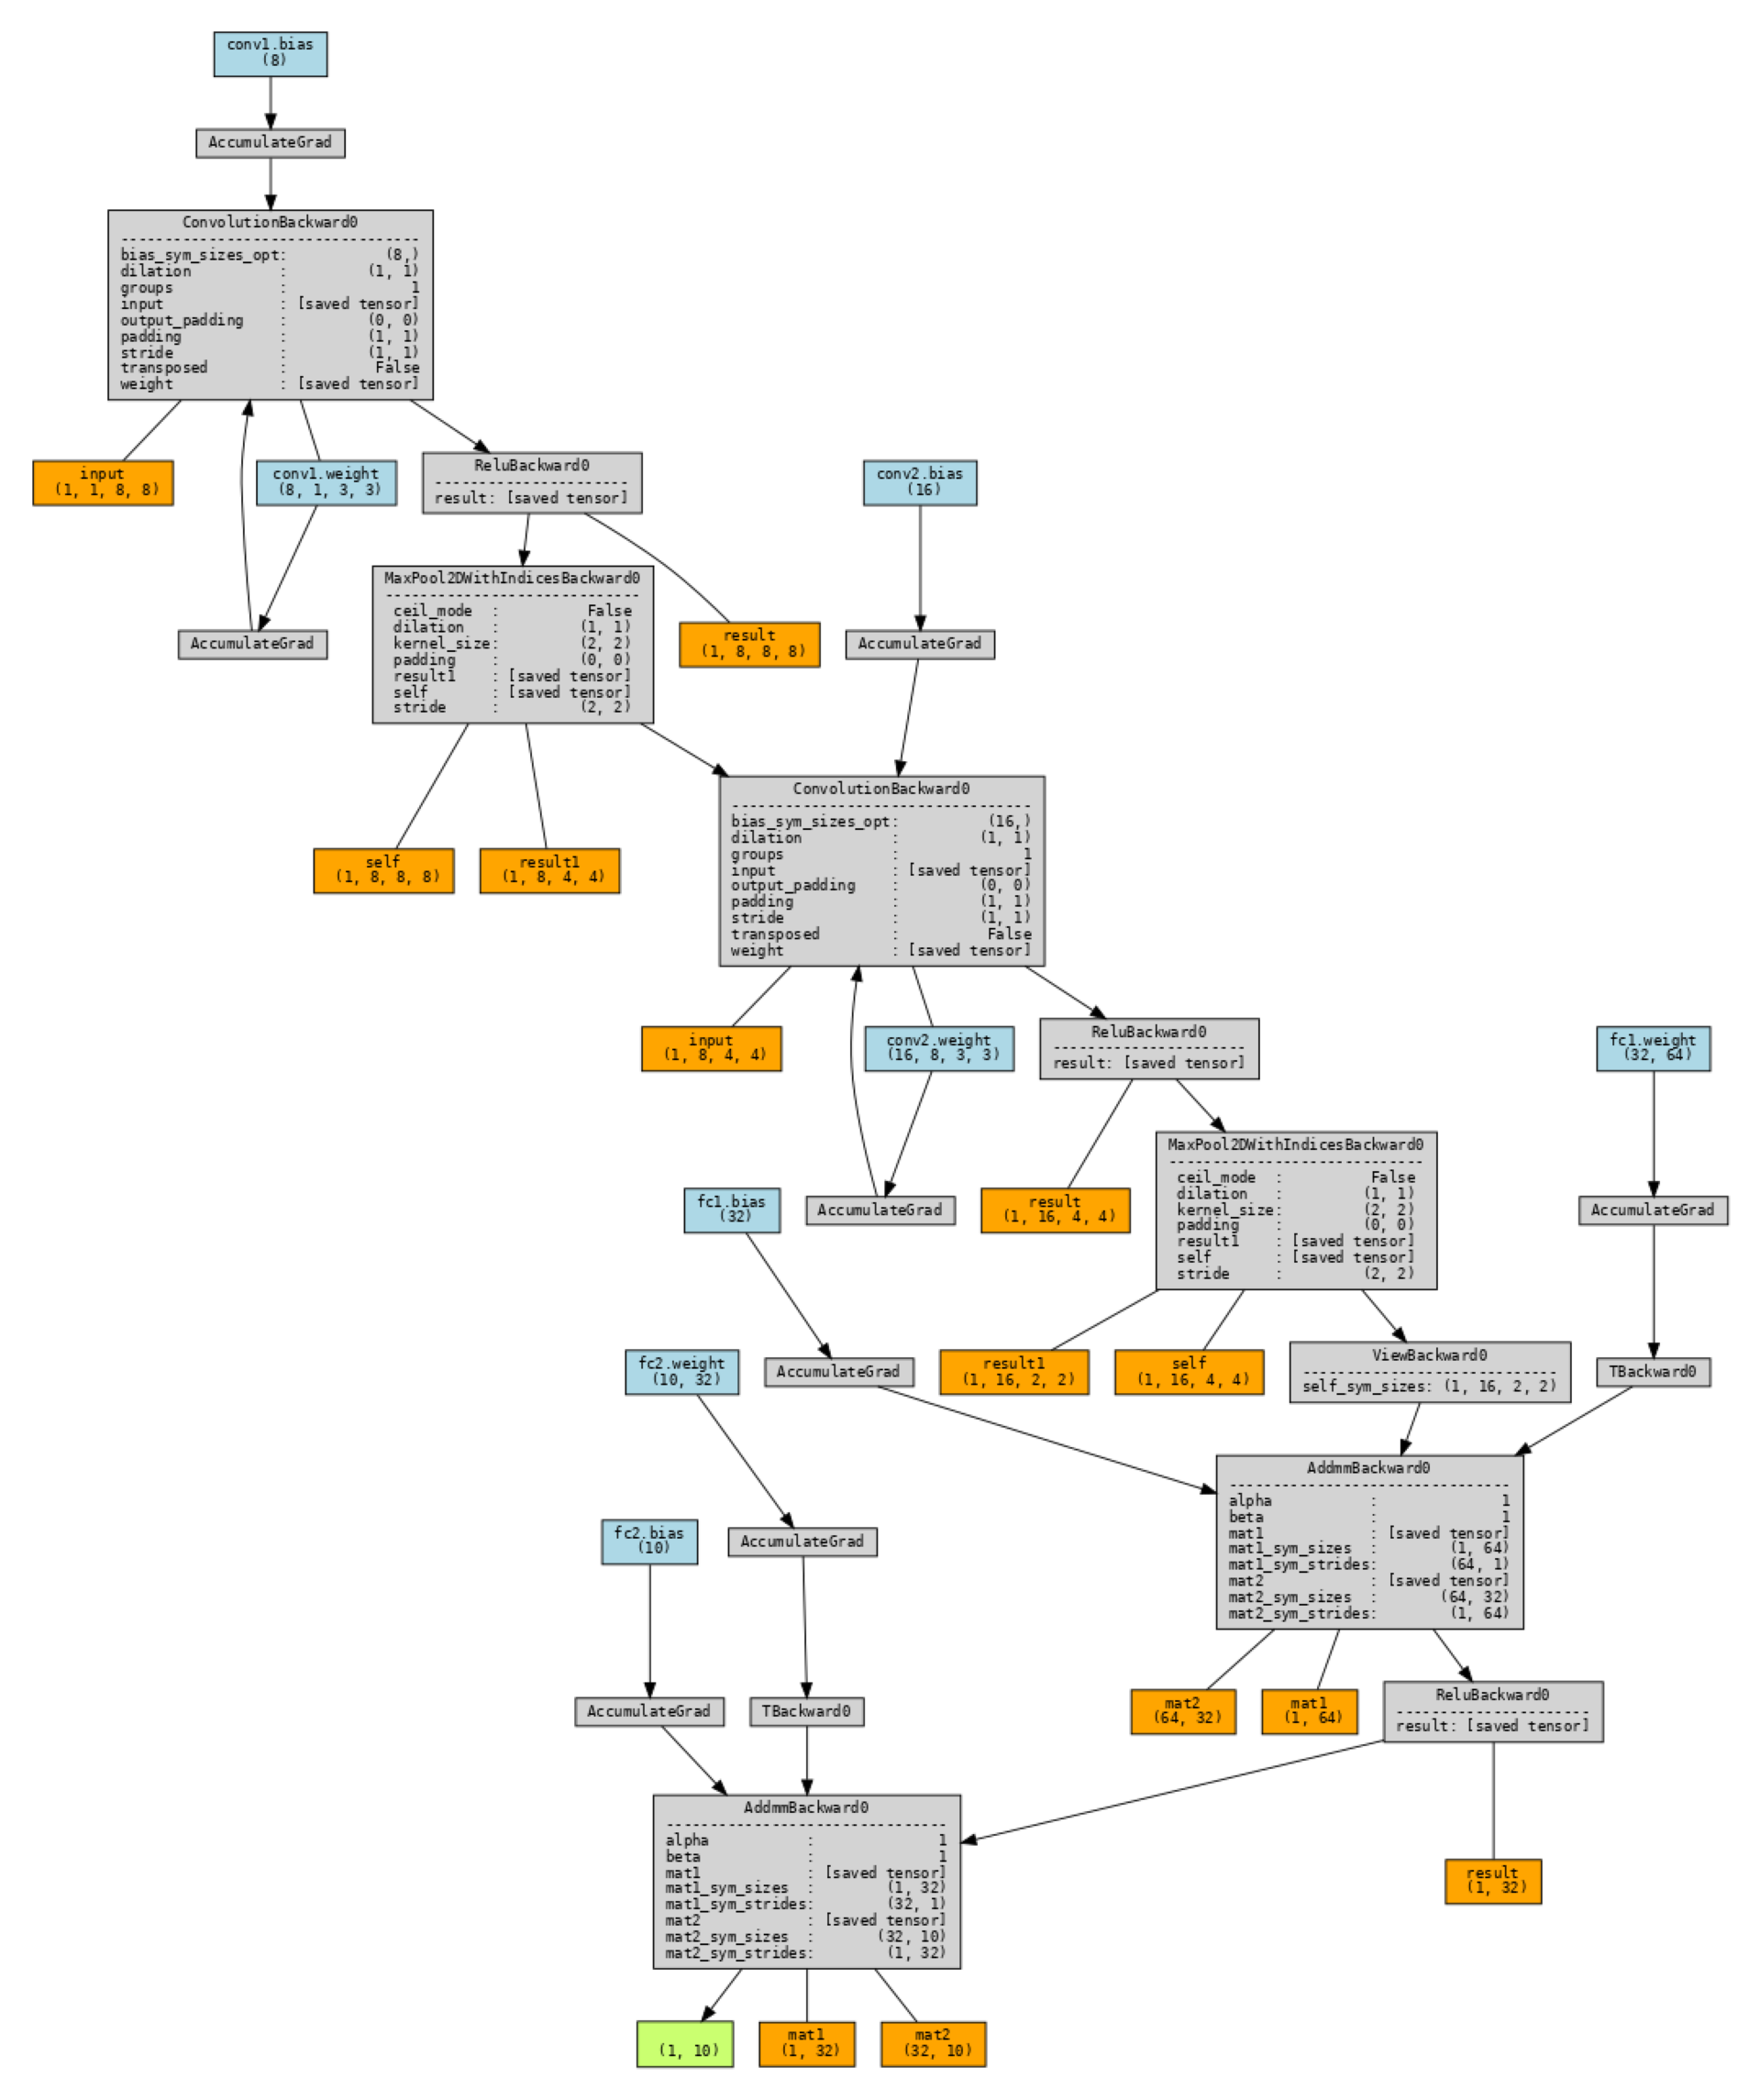
Además de la representación simplificada, la biblioteca torchviz permite expandir el grafo de autograd para inspeccionar los detalles internos de ejecución de la red CNNDigitos. La Figura 9.18 presenta esta estructura expandida para el mismo tensor de entrada x.

  1. Rastreo con Atributos de Operación (show_attrs=True): La inclusión de atributos muestra las configuraciones hiperparamétricas asociadas a cada nodo computacional durante la propagación hacia adelante (forward pass), tales como dimensiones de kernel (kernel_size), pasos (stride) y rellenos (padding) en las convoluciones y submuestreos.

  2. Detección de Tensors Guardados en Memoria (show_saved=True): El parámetro fuerza la visualización explícita de los tensors intermedios que PyTorch retiene en memoria durante el forward pass. Estos datos se conservan porque serán estrictamente necesarios para el cálculo de las derivadas parciales durante la etapa de retropropagación (backward pass).

  3. Generación y Compilación de los Grafos: Mientras que grafo_simples genera una vista directa del flujo de gradientes, grafo_detalhado compila el grafo expandido en el archivo cnn_digitos_grafo_detalhado.png mediante el ejecutable dot de Graphviz.

Como se observa en la Figura 9.18, esta visualización minuciosa es útil para depurar el consumo de memoria de video (VRAM) y verificar cómo el motor de PyTorch asigna internamente cada nodo de la regla de la cadena.

# mismo código anterior (make_dot + render)...

# 2. Grafo detallado: exhibición de dimensiones y tensores guardados para el backward
grafo_detalhado = make_dot(
    saida,
    params=dict(modelo_cnn.named_parameters()),
    show_attrs=True,   # Exhibe atributos de las operaciones (ej.: kernel_size, stride)
    show_saved=True,   # Exhibe tensores guardados en la memoria para la retropropagación
)

caminho_detalhado = grafo_detalhado.render("cnn_digitos_grafo_detalhado", 
                                           format="png", cleanup=True)

# 3. Exhibición directa en el entorno Quarto/Jupyter
imagem_detalhado = np.array(Image.open(caminho_detalhado).convert("RGB"))
mm.show(imagem_detalhado, figsize=(8, 16))
Figura 9.18: Grafo detallado de la clase CNNDigitos generado via torchviz.
9.5.1.1.8 Comparando con el Capítulo 7

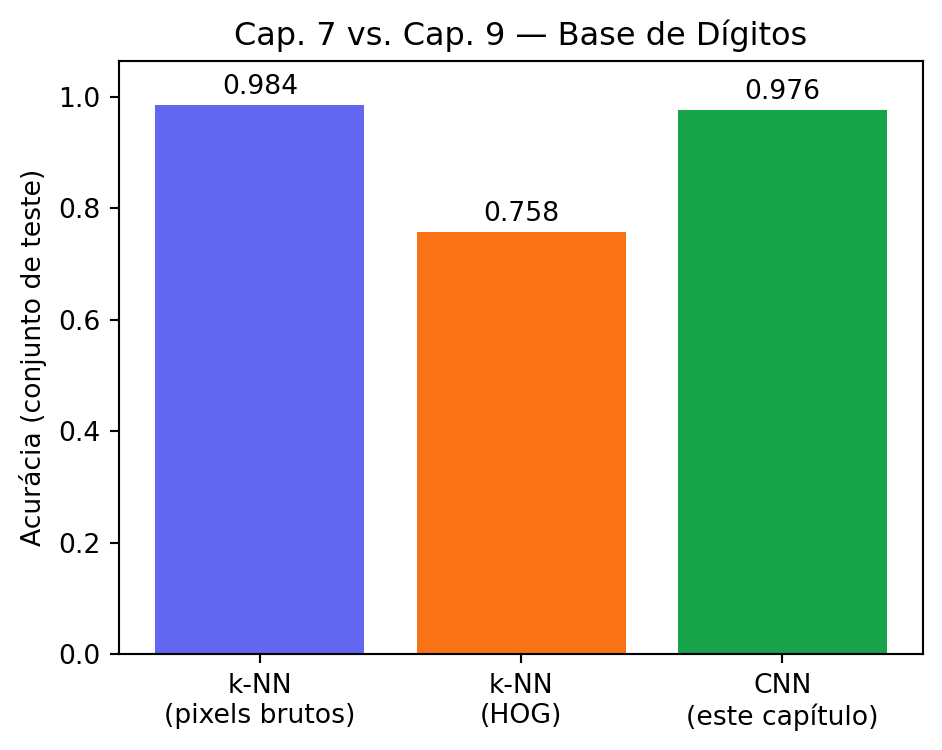
La Figura 9.19 reúne los resultados obtenidos en el mismo conjunto de datos (load_digits), estableciendo un paralelo directo entre los enfoques clásicos explorados anteriormente y la CNN desarrollada en este capítulo.

  1. Rendimiento de los píxeles brutos vs. descriptores manuales: En los experimentos del Capítulo 7, el clasificador \(k\text{-NN}\) (\(k=3\)) alcanzó una precisión del \(98,4\%\) cuando se alimentó directamente con los píxeles brutos de las imágenes. En contraste, la extracción previa de características mediante Histogram of Oriented Gradients (HOG) resultó en un rendimiento significativamente inferior (\(75,8\%\)). Esta caída se debe a que el HOG fue diseñado para capturar gradientes de bordes en imágenes de mayor resolución; en matrices de solo \(8 \times 8\) píxeles, la resolución espacial es insuficiente para formar histogramas de orientación informativos.

  2. Equivalencia de la CNN y aprendizaje end-to-end: La red convolucional CNNDigitos alcanza un rendimiento competitivo del \(97,6\%\), acercándose a la precisión del \(k\text{-NN}\) con píxeles brutos en una base pequeña y prealineada. La gran ventaja conceptual reside en el aprendizaje de representación: en lugar de depender de descriptores diseñados manualmente (handcrafted features) o de mantener todo el conjunto de datos en memoria para la búsqueda de vecinos en el momento de la inferencia, la CNN optimiza automáticamente sus propios filtros convolucionales durante el entrenamiento, generando un modelo compacto capaz de realizar la extracción de características y la clasificación de forma integrada (end-to-end).

import matplotlib.pyplot as plt

# Valores obtenidos en el Capítulo 7 (k-NN, k=3), reproducidos para comparación directa
ACC_KNN_PIXELS_CAP7 = 0.9844
ACC_KNN_HOG_CAP7 = 0.7578

metodos = ["k-NN\n(pixels brutos)", "k-NN\n(HOG)", "CNN\n(este capítulo)"]
acuracias = [ACC_KNN_PIXELS_CAP7, ACC_KNN_HOG_CAP7, acc_final_cnn]

plt.figure(figsize=(5, 4))
cores = ["#6366f1", "#f97316", "#16a34a"]
plt.bar(metodos, acuracias, color=cores)
plt.ylim(0, max(acuracias) + 0.08)
plt.ylabel("Acurácia (conjunto de teste)")
plt.title("Cap. 7 vs. Cap. 9 — Base de Dígitos")

for i, v in enumerate(acuracias):
    plt.text(i, v + 0.02, f"{v:.3f}", ha="center")

plt.tight_layout()
plt.show()
Figura 9.19: Comparación de precisión entre los clasificadores clásicos del Capítulo 7 (píxeles brutos y HOG con k-NN) y la CNN entrenada en este capítulo, en la misma base de dígitos.
Nota🧠 ¿Por qué funciona? — Y por qué la CNN no siempre “gana”

El resultado aquí observado repite el patrón ya visto en el Capítulo 7: la CNN, aunque aprende sus características automáticamente, no supera necesariamente al \(k\text{-NN}\) con píxeles brutos en esta base específica. La explicación es la misma: load_digits es una base pequeña (menos de \(1.800\) ejemplos), con imágenes ya centradas, normalizadas y de muy baja resolución (\(8 \times 8\)) — condiciones en las que la comparación directa de intensidades ya es altamente informativa, y hay pocos datos para que la red aprenda filtros verdaderamente superiores a los descriptores simples.

El verdadero diferencial de las CNN aparece en escenarios que los descriptores artesanales y los clasificadores simples no pueden abordar: imágenes más grandes y realistas, con miles de categorías, variación sustancial de pose, iluminación y fondo, y conjuntos de entrenamiento masivos — exactamente el régimen en el que los modelos presentados en la sección “Aplicaciones a Gran Escala”, más adelante, fueron entrenados. La lección pedagógica que atraviesa los Capítulos 7, 8 y 9 de este libro es consistente: la sofisticación de un método debe ser proporcional a la complejidad del problema — usar una CNN para un problema que un \(k\text{-NN}\) resuelve igualmente bien es desperdicio de recursos computacionales, no una virtud.

Esa misma proporcionalidad se aplica a las herramientas de inspección utilizadas a lo largo del capítulo. El mm.showNet fue construido con fines didácticos y funciona bien en redes poco profundas como la CNNDigitos, pero no escala a arquitecturas profundas: cada capa rastreada se convierte en una columna en la figura, y las capas convolucionales con cientos de canales generan mosaicos demasiado grandes para la interpretación visual; además, los hooks almacenan todas las activaciones en memoria, y el layout asume un flujo secuencial, sin representar fielmente conexiones residuales o ramificaciones (como en ResNets o módulos Inception). Así, showNet debe entenderse como una lente pedagógica para redes pequeñas — análoga al papel de mm.showBoundBox en la depuración visual de detecciones — y no como un sustituto de herramientas orientadas a la producción, como TensorBoard o torchviz.

9.5.1.2 Transferencia de Aprendizaje

Entrenar una CNN desde cero generalmente requiere una gran cantidad de datos etiquetados y recursos computacionales significativos, ya que el proceso de entrenamiento necesita ajustar todos los parámetros de la red. En muchas aplicaciones, sin embargo, solo se dispone de un conjunto reducido de datos para la tarea de interés. En esta situación, la transferencia de aprendizaje (transfer learning) reutiliza las representaciones aprendidas por un modelo previamente entrenado en una tarea de origen con un gran volumen de datos, reduciendo el costo de entrenamiento y la necesidad de nuevas muestras.

En la VC, esta estrategia explora la organización jerárquica de las CNNs. Las capas iniciales aprenden características visuales de bajo nivel, como bordes, texturas, gradientes de intensidad y patrones de colores, que permanecen útiles en diferentes dominios. Las capas más profundas combinan esta información para formar representaciones progresivamente más abstractas y especializadas, relacionadas con las clases presentes en la base de entrenamiento.

Esta sección investiga en qué condiciones la transferencia de aprendizaje produce buenos resultados. El primer experimento muestra que un extractor pequeño y entrenado en un dominio restringido puede conducir a la transferencia negativa (negative transfer). El segundo demuestra por qué los modelos profundos preentrenados en grandes bases de imágenes alcanzan un alto rendimiento en nuevas tareas. Por último, el tercero aplica esta estrategia a un problema de diagnóstico fitosanitario, ilustrando un escenario cercano a aplicaciones reales.

9.5.1.2.1 Experimento 1 — Limitaciones de un Extractor Pequeño y Especializado

El primer experimento muestra que la transferencia de aprendizaje no siempre mejora el rendimiento de un modelo. Para ello, el conjunto de dígitos manuscritos (load_digits) se divide en dos dominios disjuntos:

  • Dominio A (origen): dígitos \(0\) a \(4\), utilizados para entrenar una pequeña CNN;
  • Dominio B (destino): dígitos \(5\) a \(9\), reindexados a \(0\) a \(4\), formando una nueva tarea con solo \(20\) muestras de entrenamiento.

El objetivo consiste en evaluar el efecto de reutilizar el extractor de características aprendido en el Dominio A sin permitir su adaptación al Dominio B.

9.5.1.2.1.1 Bloque 1: División de los Dominios, Escasez y Exhibición de las Muestras

Este bloque prepara el conjunto de datos para el experimento. A diferencia del proyecto anterior, que utilizó todos los dígitos en un único problema de clasificación, la base se divide en dos tareas independientes: una tarea de origen (Dominio A) y una tarea de destino (Dominio B).

La Figura 9.20 presenta ejemplos de los dos dominios después de la separación de las clases, la conversión a tensors de PyTorch y el preprocesamiento.

  1. Separación de las clases: Las máscaras booleanas mask_A y mask_B separan los ejemplos de cada dominio. A continuación, el código reindexa las etiquetas del Dominio B (y[mask_B] - 5) al intervalo \([0,4]\), permitiendo que ambos modelos utilicen cinco clases de salida.

  2. Escasez de datos: El generador np.random.default_rng(0) selecciona solo \(20\) muestras para el entrenamiento del Dominio B, aproximadamente cuatro por clase, simulando un escenario en el que el entrenamiento desde cero tiende a sufrir de overfitting.

  3. Conversión a tensors: La función para_tensor convierte las imágenes al formato \((N,1,8,8)\) y las etiquetas a torch.long, compatibles con las capas nn.Conv2d y la función de pérdida.

  4. Visualización de las muestras: El código utiliza .squeeze().numpy() para convertir los tensors en matrices de NumPy. La Figura 9.20 presenta ejemplos de los dos dominios y evidencia la reindexación aplicada a las etiquetas del Dominio B.

# 1. División del dataset en dos dominios disjuntos
classes_A, classes_B = [0, 1, 2, 3, 4], [5, 6, 7, 8, 9]
mask_A, mask_B = np.isin(y, classes_A), np.isin(y, classes_B)

XA, yA = X[mask_A], y[mask_A]
XB, yB = X[mask_B], y[mask_B] - 5  # Reindexación de las etiquetas al intervalo [0, 4]

# División en entrenamiento y prueba para ambos dominios
XA_tr, XA_te, yA_tr, yA_te = train_test_split(
    XA, yA, test_size=0.25, random_state=42, stratify=yA
)
XB_tr, XB_te, yB_tr, yB_te = train_test_split(
    XB, yB, test_size=0.25, random_state=42, stratify=yB
)

# Simulación de escasez extrema en el dominio de destino: solo 20 muestras de entrenamiento
rng = np.random.default_rng(0)
idx_poucos = rng.choice(len(XB_tr), size=20, replace=False)
XB_tr_poucos, yB_tr_poucos = XB_tr[idx_poucos], yB_tr[idx_poucos]

# Función auxiliar para conversión a tensores PyTorch
def para_tensor(Ximg, yarr):
    return torch.tensor(Ximg).unsqueeze(1), torch.tensor(yarr, dtype=torch.long)

XA_tr_t, yA_tr_t = para_tensor(XA_tr, yA_tr)
XA_te_t, yA_te_t = para_tensor(XA_te, yA_te)
XB_tr_t, yB_tr_t = para_tensor(XB_tr_poucos, yB_tr_poucos)
XB_te_t, yB_te_t = para_tensor(XB_te, yB_te)

# Visualización de muestras de ambos dominios
n_amostras = 5
imgs_A = [img.squeeze().numpy() for img in XA_tr_t[:n_amostras]]
titles_A = [f"A: {label.item()}" for label in yA_tr_t[:n_amostras]]

imgs_B = [img.squeeze().numpy() for img in XB_tr_t[:n_amostras]]
titles_B = [f"B: {label.item()} (orig: {label.item()+5})" for label in yB_tr_t[:n_amostras]]

mm.show(
    imgs_A + imgs_B,
    titles=titles_A + titles_B,
    cols=n_amostras,
    figsize=(12, 4.5)
)
Figura 9.20: Muestras de los conjuntos de entrenamiento tras preprocesamiento y adecuación dimensional a los tensores PyTorch: Dominio A (dígitos 0 a 4, tarea de origen) y Dominio B (dígitos 5 a 9 reindexados a 0 a 4, tarea de destino).
9.5.1.2.1.2 Bloque 2: Arquitectura Modular y Rutinas Genéricas

Para viabilizar la transferencia de aprendizaje, la arquitectura convolucional y el bucle de entrenamiento fueron refactorizados en relación con la clase CNNDigitos del proyecto anterior.

  1. Modularización de la Arquitectura (Diferencia respecto a CNNDigitos):

    • En el proyecto anterior, la clase CNNDigitos declaraba todas las capas (conv1, conv2, pool, fc1, fc2) como miembros directos de una única clase monolítica.
    • Aquí, la arquitectura se separa en dos componentes: la clase ExtratorConv encapsula el bloque espacial convolucional (\(2\) convoluciones \(3 \times 3\), \(2\) Max-Poolings \(2 \times 2\) y el aplanamiento a \(64\) elementos), mientras que la clase CNNCompleta instancia ese extractor en self.extrator y anexa la “cabeza” clasificadora (fc1 y fc2).
    • Esta separación es lo que permite copiar el estado interno del extractor (state_dict()) de un modelo a otro de forma aislada.
  2. Ajuste en el Número de Clases de Salida: Mientras que CNNDigitos en el proyecto anterior poseía \(10\) logits en la capa de salida (self.fc2 = nn.Linear(32, 10)), la clase CNNCompleta recibe n_classes=5 en el constructor para adecuarse a la división de los dominios \(A\) y \(B\).

  3. Flexibilización del Bucle de Entrenamiento (treinar):

    • En el proyecto anterior, el bucle de entrenamiento iteraba directamente sobre los atributos globales del modelo (modelo_cnn.parameters()) y calculaba métricas específicas en línea.
    • La función treinar abstrae ese proceso e introduce el parámetro opcional parametros. Si se proporciona, el optimizador Adam actualiza solo los parámetros de esa lista, ignorando las capas cuyos gradientes fueron desactivados. Esta flexibilidad es crucial para ejecutar el entrenamiento con congelamiento parcial de la red.
  4. Aislamiento de la Evaluación (calcular_acuracia): Así como se hizo en la fase de prueba del proyecto anterior, la función coloca el modelo en eval() y utiliza el contexto torch.no_grad() para desactivar el autograd, calculando la precisión mediante .argmax(dim=1).

# Definición del bloque convolucional reutilizable (misma extracción del proyecto anterior)
class ExtratorConv(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 8, 3, padding=1)
        self.conv2 = nn.Conv2d(8, 16, 3, padding=1)
        self.pool = nn.MaxPool2d(2, 2)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.pool(self.relu(self.conv1(x)))
        x = self.pool(self.relu(self.conv2(x)))
        return x.view(x.size(0), -1)

# Arquitectura modular que combina el extractor y la cabeza clasificadora
class CNNCompleta(nn.Module):
    def __init__(self, n_classes=5):
        super().__init__()
        self.extrator = ExtratorConv()
        self.fc1 = nn.Linear(64, 32)
        self.fc2 = nn.Linear(32, n_classes)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.extrator(x)
        x = self.relu(self.fc1(x))
        return self.fc2(x)

# Rutina genérica de entrenamiento con optimización selectiva de parámetros
def treinar(modelo, X_t, y_t, epocas, lr, tam_lote=16, parametros=None):
    # Parámetros entrenables
    params = parametros if parametros is not None else modelo.parameters()  
    otim = optim.Adam(params, lr=lr)               # Optimizador Adam
    crit = nn.CrossEntropyLoss()                   # Función de pérdida
    n_amostras = X_t.size(0)                       # Número de muestras
    for _ in range(epocas):                        # Repite por época
        perm = torch.randperm(n_amostras)          # Mezcla muestras
        for i in range(0, n_amostras, tam_lote):   # Recorre mini-lotes
            idx = perm[i:i + tam_lote]             # Índices del lote
            otim.zero_grad()                       # Pon a cero gradientes
            perda = crit(modelo(X_t[idx]), y_t[idx])  # Calcula pérdida
            perda.backward()                       # Retropropagación
            otim.step()                            # Actualiza pesos

# Rutina de evaluación
def calcular_acuracia(modelo, X_t, y_t):
    modelo.eval()                                  # Modo evaluación
    with torch.no_grad():                          # Sin gradientes
        pred = modelo(X_t).argmax(dim=1)           # Clases predichas
    return (pred == y_t).float().mean().item()     # Devuelve precisión
9.5.1.2.1.3 Bloco 3: Preentrenamiento, Transferencia y Análisis Comparativo

Este bloque ejecuta la comparación entre el ajuste del modelo desde cero y la aplicación de la transferencia con congelamiento estático del extractor. Para dar total transparencia al experimento, los tamaños de los conjuntos de entrenamiento y prueba de ambos dominios se imprimen en el terminal.

  1. Cuantificación de las Muestras por Dominio:

    • Dominio A (origen, dígitos \(0\) a \(4\)): Cuenta con \(675\) muestras de entrenamiento (\(75\%\)) y \(226\) de prueba (\(25\%\)), proporcionando datos abundantes para que el modelo_origem aprenda el extractor convolucional hasta alcanzar \(100\%\) de precisión.
    • Dominio B (destino, dígitos \(5\) a \(9\)): Posee \(224\) muestras de prueba en total, pero su conjunto de entrenamiento se reduce intencionalmente de \(672\) a solo \(20\) muestras (XB_tr_poucos), creando un escenario severo de escasez de datos.
  2. Etapa 1: Preentrenamiento en el Dominio A (Origen): El modelo_origem se entrena desde cero sobre las \(675\) muestras de los dígitos \(0\) a \(4\). Durante \(40\) épocas, el extractor convolucional ajusta sus filtros para identificar los rasgos característicos de esos cinco primeros dígitos, alcanzando \(100\%\) de precisión en el conjunto de prueba (\(226\) muestras).

  3. Etapa 2: Transferencia de Pesos y Congelamiento:

    • Se crea el modelo_transferencia para resolver la tarea del Dominio B (dígitos \(5\) a \(9\)).

    • Los pesos aprendidos en el Dominio A se copian mediante:

      • load_state_dict(modelo_origem.extrator.state_dict())
    • Congelamiento: El bucle for p in modelo_transferencia.extrator.parameters(): p.requires_grad = False desactiva el cálculo de gradientes en las capas convolucionales.

    • Entrenamiento Selectivo: La llamada treinar(...) pasa estrictamente los parámetros de las capas densas (params_cabeca), ajustando la cabeza de clasificación con solo las \(20\) muestras de entrenamiento.

  4. Etapa 3: Entrenamiento desde Cero en el Dominio B (Control Experimental): El modelo_do_zero posee la misma arquitectura, pero se entrena desde cero sobre las mismas \(20\) muestras del Dominio B, sin ningún reaprovechamiento de pesos, durante las mismas \(40\) épocas.

  5. Análisis de los Resultados (Figura 9.21):

    • Con Transferencia Congelada (\(72,77\%\)): Al reaprovechar el extractor entrenado en el Dominio A y congelar sus parámetros, la red alcanza \(72,77\%\) de precisión en la prueba (\(224\) muestras) ajustando solo las capas densas.
    • Entrenado desde Cero (\(76,79\%\)): El entrenamiento desde cero supera a la transferencia congelada en el conjunto de prueba del Dominio B.
    • Causa de la Diferencia: Por tratarse de un modelo minúsculo (solo \(16\) filtros convolucionales en matrices de \(8 \times 8\)), el extractor entrenado en el Dominio A se volvió hiperespecializado en las formas geométricas de los dígitos \(0\) a \(4\). Al congelar rígidamente esos pocos filtros, el modelo de destino quedó limitado a detectores inadecuados para \(5\) a \(9\). La red entrenada desde cero, incluso con solo \(20\) muestras, logró adaptar sus \(16\) filtros directamente a los rasgos del Dominio B.
# Fixar semente para reprodutibilidade
torch.manual_seed(42)

# Exibição do tamanho dos grupos de treino e teste
print("=== Detalhamento do Tamanho das Bases ===")
print(f"Domínio A (0-4) — Treino: {len(XA_tr_t)} amostras | Teste: {len(XA_te_t)} amostras")
print(f"Domínio B (5-9) — Treino completo: {len(XB_tr)} | Treino reduzido: {len(XB_tr_poucos)}",
      f"| Teste: {len(XB_te_t)} amostras\n")

# 1. Pré-treinamento na tarefa de origem (Domínio A: dígitos 0-4)
modelo_origem = CNNCompleta(n_classes=5)                       # Cria CNN

#######
treinar(modelo_origem, XA_tr_t, yA_tr_t, epocas=40, lr=1e-2)   # Treina modelo
         
acc_A = calcular_acuracia(modelo_origem, XA_te_t, yA_te_t)     # Mede acurácia
                          
print(f"Acurácia no domínio de origem A "                      # Exibe resultado
      f"(dígitos 0-4, {len(XA_te_t)} testes): " f"{acc_A:.4f}")

# 2. Transferência de Aprendizado (Extrator Congelado)
modelo_transferencia = CNNCompleta(n_classes=5)        # Cria CNN
modelo_transferencia.extrator.load_state_dict(         # Copia extrator
    modelo_origem.extrator.state_dict())

for p in modelo_transferencia.extrator.parameters():   # Percorre extrator
    p.requires_grad = False                            # Congela pesos

params_cabeca = list(modelo_transferencia.fc1.parameters())  # FC1
params_cabeca += list(modelo_transferencia.fc2.parameters()) # +FC2

#######
treinar(modelo_transferencia, XB_tr_t, yB_tr_t,              # Treina cabeça
         epocas=40, lr=1e-2, parametros=params_cabeca)

acc_transferencia = calcular_acuracia(modelo_transferencia, XB_te_t, yB_te_t) # Mede acurácia

# 3. Treinamento do Zero no Domínio B
modelo_do_zero = CNNCompleta(n_classes=5)                     # Cria CNN

#######
treinar(modelo_do_zero, XB_tr_t, yB_tr_t, epocas=40, lr=1e-2) # Treina modelo
         
acc_do_zero = calcular_acuracia(modelo_do_zero,  XB_te_t, yB_te_t) # Mede acurácia
                               

print(f"Domínio de destino B (dígitos 5-9), apenas {len(XB_tr_poucos)} ", 
      f"exemplos de treino ({len(XB_te_t)} testes):")
print(f"  Com transferência (extrator congelado): {acc_transferencia:.4f}")
print(f"  Treinando do zero (mesmos dados/épocas): {acc_do_zero:.4f}")

# Visualização comparativa
plt.figure(figsize=(4.5, 4))
plt.bar(["Do zero", "Transferência"], [acc_do_zero, acc_transferencia], 
        color=["#dc2626", "#16a34a"])
plt.ylim(0, max([acc_do_zero, acc_transferencia]) + 0.1)
plt.ylabel("Acurácia no domínio B (teste)")
plt.title(f"Efeito da Transferência ({len(XB_tr_poucos)} exemplos de treino)")

for i, v in enumerate([acc_do_zero, acc_transferencia]):
    plt.text(i, v + 0.02, f"{v:.3f}", ha="center")

plt.tight_layout()
plt.show()
=== Detalhamento do Tamanho das Bases ===
Domínio A (0-4) — Treino: 675 amostras | Teste: 226 amostras
Domínio B (5-9) — Treino completo: 672 | Treino reduzido: 20 | Teste: 224 amostras

Acurácia no domínio de origem A (dígitos 0-4, 226 testes): 1.0000
Domínio de destino B (dígitos 5-9), apenas 20  exemplos de treino (224 testes):
  Com transferência (extrator congelado): 0.7277
  Treinando do zero (mesmos dados/épocas): 0.7679
Figura 9.21: Comparação de acurácia no conjunto de teste do Domínio B (dígitos 5 a 9) sob restrição de dados (20 exemplos de treino): demonstração do impacto do congelamento rígido e da transferência negativa em redes de baixa capacidade.
9.5.1.2.1.4 Bloco 4: Visualización del Flujo de Activaciones con mm.showNet

Para confirmar que la extracción de características reutilizada preserva las transformaciones dimensionales estudiadas en el proyecto anterior, se utiliza nuevamente la función mm.showNet de la biblioteca morph. La Figura 9.22 muestra el flujo de activaciones del modelo_transferencia al procesar una muestra del Dominio B (dígito \(7\), reindexado a la clase \(2\)).

  1. Preservación del Flujo Convolucional: Dado que la arquitectura ExtratorConv replica las mismas capas de convolución y pooling de la CNNDigitos del proyecto anterior, las dimensiones de los tensores intermedios se mantienen en \((1, 8, 4, 4)\) en el primer bloque.
  2. Inspección de la Cabeza Adaptada: La diferencia respecto al proyecto anterior surge en la capa de salida (fc2): mientras que el modelo del proyecto anterior proyectaba el vector intermedio en \(10\) logits (clases de \(0\) a \(9\)), el modelo de transferencia proyecta el vector en \(5\) logits (clases de \(0\) a \(4\)), capturando las probabilidades relativas del Dominio B.
# Selecciona la primera muestra de prueba del Dominio B
x_amostra_B = XB_te_t[0:1]  # Tensor de dimensión (1, 1, 8, 8)
classe_verdadeira = yB_te_t[0].item()
classe_original = classe_verdadeira + 5

# Inspección del flujo de activaciones en el modelo de transferencia
acts_transfer = mm.showNet(
    modelo_transferencia,
    x_amostra_B,
    titulo="Fluxo de ativações no modelo de transferência (Domínio B)",
    subtitulo=f"Amostra do dígito {classe_original} (rótulo reindexado: {classe_verdadeira})",
)

print("Capas capturadas en el modelo de transferencia:\n", list(acts_transfer.keys()))
Figura 9.22: Flujo de activaciones y transformaciones dimensionales de los tensores en el modelo de transferencia de aprendizaje al procesar una muestra de prueba del Dominio B (dígito 7, reindexado a clase 2).
Capas capturadas en el modelo de transferencia:
 ['extrator.conv1', 'extrator.pool', 'extrator.conv2', 'extrator.pool #2', 'fc1', 'fc2']
9.5.1.2.1.5 Análisis del Experimento 1

El modelo entrenado desde cero alcanza una exactitud superior al modelo con transferencia de aprendizaje y extractor congelado. Este resultado caracteriza un caso de transferencia negativa (negative transfer) y se debe a tres factores:

  1. Baja capacidad: El extractor posee únicamente \(16\) filtros \(3 \times 3\), insuficientes para aprender representaciones generalizables.

  2. Especialización en el dominio: El entrenamiento con los dígitos \(0\) a \(4\) produce filtros poco discriminativos para los dígitos \(5\) a \(9\).

  3. Ausencia de adaptación: El congelamiento impide que el extractor ajuste sus filtros a la nueva tarea.

Nota💡 Provocación Pedagógica

Este experimento utiliza un extractor pequeño entrenado en un dominio restringido. ¿El resultado sería diferente si el extractor hubiera aprendido sus representaciones en una base con millones de imágenes y gran diversidad de objetos?

9.5.1.2.2 Experimento 2 — Cuando la Transferencia Realmente Funciona (ResNet-18 Preentrenada)

El segundo experimento repite la misma estructura del primero — pocos ejemplos de entrenamiento, dos clases, comparación entre estrategias —, pero cambia el extractor artesanal de \(16\) filtros por la ResNet-18, una arquitectura de \(18\) capas preentrenada en ImageNet (\(1,4\) millones de imágenes, \(1.000\) categorías), y el dataset sintético de dígitos por fotografías reales del Oxford-IIIT Pet Dataset (PARKHI, 2012).

La tarea: distinguir dos razas caninas — Pug y Boxer — a partir de solo \(15\) fotografías de entrenamiento por clase.

Tip🐶 ¿Por qué este escenario?

El desafío aquí no es la similitud visual entre las razas — Pug y Boxer tienen portes y proporciones bien distintas —, sino la escasez de datos: apenas \(30\) fotografías reales en total, sin ninguna imagen sintética. Es el tipo de problema de bajo presupuesto de datos que motiva, en la práctica, el uso de redes preentrenadas: no hay tiempo ni recursos para fotografiar y etiquetar miles de perros antes de entrenar un clasificador desde cero.

9.5.1.2.2.1 Bloco 1: Carga del Dataset Real y Muestreo Disperso
  1. Fuente: el Oxford-IIIT Pet Dataset (PARKHI, 2012) se carga a través de torchvision.datasets.OxfordIIITPet, que descarga automáticamente las \(7.349\) fotografías y sus etiquetas de raza en la primera ejecución.
  2. Filtrado: solo se mantienen las dos razas de interés (Pug, Boxer).
  3. Escasez deliberada: solo se sortean \(15\) fotografías de entrenamiento por clase (\(30\) en total) — el resto compone el conjunto de prueba, utilizado exclusivamente para evaluación.

La Figura 9.23 muestra muestras de entrenamiento de cada raza.

import random

RACAS_ALVO = ["Pug", "Boxer"]
N_TREINO_POR_CLASSE = 15
N_TESTE_POR_CLASSE = 20

# 1. Descarga del dataset completo (37 razas) — licencia CC BY-SA 4.0
pets_completo = OxfordIIITPet(
    root="dados_pets", split="trainval", target_types="category", download=True
)
nomes_racas = pets_completo.classes
indices_alvo = [nomes_racas.index(r) for r in RACAS_ALVO]

# 2. Filtrado de las dos razas de interés, separadas por clase
por_classe = {idx: [] for idx in indices_alvo}
for img, lbl in pets_completo:
    if lbl in indices_alvo:
        por_classe[lbl].append(img)

# 3. Muestreo: pocas imágenes de entrenamiento, más imágenes de prueba
rng = random.Random(42)
imgs_treino, y_treino, imgs_teste, y_teste = [], [], [], []
for classe_idx, idx_original in enumerate(indices_alvo):
    imgs_raca = por_classe[idx_original][:]
    rng.shuffle(imgs_raca)
    imgs_treino += imgs_raca[:N_TREINO_POR_CLASSE]
    y_treino += [classe_idx] * N_TREINO_POR_CLASSE
    imgs_teste += imgs_raca[N_TREINO_POR_CLASSE : N_TREINO_POR_CLASSE + N_TESTE_POR_CLASSE]
    y_teste += [classe_idx] * N_TESTE_POR_CLASSE

print(f"Entrenamiento: {len(imgs_treino)} imágenes | Prueba: {len(imgs_teste)} imágenes")

amostras_pil = imgs_treino[:4] + imgs_treino[N_TREINO_POR_CLASSE:N_TREINO_POR_CLASSE + 4]
amostras_exibicao = [np.array(img.convert("RGB")) for img in amostras_pil]  # PIL -> ndarray
titulos_exibicao = [RACAS_ALVO[0]] * 4 + [RACAS_ALVO[1]] * 4
mm.show(amostras_exibicao, titles=titulos_exibicao, cols=4, figsize=(11, 6))
Figura 9.23
9.5.1.2.2.2 Bloco 2: Tres Estrategias sobre la Misma Arquitectura

Para aislar el efecto de la transferencia de aprendizaje, las tres estrategias reutilizan exactamente la misma arquitectura (ResNet-18), variando únicamente el origen de los pesos y qué parámetros permanecen entrenables:

  1. do_zero: pesos aleatorios (weights=None) — equivalente a entrenar la arquitectura de la ResNet-18 enteramente desde cero, como en el Bloque 2 del Experimento 1.
  2. congelado: pesos preentrenados en ImageNet, con requires_grad = False en todas las capas convolucionales — solo la nueva capa final se entrena.
  3. fine_tuning: pesos preentrenados en ImageNet como punto de partida, pero sin congelamiento — toda la red se ajusta al nuevo dominio, con una tasa de aprendizaje baja para no destruir el conocimiento previo.

En todos los casos, la capa final fc se reemplaza por nn.Linear(fc.in_features, 2), correspondiente a las dos razas de destino.

transformacao_resnet = T.Compose([
    T.Resize((224, 224)),
    T.ToTensor(),
    T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

def prepara_tensores(imgs, labels):
    X = torch.stack([transformacao_resnet(img.convert("RGB")) for img in imgs])
    y = torch.tensor(labels, dtype=torch.long)
    return X, y

X_tr, y_tr = prepara_tensores(imgs_treino, y_treino)
X_te, y_te = prepara_tensores(imgs_teste, y_teste)

def cria_modelo_pets(estrategia):
    pesos = None if estrategia == "do_zero" else models.ResNet18_Weights.DEFAULT
    modelo = models.resnet18(weights=pesos)
    if estrategia == "congelado":
        for p in modelo.parameters():
            p.requires_grad = False
    modelo.fc = nn.Linear(modelo.fc.in_features, len(RACAS_ALVO))
    return modelo

modelo_do_zero = cria_modelo_pets("do_zero")
modelo_congelado = cria_modelo_pets("congelado")
modelo_fine_tuning = cria_modelo_pets("fine_tuning")
9.5.1.2.2.3 Bloque 3: Entrenamiento Comparativo y Análisis de Precisión

Reutilizando las funciones genéricas treinar y calcular_acuracia, definidas en el Bloque 2 del Experimento 1, los tres modelos se entrenan sobre el mismo conjunto de \(30\) fotografías y se evalúan en el conjunto de prueba (imágenes nunca vistas durante el entrenamiento):

  • El modelo do_zero tiende a sobreajustarse rápidamente a las \(30\) fotografías de entrenamiento, sin generalizar al conjunto de prueba — \(30\) ejemplos son drásticamente insuficientes para ajustar los \(11\) millones de parámetros de la ResNet-18 desde cero.
  • El modelo congelado ya debería alcanzar una precisión considerablemente superior, ya que reutiliza, sin ningún ajuste, características visuales genéricas (bordes, texturas, contornos) aprendidas en ImageNet — solo la nueva capa lineal necesita ajustarse a las \(30\) fotografías.
  • El modelo fine_tuning tiende a igualar o superar al extractor congelado, ya que parte del mismo conocimiento previo, pero aún permite un ajuste fino de toda la red a las particularidades visuales de las razas.

La Figura 9.24 resume los tres resultados.

torch.manual_seed(42)

configuracoes = [
    ("Do zero",              modelo_do_zero,      None, 2e-3),
    ("Extrator congelado",   modelo_congelado,    "fc", 1e-3),
    ("Fine-tuning completo", modelo_fine_tuning,  None, 1e-4),
]

resultados_pets = {}
for nome, modelo, alvo_params, taxa in configuracoes:
    parametros = modelo.fc.parameters() if alvo_params == "fc" else None
    treinar(modelo, X_tr, y_tr, epocas=15, lr=taxa, tam_lote=8, parametros=parametros)
    resultados_pets[nome] = calcular_acuracia(modelo, X_te, y_te)
    print(f"{nome}: {resultados_pets[nome]*100:.1f}%")

plt.figure(figsize=(5.5, 4))
cores = ["#dc2626", "#f59e0b", "#16a34a"]
plt.bar(resultados_pets.keys(), resultados_pets.values(), color=cores)
plt.ylim(0, 1.05)
plt.axhline(0.5, color="gray", linestyle="--", linewidth=1, label="Chute aleatório (50%)")
plt.ylabel("Acurácia no teste")
plt.title("Pug vs. Boxer — 15 fotos de treino/classe")
for i, v in enumerate(resultados_pets.values()):
    plt.text(i, v + 0.02, f"{v*100:.1f}%", ha="center")
plt.xticks(rotation=10)
plt.legend()
plt.tight_layout()
plt.show()
Figura 9.24
9.5.1.2.2.4 Bloque 4: Inspección Cualitativa de las Predicciones

Como en el Experimento 1 y en la sección siguiente sobre diagnóstico foliar, es instructivo observar individualmente algunas predicciones del mejor modelo (típicamente fine_tuning o congelado) sobre fotografías reales de prueba, comparando la etiqueta prevista con la raza real.

melhor_modelo = modelo_fine_tuning  # o modelo_congelado, según el resultado del Bloque 3
melhor_modelo.eval()

idx_amostras = list(range(4)) + list(range(N_TESTE_POR_CLASSE, N_TESTE_POR_CLASSE + 4))

imgs_pred, titulos_pred = [], []
with torch.no_grad():
    for idx in idx_amostras:
        entrada = X_te[idx].unsqueeze(0)
        pred_idx = melhor_modelo(entrada).argmax(dim=1).item()
        real_idx = y_te[idx].item()
        marcador = "✓" if pred_idx == real_idx else "✗"
        imgs_pred.append(np.array(imgs_teste[idx].convert("RGB")))  # PIL -> ndarray
        titulos_pred.append(f"{marcador} previsto: {RACAS_ALVO[pred_idx]}\n"
                             f"real: {RACAS_ALVO[real_idx]}")

mm.show(imgs_pred, titles=titulos_pred, cols=4, figsize=(12, 7))
Figura 9.25
# Limpieza explícita de los datos descargados y liberación de memoria
if FLAG_LIMPAR_DADOS:
    if os.path.exists('./dados_pets'):
        shutil.rmtree('./dados_pets')
        print('🧹 Directorio de datos temporales ./dados_pets eliminado con éxito.')

    if torch.cuda.is_available():
        torch.cuda.empty_cache()
9.5.1.2.3 Experimento 3 — Diagnóstico Fitosanitario con Transferencia de Aprendizaje

El experimento anterior mostró que una ResNet-18 preentrenada en ImageNet puede adaptarse a una nueva tarea utilizando pocas muestras. Ahora, la misma estrategia se aplica a un problema de diagnóstico fitosanitario. La ResNet-18 debe clasificar imágenes de hojas en tres categorías: ["folha_saudavel", "folha_doente", "sintoma_desconhecido"].

  • folha_saudavel: hoja sin lesiones visibles.
  • folha_doente: hoja con manchas oscuras que simulan una enfermedad fúngica.
  • sintoma_desconhecido: hoja con clorosis amarillenta, que representa un patrón diferente de la enfermedad conocida.
Tip🌱 ¿Por qué este escenario?

El diagnóstico fitosanitario constituye una importante aplicación de la VC en la agricultura de precisión. Un modelo preentrenado en ImageNet puede reutilizar características como bordes, texturas y patrones de color para aprender esta nueva tarea con pocas imágenes.

9.5.1.2.3.1 Bloque 1: Generación del Dataset Sintético

Este bloque genera un conjunto sintético con 30 imágenes por clase para entrenamiento y 8 para validación, totalizando 90 y 24 imágenes, respectivamente.

  1. Generación de la hoja: La función desenha_folha_base crea el contorno de la hoja, variando tamaño, orientación y tonalidad de verde.

  2. Simulación de la enfermedad: La función aplica_manchas_doenca añade manchas oscuras irregulares que simulan lesiones fúngicas.

  3. Simulación de otro síntoma: La función aplica_sintoma_desconhecido añade regiones amarillentas que representan un patrón distinto de la enfermedad conocida.

  4. Visualización de las muestras: La Figura 9.26 presenta ejemplos de las tres categorías del conjunto sintético.

CLASSES_FOLHA = ["folha_saudavel", "folha_doente", "sintoma_desconhecido"]


def desenha_folha_base(tam_img, rng):
    '''Dibuja el contorno oval de una hoja verde con nervadura central,
    con pequeñas variaciones de tono, tamaño y orientación entre muestras.'''
    img = np.full((tam_img, tam_img, 3), 245, dtype=np.uint8)  # fondo claro
    cx, cy = tam_img // 2, tam_img // 2
    eixo_a = rng.randint(int(tam_img * 0.30), int(tam_img * 0.38))
    eixo_b = rng.randint(int(tam_img * 0.20), int(tam_img * 0.26))
    angulo = rng.uniform(-15, 15)
    verde = (rng.randint(40, 70), rng.randint(120, 160), rng.randint(40, 70))
    cv2.ellipse(img, (cx, cy), (eixo_a, eixo_b), angulo, 0, 360, verde, -1, cv2.LINE_AA)
    ang_rad = np.deg2rad(angulo)
    dx, dy = np.cos(ang_rad), np.sin(ang_rad)
    p1 = (int(cx - eixo_a * dx), int(cy - eixo_a * dy))
    p2 = (int(cx + eixo_a * dx), int(cy + eixo_a * dy))
    cv2.line(img, p1, p2, (25, 90, 25), 2, cv2.LINE_AA)  # nervadura central
    return img, (cx, cy, eixo_a, eixo_b, angulo)


def aplica_manchas_doenca(img, centro_folha, rng, n_manchas=(4, 8)):
    '''Simula lesiones foliares: manchas oscuras de bordes irregulares
    (patrón típico de enfermedades fúngicas).'''
    cx, cy, eixo_a, eixo_b, _ = centro_folha
    for _ in range(rng.randint(*n_manchas)):
        raio = rng.randint(1, 3)
        px = cx + rng.randint(-int(eixo_a * 0.7), int(eixo_a * 0.7))
        py = cy + rng.randint(-int(eixo_b * 0.7), int(eixo_b * 0.7))
        cor_mancha = (rng.randint(50, 90), rng.randint(25, 45), rng.randint(10, 25))
        cv2.circle(img, (px, py), raio, cor_mancha, -1, cv2.LINE_AA)
        cv2.circle(img, (px, py), raio + 1, (120, 85, 30), 1, cv2.LINE_AA)  # halo
    return img


def aplica_sintoma_desconhecido(img, centro_folha, rng):
    '''Simula un patrón distintivo (moteado amarillento/clorosis), diferente
    de las manchas oscuras de la enfermedad conocida.'''
    cx, cy, eixo_a, eixo_b, _ = centro_folha
    for _ in range(rng.randint(3, 5)):
        eixo_m = (rng.randint(1, 3), rng.randint(2, 3))
        px = cx + rng.randint(-int(eixo_a * 0.6), int(eixo_a * 0.6))
        py = cy + rng.randint(-int(eixo_b * 0.6), int(eixo_b * 0.6))
        cor_clorose = (rng.randint(200, 235), rng.randint(195, 225), rng.randint(50, 90))
        ang_m = rng.uniform(0, 180)
        cv2.ellipse(img, (px, py), eixo_m, ang_m, 0, 360, cor_clorose, -1, cv2.LINE_AA)
    return img


def aplica_ruido_sal_pimenta(img, prop_ruido=0.02, rng=None):
    '''Aplica ruido sal (puntos blancos) y pimienta (puntos negros) aleatorios.
    prop_ruido: fracción de píxeles alterados (ej: 0.02 = 2% de los píxeles).'''
    if prop_ruido <= 0:
        return img
    
    img_ruido = img.copy()
    num_pixels = int(prop_ruido * img.shape[0] * img.shape[1])
    n_sal = num_pixels // 2
    n_pimenta = num_pixels - n_sal

    # Aplica Sal (Blanco - [255, 255, 255])
    for _ in range(n_sal):
        y = rng.randint(0, img.shape[0] - 1)
        x = rng.randint(0, img.shape[1] - 1)
        img_ruido[y, x] = [255, 255, 255]

    # Aplica Pimienta (Negro - [0, 0, 0])
    for _ in range(n_pimenta):
        y = rng.randint(0, img.shape[0] - 1)
        x = rng.randint(0, img.shape[1] - 1)
        img_ruido[y, x] = [0, 0, 0]

    return img_ruido


def gera_folha(classe_idx, tam_img=128, rng=None, prop_ruido=0.02):
    rng = rng or random.Random()
    img, geometria = desenha_folha_base(tam_img, rng)
    nome = CLASSES_FOLHA[classe_idx]
    
    if nome == "folha_doente":
        img = aplica_manchas_doenca(img, geometria, rng)
    elif nome == "sintoma_desconhecido":
        img = aplica_sintoma_desconhecido(img, geometria, rng)
        
    ruido_exp = rng.randint(-3, 3)  # leve variación de exposición
    img = np.clip(img.astype(np.int16) + ruido_exp, 0, 255).astype(np.uint8)
    
    # Aplicación del ruido Sal y Pimienta
    img = aplica_ruido_sal_pimenta(img, prop_ruido=prop_ruido, rng=rng)
    
    return img


def gera_conjunto(n_por_classe, tam_img=128, seed=0, prop_ruido=0.02):
    rng = random.Random(seed)
    imgs, labels = [], []
    for classe_idx in range(len(CLASSES_FOLHA)):
        for _ in range(n_por_classe):
          imgs.append(gera_folha(classe_idx, tam_img=tam_img, rng=rng, prop_ruido=prop_ruido))
          labels.append(classe_idx)
    return imgs, labels


N_POR_CLASSE_TREINO, N_POR_CLASSE_VAL = 30, 8

imgs_treino, labels_treino = gera_conjunto(n_por_classe=N_POR_CLASSE_TREINO, seed=42, 
                                           prop_ruido=0.02)
imgs_val, labels_val = gera_conjunto(n_por_classe=N_POR_CLASSE_VAL, seed=123, prop_ruido=0.02)

print(f"Entrenamiento: {len(imgs_treino)} imágenes ({N_POR_CLASSE_TREINO} por clase) | "
      f"Validación: {len(imgs_val)} imágenes ({N_POR_CLASSE_VAL} por clase)")

# Visualización de 2 muestras de cada clase (6 imágenes en total)
amostras_exibir, titulos_exibir = [], []
for classe_idx, nome in enumerate(CLASSES_FOLHA):
    for k in range(2):
        idx = classe_idx * N_POR_CLASSE_TREINO + k
        amostras_exibir.append(imgs_treino[idx])
        titulos_exibir.append(nome)

mm.show(amostras_exibir, titles=titulos_exibir, cols=3, figsize=(10, 7))
Entrenamiento: 90 imágenes (30 por clase) | Validación: 24 imágenes (8 por clase)
Figura 9.26: Muestras sintéticas del dataset de diagnóstico foliar: hoja sana, hoja enferma (manchas oscuras) y síntoma desconocido (clorosis amarillenta) con ruido sal y pimienta.
Nota🧠 Trampa Común

La transferencia de aprendizaje exige que cada clase presente patrones visuales distintos. Repetir la misma imagen con etiquetas diferentes impide que la capa clasificadora aprenda una frontera de decisión, pues el extractor genera prácticamente las mismas características para todas las muestras.

En este experimento, cada imagen se genera de forma independiente, con patrones visuales compatibles con su clase (hoja sana, lesiones fúngicas o clorosis), proporcionando información suficiente para el entrenamiento de la capa clasificadora.

9.5.1.2.3.2 Bloque 2: Preparación de los Tensores y Adaptación de la Arquitectura

Modelos como la ResNet-18 requieren imágenes en color de \(224 \times 224\) píxeles normalizadas según las estadísticas de ImageNet (\(\mu = [0,485; 0,456; 0,406]\) y \(\sigma = [0,229; 0,224; 0,225]\)).

  1. Transformación de Entrada (transforms.Compose): se aplica el redimensionamiento y la normalización estándar a cada imagen del dataset sintético, produciendo los tensores X_treino/X_val y las etiquetas y_treino/y_val — cada ejemplo es una imagen genuinamente distinta, asociada a la etiqueta correcta de su clase.
  2. Congelamiento del Extractor: el bucle for p in modelo_resnet.parameters(): p.requires_grad = False desactiva los gradientes en las capas convolucionales preentrenadas.
  3. Nueva Capa Final: la capa modelo_resnet.fc se sustituye por una nueva instancia nn.Linear(modelo_resnet.fc.in_features, n_classes_destino), recién inicializada y con gradientes activos por defecto. El número de características de entrada se obtiene dinámicamente a partir de la propia capa original (in_features, igual a \(512\) en la ResNet-18), en lugar de fijarse manualmente en el código — práctica recomendada, ya que hace que el fragmento sea reutilizable para otras variantes de la arquitectura sin modificaciones.
# 1. Pipeline de transformaciones esperadas por la ResNet
transformacao_resnet = T.Compose([
    T.Resize((224, 224)),
    T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])


def prepara_tensores(imgs, labels):
    tensores = [transformacao_resnet(T.functional.to_tensor(img)) for img in imgs]
    X = torch.stack(tensores)
    y = torch.tensor(labels, dtype=torch.long)
    return X, y


# 2. Conversión del dataset sintético (Bloque 1) en tensores normalizados
X_treino, y_treino = prepara_tensores(imgs_treino, labels_treino)
X_val, y_val = prepara_tensores(imgs_val, labels_val)

loader_treino = DataLoader(TensorDataset(X_treino, y_treino), batch_size=16, shuffle=True)
loader_val = DataLoader(TensorDataset(X_val, y_val), batch_size=16, shuffle=False)

# 3. Carga de la ResNet-18 preentrenada y congelamiento del extractor
n_classes_destino = len(CLASSES_FOLHA)
modelo_resnet = models.resnet18(weights=models.ResNet18_Weights.DEFAULT)

for parametro in modelo_resnet.parameters():
    parametro.requires_grad = False

# 4. Sustitución de la capa final para las 3 nuevas clases de destino
modelo_resnet.fc = nn.Linear(modelo_resnet.fc.in_features, n_classes_destino)

print(f"Nueva capa final: {modelo_resnet.fc}")
9.5.1.2.3.3 Bloco 3: Bucle de Entrenamiento y Evaluación

Con el extractor congelado y la nueva capa de salida debidamente acoplada, se ejecuta el ajuste fino (fine-tuning) de la nueva cabeza de clasificación.

  1. Optimización Enfocada: el optimizador Adam recibe estrictamente modelo_resnet.fc.parameters(), actualizando únicamente la nueva capa de salida — el resto de la red permanece congelado, según lo definido en el Bloco 2.
  2. Ejecución del Bucle: en cada época, el modelo itera sobre los lotes de entrenamiento, calcula la pérdida por Entropía Cruzada y ajusta los pesos de la capa final; a continuación, se evalúa la precisión en el conjunto de validación (imágenes nunca vistas durante el entrenamiento).
  3. Curvas de Entrenamiento: la Figura 9.27 acompaña la evolución de la pérdida de entrenamiento y de la precisión de validación a lo largo de las épocas — como las tres clases son visualmente distintas entre sí, se espera una convergencia genuina, muy por encima del umbral de \(33\%\) correspondiente a una elección aleatoria entre \(3\) clases.
dispositivo = torch.device("cuda" if torch.cuda.is_available() else "cpu")
modelo_resnet = modelo_resnet.to(dispositivo)

criterio = nn.CrossEntropyLoss()
otimizador = optim.Adam(modelo_resnet.fc.parameters(), lr=1e-3)

historico_perda, historico_acc = [], []
epocas = 10

for epoca in range(epocas):
    modelo_resnet.train()
    perda_acumulada, n_batches = 0.0, 0

    for X_batch, y_batch in loader_treino:
        X_batch, y_batch = X_batch.to(dispositivo), y_batch.to(dispositivo)

        otimizador.zero_grad()
        saidas = modelo_resnet(X_batch)
        perda = criterio(saidas, y_batch)
        perda.backward()
        otimizador.step()

        perda_acumulada += perda.item()
        n_batches += 1
    historico_perda.append(perda_acumulada / n_batches)

    modelo_resnet.eval()
    acertos, total = 0, 0
    with torch.no_grad():
        for X_batch, y_batch in loader_val:
            X_batch, y_batch = X_batch.to(dispositivo), y_batch.to(dispositivo)
            predicoes = modelo_resnet(X_batch).argmax(dim=1)
            acertos += (predicoes == y_batch).sum().item()
            total += y_batch.size(0)
    acc = acertos / total
    historico_acc.append(acc)

    print(f"Época {epoca+1}/{epocas} — pérdida: {historico_perda[-1]:.4f} — ",
          f" precisión_val: {acc*100:.1f}%")

f=mm.showTrainCurves(
    historico_perda, historico_acc,
    titulo="Fine-Tuning da ResNet-18 — Diagnóstico Foliar",
    subtitulo="Apenas a nova camada linear (fc) é treinada; o extrator permanece congelado",
)
Figura 9.27
9.5.1.2.3.4 Bloque 4: Inspección Cualitativa de las Predicciones

Además de la curva de precisión agregada, resulta instructivo observar individualmente algunas predicciones del modelo sobre el conjunto de validación, comparando la etiqueta prevista con la etiqueta real. La Figura 9.28 muestra dos muestras de cada clase.

modelo_resnet.eval()

# Dos muestras de cada clase en el conjunto de validación
idx_amostras = [0, N_POR_CLASSE_VAL, 2 * N_POR_CLASSE_VAL,
                1, N_POR_CLASSE_VAL + 1, 2 * N_POR_CLASSE_VAL + 1]

imgs_pred, titulos_pred = [], []
with torch.no_grad():
    for idx in idx_amostras:
        entrada = X_val[idx].unsqueeze(0).to(dispositivo)
        pred_idx = modelo_resnet(entrada).argmax(dim=1).item()
        real_idx = y_val[idx].item()
        marcador = "✓" if pred_idx == real_idx else "✗"
        imgs_pred.append(imgs_val[idx])
        titulos_pred.append(f"{marcador} previsto: {CLASSES_FOLHA[pred_idx]}\n"+
                            f"real: {CLASSES_FOLHA[real_idx]}")

mm.show(imgs_pred, titles=titulos_pred, cols=3, figsize=(10, 7))
Figura 9.28
9.5.1.2.3.5 Análisis del Experimento 3

La ResNet-18 alcanza una alta precisión incluso utilizando un conjunto reducido de imágenes sintéticas. Este resultado muestra que las representaciones aprendidas en ImageNet siguen siendo útiles en un dominio completamente diferente, requiriendo solo la adaptación de la capa clasificadora.

El experimento también ilustra una situación común en aplicaciones reales, en las cuales la disponibilidad de datos etiquetados es limitada. En estos escenarios, la transferencia de aprendizaje reduce el tiempo de entrenamiento y permite obtener modelos con buen rendimiento incluso sin entrenar toda la red.

Nota🧠 Síntesis Comparativa — ¿Cuándo Funciona la Transferencia de Aprendizaje?

Los tres experimentos muestran que la transferencia de aprendizaje depende de la capacidad de generalización del extractor de características.

  • Experimento 1: un extractor pequeño, entrenado en un dominio restringido, aprende representaciones poco generalizables y puede producir transferencia negativa.

  • Experimento 2: una ResNet-18 preentrenada en ImageNet transfiere representaciones generales a una tarea de clasificación de razas de perros y gatos, alcanzando una alta precisión con pocas muestras.

  • Experimento 3: la misma estrategia adapta el modelo a un problema de diagnóstico fitosanitario, mostrando que un único extractor puede servir como base para diferentes dominios de aplicación.

9.5.1.2.4 Comparativo de los Enfoques de Transferencia

La Tabla 9.2 resume los resultados obtenidos en los tres experimentos.

Tabla 9.2: Comparación entre los tres escenarios de transferencia de aprendizaje presentados en esta sección.
Aspecto Experimento 1 Experimento 2 Experimento 3
Extractor CNN pequeña ResNet-18 ResNet-18
Entrenamiento del extractor Dígitos (\(0\)–\(4\)) ImageNet ImageNet
Capacidad de generalización Baja Alta Alta
Nueva tarea Dígitos (\(5\)–\(9\)) Razas de perros y gatos Diagnóstico fitosanitario
Resultado Transferencia negativa Transferencia positiva Transferencia positiva

9.5.2 Detección de Objetos

Los experimentos anteriores mostraron cómo la transferencia de aprendizaje adapta modelos preentrenados para tareas de clasificación de imágenes. El mismo principio también fundamenta arquitecturas de detección de objetos, en las cuales un extractor de características preentrenado proporciona representaciones visuales generales, mientras que módulos especializados localizan y clasifican los objetos en la imagen.

Las próximas secciones presentan la Faster R-CNN como ejemplo de detector preentrenado utilizado directamente para inferencia y, a continuación, un experimento completo de ajuste fino con la arquitectura YOLO.

9.5.2.1 Faster R-CNN: Detector Preentrenado

La detección de objetos extiende el uso de modelos preentrenados a una tarea más compleja que la clasificación. La Faster R-CNN utiliza una CNN preentrenada, como la ResNet-50, como extractor de características (backbone) y añade módulos especializados para localizar y clasificar objetos.

Sobre este extractor, la arquitectura incorpora dos “cabezas” principales:

  • Region Proposal Network (RPN): propone regiones de la imagen con alta probabilidad de contener objetos.
  • Cabeza clasificadora: refina esas regiones, asigna una clase a cada objeto y ajusta sus cajas delimitadoras.

El siguiente código utiliza una Faster R-CNN con pesos preentrenados en COCO para detectar objetos en una imagen, produciendo sus clases, coordenadas y puntuaciones de confianza.

Nota🔍 ¿Dónde está la transferencia de aprendizaje aquí?

A diferencia de los experimentos anteriores, este ejemplo no realiza ajuste fino (fine-tuning). El modelo ejecuta únicamente la inferencia (eval()), reutilizando directamente los pesos del backbone, de la RPN y de la cabeza clasificadora entrenados en COCO.

La adaptación a un nuevo dominio exigiría reemplazar la capa box_predictor por una nueva cabeza de clasificación, compatible con las clases de la aplicación, y entrenarla sobre un conjunto de imágenes anotadas. Este procedimiento sigue el mismo principio presentado en la sección de transferencia de aprendizaje y constituye el flujo habitual para aplicaciones específicas, como detección de plagas, defectos de fabricación o vehículos.

  1. Categorías de COCO: El código recupera los nombres de las clases a partir de las meta-informaciones de los pesos (FasterRCNN_ResNet50_FPN_Weights.DEFAULT.meta["categories"]). Aunque esta lista contenga \(91\) entradas por razones históricas del formato de anotación de COCO, solo \(80\) corresponden a categorías de objetos.

  2. Inferencia: La imagen cargada por mm.read() se convierte en tensor y se procesa mediante el modelo en modo de evaluación (eval()). El código mantiene únicamente las detecciones con confianza superior a \(80\%\).

  3. Anotación de la imagen: Para cada objeto detectado, el código dibuja la caja delimitadora (cv2.rectangle) y escribe la clase predicha y su confianza (cv2.putText).

  4. Visualización: La Figura 9.29 presenta la imagen anotada con las detecciones realizadas por el modelo.

# 1. Carga de la imagen y de los nombres de las categorías del COCO
url_imagem = "https://raw.githubusercontent.com/pytorch/hub/master/images/dog.jpg"
url_imagem = "http://images.cocodataset.org/val2017/000000039769.jpg"
img = mm.read(url_imagem)

pesos_coco = FasterRCNN_ResNet50_FPN_Weights.DEFAULT
categorias_coco = pesos_coco.meta["categories"]  # Mapeo índice -> nombre de la clase

# 2. Carga del modelo Faster R-CNN preentrenado
modelo_detection = fasterrcnn_resnet50_fpn(weights=pesos_coco).eval()

# 3. Ejecución de la inferencia sin cálculo de gradientes
with torch.no_grad():
    predicao = modelo_detection([to_tensor(img)])[0]

# 4. Filtrado de las detecciones con confianza superior al 80%
limiar_confianca = 0.8
mascara_confianca = predicao["scores"] >= limiar_confianca

caixas_filtradas = predicao["boxes"][mascara_confianca].numpy()
scores_filtrados = predicao["scores"][mascara_confianca].numpy()
labels_filtrados = predicao["labels"][mascara_confianca].numpy()

img_com_caixas = img.copy()

# 5. Dibujo de las cajas delimitadoras y de las etiquetas de clase
for box, score, label_idx in zip(caixas_filtradas, scores_filtrados, labels_filtrados):
    x1, y1, x2, y2 = box.astype(int)
    nome_classe = categorias_coco[label_idx]
    texto_rotulo = f"{nome_classe}: {score:.2f}"

    # Dibuja el rectángulo rojo (RGB: 255, 0, 0) con un grosor de 3 píxeles
    cv2.rectangle(img_com_caixas, (x1, y1), (x2, y2), (255, 0, 0), 3)

    # Escribe la clase y la confianza encima de la caja delimitadora
    cv2.putText(
        img_com_caixas,
        texto_rotulo,
        (x1, max(y1 - 10, 20)),
        cv2.FONT_HERSHEY_SIMPLEX,
        0.8,
        (255, 0, 0),
        2,
        cv2.LINE_AA,
    )

# 6. Visualización gráfica de la imagen resultante
mm.show(img_com_caixas, title="Faster R-CNN (COCO) — Detección con Clase y Confianza")
Figura 9.29

9.5.2.2 Detección de Objetos y Transferencia de Aprendizaje con YOLO

Las secciones anteriores aplicaron la transferencia de aprendizaje a problemas de clasificación de imágenes, en los que el modelo asocia una única etiqueta a la imagen completa. En esta sección, el mismo principio se extiende a la detección de objetos, tarea que exige identificar simultáneamente qué está presente en la imagen y dónde se encuentra cada objeto.

La subsección anterior presentó la Faster R-CNN como ejemplo de detector preentrenado utilizado directamente para inferencia, sin ninguna adaptación al nuevo dominio. En este experimento, el modelo pasa por una etapa de ajuste fino (fine-tuning): se parte de una arquitectura YOLO (You Only Look Once) preentrenada en el conjunto COCO y se adapta la red para detectar y clasificar objetos de un nuevo dominio.

A diferencia de la Faster R-CNN, que realiza la detección en dos etapas, la familia YOLO adopta una arquitectura de etapa única (single-stage detector), estimando, en una única propagación por la red, las cajas delimitadoras (bounding boxes), la confianza de cada detección y la clase correspondiente. Esta estrategia reduce el costo computacional y hace viables las aplicaciones en tiempo real.

Como ejemplo, el experimento utiliza un conjunto sintético de formas geométricas (triángulos, cuadrados, estrellas, entre otras), con variaciones de color, tamaño, rotación y degradación por ruido de tipo sal y pimienta.

9.5.2.2.1 Bloco 1: Generación del Dataset Sintético

El siguiente bloque genera un conjunto sintético para el entrenamiento y la evaluación del detector. Cada imagen contiene entre uno y tres objetos pertenecientes a una de las nueve clases:

CLASSES = [
    'Triangle', 'Square', 'Pentagon', 'Hexagon',
    'Heptagon', 'Circle', 'Ellipse', 'Star', 'Cross'
]
  1. Generación de las formas: Las funciones poligono_regular, poligono_estrela y poligono_cruz construyen las coordenadas de los objetos. La función desenha_objeto dibuja cada forma con posición, tamaño, orientación y color aleatorios y calcula su bounding box.

  2. Anotación en el formato YOLO: La función gera_imagem_ruidosa genera entre uno y tres objetos por imagen y convierte cada bounding box al formato YOLO, representado por la clase y las coordenadas normalizadas del centro, ancho y alto.

  3. Degradación de la imagen: La función adiciona_ruido_sal_pimenta añade ruido impulsivo, simulando imperfecciones de adquisición.

  4. Visualización de las muestras: La Figura 9.30 presenta ejemplos del conjunto sintético con las bounding boxes superpuestas mediante la función mm.showBoundBox().

CLASSES = [
    'Triangle', 'Square', 'Pentagon', 'Hexagon',
    'Heptagon', 'Circle', 'Ellipse', 'Star', 'Cross'
]
N_LADOS = {'Triangle': 3, 'Square': 4, 'Pentagon': 5, 'Hexagon': 6, 'Heptagon': 7}

def poligono_regular(cx, cy, r, n_lados, rot_graus):
    ang0 = np.deg2rad(rot_graus - 90)
    angs = ang0 + 2 * np.pi * np.arange(n_lados) / n_lados
    return np.stack([cx + r * np.cos(angs), cy + r * np.sin(angs)], axis=1)

def poligono_estrela(cx, cy, r_externo, rot_graus, n_pontas=5):
    r_interno = r_externo * 0.45
    ang0 = np.deg2rad(rot_graus - 90)
    angs = ang0 + np.pi * np.arange(2 * n_pontas) / n_pontas
    raios = np.where(np.arange(2 * n_pontas) % 2 == 0, r_externo, r_interno)
    return np.stack([cx + raios * np.cos(angs), cy + raios * np.sin(angs)], axis=1)

def poligono_cruz(cx, cy, r, rot_graus, espessura_rel=0.35):
    w = r * espessura_rel
    base = np.array([
        (-w, -r), (w, -r), (w, -w), (r, -w), (r, w), (w, w),
        (w, r), (-w, r), (-w, w), (-r, w), (-r, -w), (-w, -w),
    ])
    theta = np.deg2rad(rot_graus)
    R = np.array([[np.cos(theta), -np.sin(theta)], [np.sin(theta), np.cos(theta)]])
    return base @ R.T + np.array([cx, cy])

def desenha_objeto(img, classe_idx, cx, cy, tamanho, rotacao, cor):
    nome = CLASSES[classe_idx]
    if nome in N_LADOS:
        pts = poligono_regular(cx, cy, tamanho, N_LADOS[nome], rotacao)
        cv2.fillPoly(img, [pts.astype(np.int32)], cor)
        xs, ys = pts[:, 0], pts[:, 1]
    elif nome == 'Star':
        pts = poligono_estrela(cx, cy, tamanho, rotacao)
        cv2.fillPoly(img, [pts.astype(np.int32)], cor)
        xs, ys = pts[:, 0], pts[:, 1]
    elif nome == 'Cross':
        pts = poligono_cruz(cx, cy, tamanho, rotacao)
        cv2.fillPoly(img, [pts.astype(np.int32)], cor)
        xs, ys = pts[:, 0], pts[:, 1]
    elif nome == 'Circle':
        cv2.circle(img, (int(cx), int(cy)), int(tamanho), cor, -1)
        xs, ys = np.array([cx - tamanho, cx + tamanho]), np.array([cy - tamanho, cy + tamanho])
    else:  # Elipse
        eixo = (int(tamanho), int(tamanho * 0.6))
        cv2.ellipse(img, (int(cx), int(cy)), eixo, rotacao, 0, 360, cor, -1)
        ang = np.deg2rad(rotacao)
        dx = np.hypot(eixo[0] * np.cos(ang), eixo[1] * np.sin(ang))
        dy = np.hypot(eixo[0] * np.sin(ang), eixo[1] * np.cos(ang))
        xs, ys = np.array([cx - dx, cx + dx]), np.array([cy - dy, cy + dy])
    return xs.min(), ys.min(), xs.max(), ys.max()

def adiciona_ruido_sal_pimenta(img, quantidade=0.05):
    img_ruidosa = img.copy()
    h, w, c = img_ruidosa.shape
    num_ruido = int(quantidade * h * w)
    
    # Sal (255, 255, 255)
    coords_sal = [np.random.randint(0, i - 1, num_ruido) for i in (h, w)]
    img_ruidosa[coords_sal[0], coords_sal[1]] = [255, 255, 255]
    
    # Pimienta (0, 0, 0)
    coords_pimenta = [np.random.randint(0, i - 1, num_ruido) for i in (h, w)]
    img_ruidosa[coords_pimenta[0], coords_pimenta[1]] = [0, 0, 0]
    
    return img_ruidosa

def gera_imagem_ruidosa(tam_img=160, n_objetos=(1, 3), taxa_ruido=0.01, rng=None):
    rng = rng or random.Random()
    img_limpa = np.full((tam_img, tam_img, 3), 255, dtype=np.uint8)
    anotacoes = []
    
    for _ in range(rng.randint(*n_objetos)):
        classe_idx = rng.randrange(len(CLASSES))
        tamanho = rng.randint(tam_img // 10, tam_img // 5)
        cx = rng.randint(tamanho + 2, tam_img - tamanho - 2)
        cy = rng.randint(tamanho + 2, tam_img - tamanho - 2)
        rotacao = rng.uniform(0, 360)
        cor = tuple(rng.sample(range(30, 226), 3))
        
        x0, y0, x1, y1 = desenha_objeto(img_limpa, classe_idx, cx, cy, tamanho, rotacao, cor)
        x0, y0 = max(x0, 0), max(y0, 0)
        x1, y1 = min(x1, tam_img), min(y1, tam_img)
        
        # Patrón YOLO: (clase, x_centro, y_centro, ancho, alto) normalizados
        xc, yc = (x0 + x1) / 2 / tam_img, (y0 + y1) / 2 / tam_img
        w, h = (x1 - x0) / tam_img, (y1 - y0) / tam_img
        anotacoes.append((classe_idx, xc, yc, w, h)) 
        
    img_ruidosa = adiciona_ruido_sal_pimenta(img_limpa, quantidade=taxa_ruido)
    return img_ruidosa, anotacoes
# Generación de 5 muestras para visualización inicial en la parte superior del proyecto
n_amostras_iniciais = 5
rng_demo = random.Random(42)

imgs_demo = []
titulos_demo = []

for idx in range(n_amostras_iniciais):
    img_ruid, anotacoes = gera_imagem_ruidosa(rng=rng_demo)
    
    # Escritura temporal de la anotación para lectura nativa mediante mm.showBoundBox
    filename_temp = f"temp_label_{idx}.txt"
    with open(filename_temp, "w") as f:
        for c, xc, yc, w, h in anotacoes:
            f.write(f"{c} {xc:.4f} {yc:.4f} {w:.4f} {h:.4f}\n")
            
    img_anotada = mm.showBoundBox(img_ruid, filename=filename_temp, fmt="yolo", show=False)
    imgs_demo.append(img_anotada)
    titulos_demo.append(f"Amostra {idx+1}")

# Visualización del panel de 5 muestras
mm.show(
    imgs_demo,
    titles=titulos_demo,
    cols=n_amostras_iniciais,
    figsize=(14, 3)
)
Figura 9.30: Muestras iniciales del dataset sintético ruidoso de objetos geométricos con las cajas delimitadoras del formato YOLO superpuestas.
9.5.2.2.2 Bloque 2: Organización del Dataset y Creación del Archivo data.yaml

Este bloque organiza el conjunto de datos en el formato esperado por la biblioteca Ultralytics YOLO. Las imágenes y las anotaciones se distribuyen en directorios separados para entrenamiento y validación, mientras que el archivo data.yaml reúne la información necesaria para el entrenamiento del detector.

shapes_dataset/
├── data.yaml
├── images/
│   ├── train/
│   └── val/
└── labels/
    ├── train/
    └── val/
  1. Generación del conjunto de datos: El código crea 90 imágenes para entrenamiento y 20 para validación. Para cada imagen, escribe un archivo .txt que contiene una línea por objeto, en el formato YOLO (clase, x_c, y_c, ancho, alto), con todas las coordenadas normalizadas.

  2. Organización de los archivos: Las imágenes se almacenan en images/train e images/val, mientras que las anotaciones correspondientes se escriben en labels/train y labels/val, preservando el mismo nombre de archivo.

  3. Creación del archivo data.yaml: El código genera automáticamente el archivo de configuración que contiene la ruta del dataset, los directorios de entrenamiento y validación, y el mapeo entre los índices numéricos y los nombres de las nueve clases.

base_dir = "shapes_dataset"
rng_global = random.Random(42)

for split, n_imgs in [("train", 90), ("val", 20)]:
    os.makedirs(f"{base_dir}/images/{split}", exist_ok=True)
    os.makedirs(f"{base_dir}/labels/{split}", exist_ok=True)
    
    for i in range(n_imgs):
        img_ruid, anotacoes = gera_imagem_ruidosa(rng=rng_global)
        cv2.imwrite(f"{base_dir}/images/{split}/{i:04d}.jpg", img_ruid)
        
        with open(f"{base_dir}/labels/{split}/{i:04d}.txt", "w") as f:
            for c, xc, yc, w, h in anotacoes:
                f.write(f"{c} {xc:.4f} {yc:.4f} {w:.4f} {h:.4f}\n")

with open(f"{base_dir}/data.yaml", "w") as f:
    f.write(
        f"path: {os.path.abspath(base_dir)}\n"
        "train: images/train\nval: images/val\nnames:\n"
    )
    for i, nome in enumerate(CLASSES):
        f.write(f"  {i}: {nome}\n")

print("Conjunto de datos ruidoso generado con éxito: 90 imágenes de entrenamiento y 20 de validación.")
Conjunto de datos ruidoso generado con éxito: 90 imágenes de entrenamiento y 20 de validación.
9.5.2.2.3 Bloco 3: Preprocesamiento con Filtro de Mediana

Este bloque aplica un preprocesamiento para reducir el efecto del ruido de tipo sal y pimienta introducido en la generación del dataset. El Filtro de Mediana (cv2.medianBlur) elimina este tipo de degradación preservando mejor los bordes de los objetos que los filtros de suavizado convencionales.

  1. Filtrado de la imagen: El código aplica un filtro de mediana con ventana \(3 \times 3\) a la imagen ruidosa, reduciendo los píxeles impulsivos sin alterar las anotaciones del conjunto de datos.

  2. Visualización comparativa: La Figura 9.31 compara la imagen original y la imagen filtrada, manteniendo las bounding boxes superpuestas mediante la función mm.showBoundBox().

# 1. Carga de la primera muestra ruidosa del dataset
caminho_img = f"{base_dir}/images/train/0000.jpg"
caminho_label = f"{base_dir}/labels/train/0000.txt"

img_ruidosa = mm.read(caminho_img)

# 2. Preprocesamiento con Filtro de Mediana (ventana 3x3)
img_filtrada = cv2.medianBlur(img_ruidosa, ksize=3)

# 3. Superposición de las bounding boxes con mm.showBoundBox
img_ruid_anotada = mm.showBoundBox(img_ruidosa, filename=caminho_label, fmt="yolo", show=False)
img_filt_anotada = mm.showBoundBox(img_filtrada, filename=caminho_label, fmt="yolo", show=False)

# 4. Exhibición comparativa con mm.show
mm.show(
    [img_ruid_anotada, img_filt_anotada],
    titles=[
        "1. Imagen Ruidosa Original (Sal y Pimienta)",
        "2. Preprocesada (Filtro de Mediana 3x3)"
    ],
    cols=2,
    figsize=(9, 4)
)
Figura 9.31: Comparación entre la imagen original con ruido tipo sal y pimienta y la imagen después de la aplicación del Filtro de Mediana (3x3). Las bounding boxes en el formato YOLO permanecen inalteradas.
9.5.2.2.4 Bloque 4: Preprocesamiento del Dataset y Ajuste Fino del YOLOv8

Este bloque aplica el Filtro de Mediana al conjunto de imágenes y realiza el ajuste fino (fine-tuning) del detector YOLOv8n preentrenado en el conjunto COCO. El filtrado reduce el efecto del ruido impulsivo introducido en la generación de las imágenes, mientras que el entrenamiento adapta los parámetros de la red al nuevo dominio de formas geométricas.

  1. Filtrado por lotes: El código recorre los directorios train y val y aplica cv2.medianBlur con una ventana \(3 \times 3\) en todas las imágenes, manteniendo las anotaciones YOLO originales.

  2. Ajuste fino del detector: La red YOLO("yolov8n.pt"), inicialmente entrenada en COCO, se adapta al conjunto geométrico mediante la función .train(). El entrenamiento utiliza imágenes con resolución de \(320 \times 320\) píxeles durante \(30\) épocas.

  3. Evaluación del modelo: La función .val() calcula las métricas de detección en el conjunto de validación, incluyendo precisión (precision), exhaustividad (recall) y mAP50 (mean Average Precision con umbral de IoU igual a \(0,5\)).

import logging

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

base_dir = "shapes_dataset"
base_dir_filt = "shapes_dataset_filtrado"

# 1. Crea una COPIA filtrada del conjunto de datos en una carpeta separada
#    (el conjunto de datos original en base_dir permanece ruidoso, intacto)
for split in ["train", "val"]:
    pasta_imgs_orig = f"{base_dir}/images/{split}"
    pasta_labels_orig = f"{base_dir}/labels/{split}"
    pasta_imgs_filt = f"{base_dir_filt}/images/{split}"
    pasta_labels_filt = f"{base_dir_filt}/labels/{split}"

    os.makedirs(pasta_imgs_filt, exist_ok=True)
    os.makedirs(pasta_labels_filt, exist_ok=True)

    for nome_arq in os.listdir(pasta_imgs_orig):
        if nome_arq.endswith(".jpg"):
            img_ruidosa = cv2.imread(f"{pasta_imgs_orig}/{nome_arq}")
            img_filtrada = cv2.medianBlur(img_ruidosa, ksize=3)
            # guarda la versión filtrada en la carpeta NUEVA, no sobrescribe la original
            cv2.imwrite(f"{pasta_imgs_filt}/{nome_arq}", img_filtrada)

    # copia las etiquetas (no cambian con el filtro)
    for nome_arq in os.listdir(pasta_labels_orig):
        shutil.copy(f"{pasta_labels_orig}/{nome_arq}", f"{pasta_labels_filt}/{nome_arq}")

# 2. data.yaml apuntando al conjunto de datos FILTRADO
with open(f"{base_dir_filt}/data.yaml", "w") as f:
    f.write(
        f"path: {os.path.abspath(base_dir_filt)}\n"
        "train: images/train\nval: images/val\nnames:\n"
    )
    for i, nome in enumerate(CLASSES):
        f.write(f"  {i}: {nome}\n")

print("Preprocesamiento completado: conjunto de datos filtrado guardado en carpeta separada.\n")

# Descargar modelo YOLOv8 preentrenado (yolov8n.pt) si aún no está presente
with contextlib.redirect_stdout(io.StringIO()), \
    contextlib.redirect_stderr(io.StringIO()):
    modelo_yolo = YOLO("yolov8n.pt")
print("Modelo YOLOv8 cargado.")
Preprocesamiento completado: conjunto de datos filtrado guardado en carpeta separada.

Modelo YOLOv8 cargado.
# 3. Callback personalizado para imprimir solo la época en ejecución
def on_train_epoch_start(trainer):
    epoch_atual = trainer.epoch + 1
    total_epochs = trainer.epochs
    # Escribe directamente en el stdout original (evadiendo el silenciador)
    sys.__stdout__.write(f"🔄 Processando Época {epoch_atual}/{total_epochs}...\n")
    sys.__stdout__.flush()

# Añade el callback al modelo
modelo_yolo.add_callback("on_train_epoch_start", on_train_epoch_start)

# 4. Gestor de contexto para silenciar la basura de Ultralytics (C/C++ y Python)
@contextlib.contextmanager
def silenciar_logs():
    logger = logging.getLogger("ultralytics")
    disabled_state = logger.disabled
    logger.disabled = True
    
    with open(os.devnull, "w") as fnull:
        old_stdout_fd = os.dup(1)
        old_stderr_fd = os.dup(2)
        try:
            os.dup2(fnull.fileno(), 1)
            os.dup2(fnull.fileno(), 2)
            with contextlib.redirect_stdout(fnull), contextlib.redirect_stderr(fnull):
                yield
        finally:
            os.dup2(old_stdout_fd, 1)
            os.dup2(old_stderr_fd, 2)
            os.close(old_stdout_fd)
            os.close(old_stderr_fd)
            logger.disabled = disabled_state

# Ejecución del Entrenamiento
print("--- Iniciando Entrenamiento YOLOv8 ---")
with silenciar_logs():
    resultados_treino = modelo_yolo.train(
        data=f"{base_dir_filt}/data.yaml",   # <-- entrena en el dataset filtrado
        epochs=30,
        imgsz=320,
        batch=16,
        device=device,
        verbose=False,
        plots=False
    )
    metricas = modelo_yolo.val(verbose=False)

# 5. Métricas Finales
precision = metricas.results_dict["metrics/precision(B)"]
recall = metricas.results_dict["metrics/recall(B)"]
map50 = metricas.results_dict["metrics/mAP50(B)"]

print("\n--- Rendimiento Optimizado del Modelo YOLOv8 ---")
print(f"Precisión: {precision*100:.2f}%")
print(f"Revocación (Recall): {recall*100:.2f}%")
print(f"mAP al 50% (IoU 0.50): {map50*100:.2f}%")
--- Iniciando Entrenamiento YOLOv8 ---

--- Rendimiento Optimizado del Modelo YOLOv8 ---
Precisión: 83.62%
Revocación (Recall): 85.50%
mAP al 50% (IoU 0.50): 92.15%
9.5.2.2.5 Bloque 5: Comparativo de Inferencia: Imagen Ruidosa e Imagen Restaurada

Tras el ajuste fino de YOLOv8 en el conjunto restaurado, se realiza una comparación visual entre la detección aplicada directamente sobre una imagen degradada por ruido sal y pimienta y la misma imagen después del Filtro de Mediana.

El objetivo es observar cómo una etapa simple de preprocesamiento puede influir en la calidad de las predicciones de un detector ya adaptado al nuevo dominio.

  1. Inferencia con la YOLO: La función modelo_yolo.predict() ejecuta la detección en las dos versiones de la imagen, utilizando un umbral de confianza de \(25\%\) (conf=0.25).

  2. Visualización de las Predicciones: La función plot() genera las imágenes anotadas con las cajas delimitadoras y las etiquetas previstas por el modelo. La Figura 9.32 presenta la comparación entre los dos escenarios.

# 1. Carga de una muestra de prueba original (sin el filtro guardado en lote)
caminho_teste = f"{base_dir}/images/val/0002.jpg"
img_ruidosa_teste = mm.read(caminho_teste)

# 2. Aplicación puntual del Filtro de Mediana (3x3) para comparación
img_filtrada_teste = cv2.medianBlur(img_ruidosa_teste, ksize=3)

# 3. Inferencia con el modelo YOLOv8 entrenado
pred_ruidosa = modelo_yolo.predict(img_ruidosa_teste, conf=0.25, verbose=False)[0]
pred_filtrada = modelo_yolo.predict(img_filtrada_teste, conf=0.25, verbose=False)[0]

# 4. Extracción de las matrices anotadas por el generador del YOLO (conversión BGR -> RGB)
img_pred_ruid = cv2.cvtColor(pred_ruidosa.plot(), cv2.COLOR_BGR2RGB)
img_pred_filt = cv2.cvtColor(pred_filtrada.plot(), cv2.COLOR_BGR2RGB)

# 5. Exhibición comparativa estandarizada mediante mm.show
mm.show(
    [img_pred_ruid, img_pred_filt],
    titles=[
        f"Inferencia en la Imagen Ruidosa ({len(pred_ruidosa.boxes)} objetos)",
        f"Inferencia en la Imagen Filtrada ({len(pred_filtrada.boxes)} objetos)"
    ],
    cols=2,
    figsize=(10, 4)
)
Figura 9.32
# Limpieza explícita de los datos descargados y liberación de memoria
if FLAG_LIMPAR_DADOS:
    if os.path.exists(base_dir):
        shutil.rmtree(base_dir)
        print('🧹 Diretório de dados temporários {} removido com sucesso.'.format(base_dir))

    if os.path.exists(base_dir_filt):
        shutil.rmtree(base_dir_filt)
        print('🧹 Diretório de dados temporários {} removido com sucesso.'.format(base_dir_filt))

    if torch.cuda.is_available():
        torch.cuda.empty_cache()
Nota🧠 Un dominio mucho más distante que el de los dígitos

En el experimento de transferencia de aprendizaje entre dígitos manuscritos (dominios A y B), la tarea de origen y la de destino compartían estadísticas visuales muy cercanas: ambas eran trazos en tonos de gris sobre fondo uniforme. Aquí, la distancia entre dominios es mucho mayor — el YOLO fue preentrenado en fotografías naturales coloridas de COCO (personas, animales, vehículos, objetos cotidianos), y la tarea de destino consiste en formas geométricas sintéticas, de color sólido y contorno bien definido, sin textura, iluminación ni fondo complejo.

Aun así, la transferencia de aprendizaje es ventajosa: las capas iniciales de un detector entrenado en COCO aprenden filtros genéricos — detectores de bordes, esquinas y regiones de contraste — que siguen siendo útiles para delimitar el contorno de un triángulo o de una estrella, incluso si el contenido visual final es bastante distinto. Es por ello que permitir el ajuste fino (fine-tuning) de todas las capas, combinado con un preprocesamiento consistente entre entrenamiento e inferencia para atenuar el ruido sal y pimienta, posibilita tasas de precisión elevadas en la detección de objetos del nuevo dominio.

9.5.2.2.6 Usando un Conjunto de Datos Real

El pipeline anterior fue construido íntegramente en torno al formato de anotación YOLO (clase, \(x_{centro}\), \(y_{centro}\), ancho, alto, normalizados por el ancho y alto de la imagen) exactamente para que pueda reutilizarse sin modificaciones si el lector tiene acceso a un conjunto de imágenes reales anotadas de la misma manera — por ejemplo, un conjunto de imágenes de objetos geométricos fotografiados o renderizados, cada uno con su archivo .txt correspondiente en el mismo formato usado aquí. Para ello, bastaría con:

  1. Organizar las imágenes reales en shapes_dataset/images/train y shapes_dataset/images/val, y los archivos .txt de anotación correspondientes en las carpetas labels/train y labels/val (un archivo de anotación por imagen, mismo nombre base, extensión .txt);
  2. Ajustar el archivo data.yaml si el número o los nombres de las clases son diferentes;
  3. Ejecutar las mismas celdas de entrenamiento, ajuste fino y visualización ya presentadas, sin ninguna otra modificación de código.

Esta separación entre generación/organización de los datos y entrenamiento del modelo es, en la práctica, la razón por la cual los formatos de anotación estandarizados (como el de YOLO) son tan ampliamente adoptados: permiten intercambiar el conjunto de datos de entrada — sintético por real, un dominio por otro — manteniendo inalterado todo el resto del pipeline de transferencia de aprendizaje.

9.5.3 Segmentación de Objetos

El mismo principio de transferencia de aprendizaje también fundamenta arquitecturas de segmentación de imágenes, en las cuales un extractor de características preentrenado proporciona representaciones visuales generales, mientras que una cabeza especializada realiza la clasificación densa, píxel a píxel.

Las siguientes secciones presentan la DeepLabV3 como ejemplo de segmentador preentrenado utilizado directamente para inferencia y, a continuación, la arquitectura U-Net, entrenada desde cero y comparada con una línea base morfológica clásica.

9.5.3.1 DeepLabV3: Segmentador Preentrenado

En la segmentación semántica, el objetivo no se limita a la localización de los objetos mediante cajas delimitadoras (bounding boxes). La red asigna una clase a cada píxel de la imagen, produciendo un mapa de etiquetas con la misma resolución que la entrada. Arquitecturas como la DeepLabV3, con backbone ResNet-50, utilizan un extractor de características preentrenado y una cabeza especializada para realizar esta clasificación densa.

  1. Carga e inferencia: El modelo deeplabv3_resnet50(weights="DEFAULT") carga pesos preentrenados en el conjunto Pascal VOC, que define \(21\) clases de segmentación. El código convierte la imagen en tensor, añade la dimensión de batch (unsqueeze(0)) y ejecuta la inferencia.

  2. Mapa de clases: La salida del modelo posee dimensión \((1, 21, H, W)\), conteniendo un valor para cada clase en cada píxel. La operación .argmax(dim=1) selecciona la clase de mayor respuesta en cada posición, generando una matriz bidimensional de etiquetas con dimensiones \((H, W)\).

  3. Visualización: El código convierte el mapa de etiquetas al formato esperado por mm.show(), que muestra el resultado de la segmentación en la Figura 9.33.

# 1. Carga de la imagen (retorna numpy.ndarray)
url_imagem = "https://raw.githubusercontent.com/pytorch/hub/master/images/dog.jpg"
url_imagem = "http://images.cocodataset.org/val2017/000000039769.jpg"
img = mm.read(url_imagem)

# 2. Carga del modelo DeepLabV3 preentrenado en modo de evaluación
modelo_segmentacao = deeplabv3_resnet50(weights="DEFAULT").eval()

# 3. Ejecución de la inferencia sin cálculo de gradientes
with torch.no_grad():
    tensor_entrada = to_tensor(img).unsqueeze(0)  # Formato (1, C, H, W)
    saida = modelo_segmentacao(tensor_entrada)["out"]
    
    # Selección de la clase con mayor probabilidad por píxel (argmax en el eje de los canales)
    mapa_classes = saida.argmax(dim=1).squeeze(0).byte().cpu().numpy()

# 4. Visualización del mapa de segmentación semántica
mm.show(
    [img,mapa_classes],
    title=["Imagen original","Segmentación Semántica (DeepLabV3)"]
)
Figura 9.33

9.5.3.2 Segmentación Semántica con Arquitectura U-Net

La subsección anterior presentó un modelo preentrenado (DeepLabV3) que produce directamente una etiqueta de clase por píxel. Esta sección completa la secuencia de proyectos prácticos — clasificación y detección — abordando la segmentación semántica implementada y entrenada desde cero con la U-Net, la arquitectura de referencia introducida por Ronneberger (2015).

En la clasificación, el mapa de características final se aplanaba (flatten) en un vector, descartando la información espacial en favor de una única etiqueta por imagen. La U-Net, por su parte, produce una salida con la misma resolución espacial que la entrada: un mapa bidimensional en el cual cada píxel recibe su propia clasificación. Este requisito — preservar el detalle espacial de alta resolución al mismo tiempo que se construye contexto semántico en capas profundas — motiva la arquitectura de codificador-decodificador con conexiones de atajo (skip connections).

El escenario utilizado simula la segmentación de nódulos en exámenes médicos sintéticos: imágenes en escala de grises contienen una región circular (“nódulo”) superpuesta sobre un fondo, ambas contaminadas por ruido gaussiano y con medias de intensidad muy cercanas — un desafío intencional de bajo contraste, ideal para demostrar la ganancia del aprendizaje espacial frente a la umbralización puntual.

9.5.3.2.1 Bloco 1: Gerador del Conjunto Sintético de Nódulos y Visualización Inicial

El siguiente generador produce pares (imagen, máscara): la imagen contiene una región circular de intensidad ligeramente superior a la del fondo, ambas afectadas por la misma desviación estándar de ruido gaussiano. La máscara binaria delimita exactamente la región del nódulo y sirve como verdad de referencia (ground truth).

  1. Construcción del Nódulo: La función gera_imagem_com_nodulo superpone el nódulo al fondo sobre una matriz \(64 \times 64\) y aplica ruido gaussiano.
  2. Visualización con mm.show: La Figura 9.34 ilustra las dos primeras muestras y sus respectivas máscaras.
TAM_IMG = 64


def gera_imagem_com_nodulo(
    tam=TAM_IMG,
    raio_min=7,
    raio_max=15,
    media_fundo=95,
    media_nodulo=118,
    sigma_ruido=26,
    rng=None,
):
    rng = rng or np.random.default_rng()
    fundo = rng.normal(media_fundo, sigma_ruido, (tam, tam))
    nodulo = rng.normal(media_nodulo, sigma_ruido, (tam, tam))
    mascara = np.zeros((tam, tam), dtype=np.uint8)

    raio = int(rng.integers(raio_min, raio_max))
    cx = int(rng.integers(raio + 4, tam - raio - 4))
    cy = int(rng.integers(raio + 4, tam - raio - 4))

    cv2.circle(mascara, (cx, cy), raio, 255, -1)
    imagem = np.clip(np.where(mascara > 0, nodulo, fundo), 0, 255).astype(
        np.uint8
    )
    return imagem, mascara


# Generación de los conjuntos de entrenamiento y validación
rng_dados = np.random.default_rng(42)
N_TREINO, N_VAL = 160, 40

imgs_treino, masks_treino = zip(
    *[gera_imagem_com_nodulo(rng=rng_dados) for _ in range(N_TREINO)]
)
imgs_val, masks_val = zip(
    *[gera_imagem_com_nodulo(rng=rng_dados) for _ in range(N_VAL)]
)

print(
    f"Conjunto de entrenamiento: {N_TREINO} imágenes | Conjunto de validación: {N_VAL} imágenes\n"
)

# Exhibición de muestras iniciales 
mm.show(
    [imgs_treino[0], masks_treino[0], imgs_treino[1], masks_treino[1]],
    titles=["Imagen 1", "Máscara 1", "Imagen 2", "Máscara 2"],
    cols=4,
    figsize=(11, 3),
)
Conjunto de entrenamiento: 160 imágenes | Conjunto de validación: 40 imágenes
Figura 9.34: Muestras del conjunto de datos sintético de nódulos: imagen en escala de grises bajo ruido y su respectiva máscara binaria de referencia mostradas.
9.5.3.2.2 Bloco 2: Línea Base Clásica (Filtrado, Otsu y Morfología)

Antes de emplear la U-Net, se evalúa el desempeño de un pipeline morfológico clásico construido con la biblioteca morph: un suavizador gaussiano (mm.blur), una umbralización de Otsu (mm.threshold) y una apertura morfológica (mm.open) para la eliminación de ruidos aislados.

  1. Métrica de Intersección sobre Unión (IoU): La función iou_mascaras calcula el grado de superposición píxel a píxel entre la predicción y la máscara real.
  2. Ejecución y Comparativa: La Figura 9.35 muestra el resultado de la segmentación clásica en una imagen de prueba, demostrando las limitaciones del umbral global bajo bajo contraste.
def iou_mascaras(predita, referencia):
    p, r = predita > 0, referencia > 0
    intersecao = np.logical_and(p, r).sum()
    uniao = np.logical_or(p, r).sum()
    return intersecao / uniao if uniao else 1.0


def segmenta_classico(imagem, elemento_estrutural):
    suavizada = mm.blur(imagem, 7)
    binaria = mm.threshold(suavizada)
    return mm.open(binaria, elemento_estrutural)


elemento_estrutural = mm.sedisk(5)
ious_classico = [
    iou_mascaras(segmenta_classico(img, elemento_estrutural), mask)
    for img, mask in zip(imgs_val, masks_val)
]
iou_classico_medio = float(np.mean(ious_classico))
print(
    f"IoU medio (línea de base clásica) en la validación: {iou_classico_medio:.4f}\n"
)

predicao_classica_exemplo = segmenta_classico(imgs_val[0], elemento_estrutural)

mm.show(
    [imgs_val[0], masks_val[0], predicao_classica_exemplo],
    titles=["Imagen", "Máscara de Referencia", "Predicción Clásica"],
    cols=3,
    figsize=(9, 3.2),
)
IoU medio (línea de base clásica) en la validación: 0.7516
Figura 9.35: Línea de base clásica de segmentación: suavizado, umbralización de Otsu y apertura morfológica mostradas.
9.5.3.2.3 Bloque 3: Construcción de la Arquitectura U-Net y Funciones de Pérdida

La U-Net es una arquitectura en forma de “U” (de ahí su nombre), pensada específicamente para la segmentación de imágenes. Está formada por dos caminos que trabajan en conjunto:

  • 🔽 Codificador (encoder): desciende por la imagen, reduciendo la resolución espacial en cada etapa mientras extrae características cada vez más abstractas (bordes → texturas → formas → contexto).
  • 🔼 Decodificador (decoder): asciende de nuevo, reconstruyendo la resolución original mediante convoluciones transpuestas (upsampling), hasta generar una máscara del mismo tamaño que la imagen de entrada.

El elemento que hace especial a la U-Net son las conexiones de atajo (skip connections): estas llevan los mapas de características del codificador directamente a la etapa correspondiente del decodificador, en la misma resolución. Esto evita que los detalles finos —como contornos y bordes— se pierdan durante la compresión espacial.

Flujo general de la arquitectura:

Entrada
  │
  ▼
Codificador (Conv → Conv → Pool) × 3
  │
  ├──── conexiones de atajo reinyectan mapas de alta resolución  ────┐
  ▼                                                               │
Base (bottleneck)                                                 │
  │                                                               │
  ▼                                                               │
Decodificador (Upsample → Concat → Conv → Conv) × 3  ◄────────────┘
  │
  ▼
Salida 1×1 (logits)

Componentes principales:

  1. Bloque Convolucional Base (BlocoConv) La unidad fundamental repetida en toda la red. Aplica dos convoluciones \(3 \times 3\) en secuencia, cada una seguida de activación ReLU, con padding que preserva las dimensiones espaciales de la entrada. Este bloque aparece tanto en el codificador como en el decodificador.

  2. Convolución Transpuesta (nn.ConvTranspose2d) Es la operación responsable del upsampling en el decodificador: en lugar de reducir la resolución espacial (como hace el MaxPool2d en el codificador), la aumenta, aprendiendo los pesos necesarios para “deshacer” la compresión y recuperar gradualmente el tamaño original de la imagen.

  3. Pérdida Combinada (BCE + Dice) La función perda_segmentacao suma dos métricas complementarias:

    • Entropía Cruzada Binaria (BCE): evalúa el acierto pixel a pixel.
    • Coeficiente de Dice: evalúa la superposición global entre la máscara prevista y la real.

    Juntas, equilibran la precisión local con la fidelidad de la forma segmentada en su conjunto.

class BlocoConv(nn.Module):

    def __init__(self, canais_entrada, canais_saida):
        super().__init__()
        self.rede = nn.Sequential(
            nn.Conv2d(canais_entrada, canais_saida, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(canais_saida, canais_saida, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
        )

    def forward(self, x):
        return self.rede(x)


class UNetCompacta(nn.Module):

    def __init__(self, canais_entrada=1, base=8):
        super().__init__()
        self.enc1 = BlocoConv(canais_entrada, base)
        self.enc2 = BlocoConv(base, base * 2)
        self.enc3 = BlocoConv(base * 2, base * 4)
        self.pool = nn.MaxPool2d(2)

        self.fundo = BlocoConv(base * 4, base * 8)

        self.up3 = nn.ConvTranspose2d(
            base * 8, base * 4, kernel_size=2, stride=2
        )
        self.dec3 = BlocoConv(base * 8, base * 4)
        self.up2 = nn.ConvTranspose2d(
            base * 4, base * 2, kernel_size=2, stride=2
        )
        self.dec2 = BlocoConv(base * 4, base * 2)
        self.up1 = nn.ConvTranspose2d(
            base * 2, base, kernel_size=2, stride=2
        )
        self.dec1 = BlocoConv(base * 2, base)

        self.saida = nn.Conv2d(base, 1, kernel_size=1)

    def forward(self, x):
        e1 = self.enc1(x)
        e2 = self.enc2(self.pool(e1))
        e3 = self.enc3(self.pool(e2))
        f = self.fundo(self.pool(e3))

        d3 = self.dec3(torch.cat([self.up3(f), e3], dim=1))
        d2 = self.dec2(torch.cat([self.up2(d3), e2], dim=1))
        d1 = self.dec1(torch.cat([self.up1(d2), e1], dim=1))
        return self.saida(d1)


def para_tensores(imagens, mascaras):
    X = (
        torch.tensor(np.stack(imagens), dtype=torch.float32).unsqueeze(1)
        / 255.0
    )
    Y = (
        torch.tensor(np.stack(mascaras), dtype=torch.float32).unsqueeze(1)
        / 255.0
    )
    return X, Y


def perda_dice(logits, alvo, eps=1e-6):
    probs = torch.sigmoid(logits)
    intersecao = (probs * alvo).sum(dim=(1, 2, 3))
    uniao = probs.sum(dim=(1, 2, 3)) + alvo.sum(dim=(1, 2, 3))
    dice = (2 * intersecao + eps) / (uniao + eps)
    return 1 - dice.mean()


def perda_segmentacao(logits, alvo):
    return nn.functional.binary_cross_entropy_with_logits(
        logits, alvo
    ) + perda_dice(logits, alvo)
9.5.3.2.4 Bloque 4: Entrenamiento de la U-Net y Evaluación de Rendimiento

El entrenamiento se ejecuta durante \(35\) épocas utilizando el optimizador Adam. En cada época, se monitorea la Pérdida de Entrenamiento y el índice IoU promedio en el conjunto de validación.

  1. Bucle de Entrenamiento: Se actualizan los parámetros con mini-lotes de \(16\) muestras.
  2. Evolución Gráfica: La Figura 9.36 muestra el gráfico con el progreso de la pérdida y del IoU.
modelo_unet = UNetCompacta()
print(
    f"Parámetros entrenables de la U-Net: {sum(p.numel() for p in modelo_unet.parameters())}"
)

X_treino_unet, Y_treino_unet = para_tensores(imgs_treino, masks_treino)
X_val_unet, Y_val_unet = para_tensores(imgs_val, masks_val)

otimizador_unet = optim.Adam(modelo_unet.parameters(), lr=1e-3)
n = X_treino_unet.size(0)
tam_lote = 16
epocas_unet = 35
historico_perda_unet, historico_iou_unet = [], []

for epoca in range(epocas_unet):
    if epoca % 5 == 0:  # Imprime cada 5 épocas
        print(epoca + 1, "/", epocas_unet)
    modelo_unet.train()
    perm = torch.randperm(n)
    perda_epoca = 0.0

    for i in range(0, n, tam_lote):
        idx = perm[i : i + tam_lote]
        otimizador_unet.zero_grad()
        logits = modelo_unet(X_treino_unet[idx])
        perda = perda_segmentacao(logits, Y_treino_unet[idx])
        perda.backward()
        otimizador_unet.step()
        perda_epoca += perda.item() * len(idx)

    modelo_unet.eval()
    with torch.no_grad():
        predicao_val = (torch.sigmoid(modelo_unet(X_val_unet)) > 0.5).float()
        intersecao = (predicao_val * Y_val_unet).sum(dim=(1, 2, 3))
        uniao = ((predicao_val + Y_val_unet) > 0).float().sum(dim=(1, 2, 3))
        iou_epoca = (intersecao / uniao.clamp(min=1e-6)).mean().item()

    historico_perda_unet.append(perda_epoca / n)
    historico_iou_unet.append(iou_epoca)

iou_unet_final = historico_iou_unet[-1]
print(f"IoU medio final de la U-Net en la validación: {iou_unet_final:.4f}")

# Gráfico de la evolución del entrenamiento
r = mm.showTrainCurves(historico_perda_unet, historico_iou_unet,
        titulo="Treinamento da U-Net — Segmentação de Nódulos Sintéticos",
        subtitulo="Perda no conjunto de treino e IoU médio no conjunto de validação \
            ao longo de 35 épocas")
Parámetros entrenables de la U-Net: 120681
1 / 35
6 / 35
11 / 35
16 / 35
21 / 35
26 / 35
31 / 35
IoU medio final de la U-Net en la validación: 0.8876
Figura 9.36: Evolución del entrenamiento de la U-Net compacta: reducción de la pérdida y elevación del índice IoU medio en el conjunto de validación a lo largo de 35 épocas.
9.5.3.2.5 Bloque 5: Comparativo Cuantitativo y Cualitativo (Clásico vs. U-Net)

La comparación entre el enfoque clásico y la U-Net evidencia la superioridad del aprendizaje de representaciones en escenarios de bajo contraste.

  1. Panel de Métricas: El gráfico de barras en la Figura 9.37 contrasta el IoU medio de ambos métodos en la validación.
  2. Visualización Cualitativa: La comparación visual en tres muestras demuestra cómo las conexiones de atajo recuperan el contorno del nódulo incluso bajo ruido acentuado.
# 1.  comparativo 
print(f"IoU promedio (Suavizado clásico + Otsu): {iou_classico_medio:.4f}")
print(f"IoU promedio (U-Net): {iou_unet_final:.4f}")

# 2. Visualización cualitativa lado a lado en 3 muestras mediante mm.show
imgs_comparativas = []
titulos_comparativos = []

for i in range(3):
    with torch.no_grad():
        pred_unet = (
            (torch.sigmoid(modelo_unet(X_val_unet[i : i + 1])) > 0.5)
            .float()
            .squeeze()
            .numpy()
            * 255
        )

    pred_classico = segmenta_classico(imgs_val[i], elemento_estrutural)

    imgs_comparativas.extend(
        [imgs_val[i], masks_val[i], pred_classico, pred_unet.astype(np.uint8)]
    )

    t_prefix = f"Amostra {i+1}"
    titulos_comparativos.extend(
        [
            f"{t_prefix}: Imagem",
            f"{t_prefix}: Referência",
            f"{t_prefix}: Clássico",
            f"{t_prefix}: U-Net",
        ]
    )

mm.show(
    imgs_comparativas,
    titles=titulos_comparativos,
    cols=4,
    figsize=(11, 7.5),
)
IoU promedio (Suavizado clásico + Otsu): 0.7516
IoU promedio (U-Net): 0.8876
Figura 9.37: Comparativo cuantitativo (IoU promedio) y cualitativo entre el enfoque clásico y la U-Net entrenada en tres muestras de validación.
Nota🧠 ¿Por qué la U-Net supera a la umbralización fija?

La umbralización de Otsu aplica un valor de corte global sobre la intensidad local. Cuando la diferencia de media entre el nódulo y el fondo es pequeña frente al ruido gaussiano, esta regla comete errores sistemáticos en los bordes.

La U-Net supera esta limitación al combinar el contexto semántico amplio extraído por el codificador con los detalles espaciales finos preservados por las conexiones de atajo. Esto permite identificar la presencia del nódulo y delimitar sus contornos con precisión, incluso bajo ruido intenso.

9.5.4 Ingeniería de Datos para VC (Roboflow)

Una U-Net puede entrenarse a partir de imágenes anotadas en plataformas de ingeniería de datos para Visión por Computador (VC), como Roboflow. Estas plataformas permiten organizar conjuntos de datos, realizar anotaciones, aplicar etapas de preprocesamiento y data augmentation, entrenar modelos y exportar los datos en diferentes formatos. En esta sección, sin embargo, el ejemplo retoma la detección de objetos geométricos, utilizando conjuntos de datos ya presentados en este libro.

ImportanteDependencia de conexión y clave de API

Las celdas de esta sección requieren conexión a Internet y una clave de API gratuita de Roboflow (app.roboflow.com). En el Workspace del proyecto, acceda a ⚙ → Roboflow API y copie la Private API Key.

Cree, en esta carpeta, el archivo chave_roboflow.txt que contenga únicamente la clave, sin comillas. Un modelo de este archivo está disponible en chave_roboflow.txt.exemplo.

Agregue chave_roboflow.txt al archivo .gitignore, ya que contiene una credencial de acceso que no debe versionarse ni compartirse.

9.5.4.1 Detección de objetos utilizando Roboflow

Roboflow permite realizar inferencia sobre imágenes locales, lo que posibilita evaluar el rendimiento del modelo alojado en la identificación de los objetos de interés.

Además de la inferencia, el dataset puede exportarse en el formato png-mask-semantic, en el cual cada imagen se acompaña de una máscara de segmentación semántica. En esta máscara, cada píxel representa la clase a la que pertenece el objeto correspondiente. Los pares imagen-máscara se utilizan como datos de entrenamiento para la UNetCompacta.

9.5.4.2 Conexión, descarga y verificación del dataset

El código establece conexión con el Workspace mctest y el proyecto geometric-test00, versión 6, y realiza la descarga del dataset hacia dados/datasetRoboFlow. A continuación, verifica la forma de las imágenes en cada split. La función de verificación se reutiliza posteriormente en la sección.

from roboflow import Roboflow
from pathlib import Path
from PIL import Image
from collections import Counter

def contar_shapes(raiz, splits=("train", "valid", "test")):
    """Cuenta el shape (alto, ancho, canales) de las imágenes por split."""
    for split in splits:
        pasta = raiz / split / "images"
        if not pasta.exists():
            print(f"{split}: carpeta no encontrada")
            continue

        shapes = Counter()
        for arquivo in pasta.iterdir():
            if arquivo.is_file():
                with Image.open(arquivo) as img:
                    shapes[(img.height, img.width, len(img.getbands()))] += 1

        txt = ", ".join(f"{s}: {n}" for s, n in shapes.items())
        print(f"{split}: {txt}")


chave = Path("chave_roboflow.txt")

if not chave.exists():
    print("Clave de Roboflow no encontrada: clave_roboflow.txt")
else:
    with open(chave) as f:
        api_key = f.read().strip()

    # Proyecto:
    # https://app.roboflow.com/mctest/geometric-test00/models
    # geometric-test00/6

    rf = Roboflow(api_key=api_key)
    projeto = rf.workspace("mctest").project("geometric-test00")
    versao = projeto.version(6)

    print(
        f"ID: {versao.version} | Nombre: {versao.name} | "
        f"Imágenes: {versao.images}"
    )

    raiz = Path("dados/datasetRoboFlow")
    versao.download("yolov8", location=str(raiz))

    print("Dataset:", raiz)
    contar_shapes(raiz)

9.5.4.3 Descargando el dataset de forma reproducible (alternativa)

Como alternativa al dataset obtenido mediante Roboflow, se puede utilizar un dataset disponible en un repositorio de GitHub, también organizado en los mismos splits y que contiene las mismas clases de objetos. Los conjuntos de datos, sin embargo, no son idénticos: las imágenes de GitHub tienen una resolución de 608×608 píxeles, mientras que las imágenes exportadas por Roboflow tienen 640×640 píxeles.

El código siguiente realiza la descarga del dataset desde GitHub, en caso de que aún no esté disponible localmente, y reutiliza contar_shapes para verificar las dimensiones de las imágenes en cada split.

import os

if not os.path.exists("dados/dataset"):
    cmd = (
        "git clone --no-checkout --depth 1 --filter=blob:none "
        "https://github.com/fzampirolli/pdi-vc.git tmp_repo && "
        "cd tmp_repo && git sparse-checkout set all/cap09/dados/dataset "
        "&& git checkout && cd .. && mkdir -p dados && "
        "cp -r tmp_repo/all/cap09/dados/dataset dados/dataset && "
        "rm -rf tmp_repo"
    )
    !{cmd}

if not chave.exists():
    print("Chave do Roboflow não encontrada: chave_roboflow.txt")
else:
  versao_recente = projeto.versions()[-1]
  print(f"Versão mais recente: {versao_recente.version.split('/')[-1]}")

  contar_shapes(Path("dados/dataset"))

9.5.4.4 Comparando una imagen de cada dataset

Los dos datasets poseen imágenes con resoluciones diferentes: 608×608 en GitHub y 640×640 en Roboflow. Para una comparación visual directa, las imágenes se redimensionan a la misma dimensión antes de ser mostradas lado a lado (Figura 9.38).

import cv2

if not chave.exists():
    print("Clave de Roboflow no encontrada: chave_roboflow.txt")
else:
    caminho1 = next((raiz / "train/images").iterdir())
    caminho2 = next((Path("dados/dataset") / "train/images").iterdir())

    img1 = mm.read(str(caminho1))
    img2 = mm.read(str(caminho2))

    # Redimensiona ambas para el mismo tamaño (el menor entre las dos)
    largura = min(img1.shape[1], img2.shape[1])
    altura = min(img1.shape[0], img2.shape[0])
    img1_r = cv2.resize(img1, (largura, altura))
    img2_r = cv2.resize(img2, (largura, altura))

    mm.show(
        [img1_r, img2_r],
        title=[f"Roboflow {img1.shape}", f"GitHub {img2.shape}"],
    )
Figura 9.38

9.5.4.5 Inferencia con el modelo entrenado

El modelo entrenado en la versión 6 se utiliza para realizar la inferencia sobre una imagen de prueba local. La predicción considera los umbrales de confianza y de superposición empleados por la supresión de no máximos (Non-Maximum Suppression, NMS), y el resultado se presenta en la imagen anotada de la Figura 9.39.

# version.model está obsoleto; usar version.models()

if not chave.exists():
    print("Clave de Roboflow no encontrada: chave_roboflow.txt")
else:
    modelo = versao.models()[0]

    img_path = "dados/dataset/test/images/00001.jpg"
    pred = modelo.predict(img_path, confidence=40, overlap=30)
    resp = pred.json()  # incluye los cuadros detectados en resp["predictions"]

    altura, largura, _ = mm.read(img_path).shape
    print("Dimensiones de la imagen de prueba:", (altura, largura))

    pred.save("resultado.jpg")  # imagen anotada

    mm.show(
        mm.read("resultado.jpg"),
        title="Resultado de la inferencia con el modelo de Roboflow",
        figsize=(6, 6)
    )
Figura 9.39

9.5.4.6 Evaluando las predicciones con IoU y clase

Roboflow devuelve cada caja con las coordenadas del centro (x, y) en píxeles y la clase predicha, mientras que las etiquetas locales (datos/conjunto_de_datos/prueba/etiquetas/00001.txt) siguen el formato YOLO, con centro y dimensiones normalizadas en el intervalo [0, 1]. Antes de la comparación mediante mm.IoU, las cajas deben convertirse al mismo formato, con las coordenadas de la esquina superior izquierda y las dimensiones expresadas en píxeles.

Una predicción solo se considera correcta cuando la clase predicha coincide con la clase de la caja real y su Intersection over Union (IoU) es mayor o igual al umbral definido, adoptándose, en este ejemplo, 0,5 (50%) como valor predeterminado.

ImportanteEl class_id de Roboflow no corresponde al índice de las etiquetas locales

En la exportación, Roboflow reordena las clases en orden alfabético en el data.yaml, independientemente del orden utilizado en el proyecto original, mantenido en el data.yaml del GitHub. Así, class_id = 0 corresponde a Circulo en la respuesta de la API, mientras que el mismo índice corresponde a Triangulo en las etiquetas locales.

Por ello, la comparación debe realizarse por el nombre de la clase (p["class"]), convirtiéndolo posteriormente al índice correspondiente en la lista local. Los class_id no deben compararse directamente.

# resp, ancho y altura se definieron en la celda anterior

# Orden de clases usado en las etiquetas locales (datos/dataset/*/labels/*.txt)
CLASSES_LOCAIS = ["Triangulo", "Quadrado", "Pentagono", "Hexagono",
                   "Heptagono", "Circulo", "Elipse"]

def predicao_correta(pred: tuple, real: tuple, limiar: float = 0.5) -> bool:
    """Verdadero si misma clase y mm.IoU(caja_pred, caja_real) >= umbral."""
    classe_pred, caixa_pred = pred
    classe_real, caixa_real = real
    return classe_pred == classe_real and mm.IoU(caixa_pred, caixa_real) >= limiar

def caixa_roboflow(p: dict) -> tuple:
    """Convierte la predicción de Roboflow a (clase, (x, y, w, h))."""
    caixa = (p["x"] - p["width"] / 2, p["y"] - p["height"] / 2,
             p["width"], p["height"])
    # usa el nombre de la clase (no el class_id!) para hacer coincidir con el orden local
    classe = CLASSES_LOCAIS.index(p["class"])
    return (classe, caixa)

def carrega_labels_yolo(caminho_txt: str, largura: int, altura: int) -> list:
    """Lee etiquetas YOLO (normalizadas) y convierte a (clase, (x, y, w, h))."""
    caixas = []
    with open(caminho_txt) as f:
        for linha in f:
            classe, xc, yc, w, h = map(float, linha.split())
            w_px, h_px = w * largura, h * altura
            x_px = xc * largura - w_px / 2
            y_px = yc * altura - h_px / 2
            caixas.append((int(classe), (x_px, y_px, w_px, h_px)))
    return caixas

if not chave.exists():
    print("Clave de Roboflow no encontrada: chave_roboflow.txt")
else:
    caixas_pred = [caixa_roboflow(p) for p in resp["predictions"]]
    caixas_real = carrega_labels_yolo(
        "dados/dataset/test/labels/00001.txt", largura, altura
    )

    acertos = sum(
        any(predicao_correta(cp, cr, limiar=0.5) for cr in caixas_real)
        for cp in caixas_pred
    )
    print(f"{acertos}/{len(caixas_pred)} predicciones correctas (clase + IoU >= 50%)")

Para visualizar el resultado, cada predicción se dibuja sobre la imagen: en verde cuando es un acierto (clase + IoU ≥ umbral) y en rojo cuando es un error, como se muestra en Figura 9.40.

import cv2

VERDE, VERMELHO = (0, 255, 0), (255, 0, 0)

if not chave.exists():
    print("Clave de Roboflow no encontrada: chave_roboflow.txt")
else:
    img_acertos = mm.read(img_path).copy()

    if not chave.exists():
        print("Clave de Roboflow no encontrada: chave_roboflow.txt")
    else:
        for cp in caixas_pred:
            classe_pred, (x, y, w, h) = cp
            correta = any(predicao_correta(cp, cr, limiar=0.5) for cr in caixas_real)
            cor = VERDE if correta else VERMELHO

            p1, p2 = (int(x), int(y)), (int(x + w), int(y + h))
            cv2.rectangle(img_acertos, p1, p2, cor, 2)
            cv2.putText(img_acertos, str(classe_pred), (p1[0], p1[1] - 5),
                        cv2.FONT_HERSHEY_SIMPLEX, 0.5, cor, 2)

    mm.show(
        img_acertos,
        title=f"{acertos}/{len(caixas_pred)} predições corretas "
            f"(classe + IoU >= 50%)",
        figsize=(6, 6)
    )
Figura 9.40

9.5.5 Aplicaciones Geométricas e Integradas

El capítulo concluye integrando dos pilares de la VC: la geometría proyectiva (estudiada en los Capítulos 6 y 8) y el aprendizaje profundo. La combinación de estos enfoques sustenta aplicaciones prácticas en el mundo real, como se ilustra a continuación.

9.5.5.1 Realidad Aumentada con Marcadores y Homografía

Imagina una cámara apuntando a una mesa donde alguien pegó un pequeño marcador ArUco. Dependiendo del ángulo de la cámara, ese marcador aparece rotado, inclinado, en perspectiva — nunca perfectamente cuadrado. Es precisamente esa distorsión la que la homografía sabe “leer” y deshacer (o, en nuestro caso, replicar para una nueva imagen).

El flujo completo de una aplicación de RA basada en marcadores sigue tres pasos:

  1. Ambientación: el marcador se inserta en una escena real, sufriendo una transformación de perspectiva (simulando el ángulo de la cámara).
  2. Detección: el algoritmo localiza el marcador en la escena y recupera las coordenadas exactas de sus 4 esquinas con cv2.aruco.ArucoDetector.
  3. Sustitución: con la homografía entre el marcador “ideal” y el marcador “detectado”, se proyecta una nueva imagen virtual exactamente sobre el área del marcador — como si este se hubiera transformado en una ventana hacia otro contenido, tal como muestra la Figura 9.41.
Nota

Detalle técnico importante: el ArUco necesita un margen blanco alrededor del patrón (la “zona de silencio”) para que el detector pueda diferenciar el marcador del fondo. Por ello, el código siguiente añade un borde con cv2.copyMakeBorder y utiliza interpolación cv2.INTER_NEAREST al deformar la imagen, evitando que la rotación difumine los cuadraditos blancos y negros e impida la detección.

# 1. Generación del marcador ArUco sintético, ya con margen blanco (zona de silencio)
# → este margen es esencial para que el detector pueda "ver" el marcador
dic = cv2.aruco.getPredefinedDictionary(cv2.aruco.DICT_4X4_50)
aruco_bruto = cv2.aruco.generateImageMarker(dic, 7, 200)
aruco_gray = cv2.copyMakeBorder(
    aruco_bruto, 40, 40, 40, 40, cv2.BORDER_CONSTANT, value=255
)  # 200 -> 280px, con 40px de marco blanco en cada lado
aruco = cv2.cvtColor(aruco_gray, cv2.COLOR_GRAY2BGR)
lado = aruco.shape[0]  # 280

# 2. Escena real de fondo, usando una imagen de ejemplo del skimage.data
fundo = cv2.cvtColor(skdata.coffee(), cv2.COLOR_RGB2BGR)
cena = cv2.resize(fundo, (640, 480))

# Esquinas del marcador "de frente" (src) y su posición rotada/inclinada en la escena (dst)
src = np.float32([[0, 0], [lado, 0], [lado, lado], [0, lado]])
dst = np.float32([[190, 160], [420, 70], [470, 330], [150, 370]])  # rotación + perspectiva

# 3. Proyecta el marcador (con bordes nítidos) sobre la escena real
H_cena, _ = cv2.findHomography(src, dst)
mask_cena = cv2.warpPerspective(
    np.full((lado, lado), 255, np.uint8), H_cena, (640, 480),
    flags=cv2.INTER_NEAREST,
)
cena[mask_cena > 0] = cv2.warpPerspective(
    aruco, H_cena, (640, 480), flags=cv2.INTER_NEAREST
)[mask_cena > 0]

# 4. Detección del marcador dentro de la escena (como lo haría una cámara)
det = cv2.aruco.ArucoDetector(dic, cv2.aruco.DetectorParameters())
corners, ids, _ = det.detectMarkers(cena)

assert ids is not None and len(corners) > 0, \
    "Marcador não detectado — confira iluminação/contraste da cena."

# 5. Imagen virtual (otra imagen del skimage.data) que va a "sustituir" al marcador
# Nota: usamos el cuadrado INTERNO del marcador (sin el margen) como área de proyección,
# entonces la homografía de la imagen virtual usa 'src' original (200x200), no el 'lado' con borde
src_interno = np.float32([[0, 0], [200, 0], [200, 200], [0, 200]])
virtual = cv2.resize(
    cv2.cvtColor(skdata.camera(), cv2.COLOR_RGB2BGR), (200, 200)
)

# Las esquinas detectadas corresponden al marcador CON el margen (280x280),
# entonces recalculamos H_ra usando 'src' con margen, para mantener la proyección coherente
H_ra, _ = cv2.findHomography(src, corners[0][0])

# La homografía detectada se aplica a la imagen virtual (redimensionada a 'lado')
virtual_grande = cv2.resize(virtual, (lado, lado))
ra = cena.copy()
mask_ra = cv2.warpPerspective(
    np.full((lado, lado), 255, np.uint8), H_ra, (640, 480), flags=cv2.INTER_NEAREST
)
ra[mask_ra > 0] = cv2.warpPerspective(
    virtual_grande, H_ra, (640, 480), flags=cv2.INTER_NEAREST
)[mask_ra > 0]

# Visualización: escena con marcador vs. escena con Realidad Aumentada aplicada
mm.show(
    [cv2.cvtColor(cena, cv2.COLOR_BGR2RGB), cv2.cvtColor(ra, cv2.COLOR_BGR2RGB)],
    titles=["Marcador en la Escena Real (rotado)", "Superposición Virtual mediante Homografía"],
    cols=2,
    figsize=(9, 4),
)
Figura 9.41: Realidad aumentada basada en marcador ArUco: marcador insertado en escena real y rotado, detectado y sustituido por imagen virtual mediante homografía.

Resumen del pipeline:

Etapa Qué hace Función clave
1. Generación Marcador ArUco con margen blanco generateImageMarker + copyMakeBorder
2. Ambientación Inserta marcador distorsionado en la escena findHomography + warpPerspective
3. Detección Localiza marcador y devuelve esquinas ArucoDetector.detectMarkers
4. Sustitución Proyecta imagen virtual sobre el marcador findHomography + warpPerspective

💡 Lección: que el detector “no encuentre nada” es común en VC. Pregúntate siempre: “¿di contraste y espacio suficientes?” — vale para ArUco, códigos QR y reconocimiento facial.

9.5.5.2 Fotogrametría y Referencia de Escala

La fotogrametría permite estimar dimensiones físicas de objetos a partir de imágenes digitales. Para ello, se utiliza un objeto de referencia con dimensiones conocidas, posicionado en la misma escena que el objeto de interés. Este procedimiento establece una relación entre distancias medidas en píxeles y sus correspondientes dimensiones en el mundo real.

Considere, por ejemplo, una tarjeta de crédito, cuyas dimensiones siguen el estándar internacional ISO/IEC 7810. Como su ancho es exactamente 8,56 cm, basta con determinar cuántos píxeles ocupa ese ancho en la imagen para calcular el factor de conversión entre píxeles y centímetros. Si la tarjeta corresponde a 140 píxeles, entonces cada píxel representará aproximadamente 0,061 cm. Este mismo factor de escala puede aplicarse para estimar las dimensiones de cualquier otro objeto ubicado en el mismo plano de la escena, tal como se ilustra en la Figura 9.42.

El procedimiento puede dividirse en dos etapas principales:

  1. Segmentación y bounding box: localizar, en la imagen, tanto el objeto de referencia como el objeto de interés, utilizando técnicas como segmentación por color, umbralización, detección de contornos o métodos de detección de objetos.
  2. Conversión a dimensiones físicas: calcular la razón \(\mathrm{cm/pixel}\) a partir del ancho conocido del objeto de referencia y utilizarla para convertir las medidas del objeto de interés de píxeles a centímetros.
Nota

Condición para mediciones confiables

La conversión entre píxeles y centímetros presupone que el objeto de referencia y el objeto de interés se encuentren aproximadamente en el mismo plano y a la misma distancia de la cámara. Bajo estas condiciones, la escala permanece prácticamente constante en toda la imagen. Diferencias de profundidad, inclinación de la cámara o distorsiones de la lente pueden introducir errores en las medidas estimadas.

COR_REFERENCIA = (200, 200, 200)  # Tarjeta de referencia (gris)
COR_OBJETO = (60, 60, 220)  # Objeto objetivo (rojo)

# Dibujo de la escena sintética
cena_medicao = np.full((300, 500, 3), 255, dtype=np.uint8)
cv2.rectangle(
    cena_medicao, (30, 200), (30 + 140, 200 + 88), COR_REFERENCIA, -1
)
cv2.rectangle(cena_medicao, (250, 100), (250 + 220, 100 + 150), COR_OBJETO, -1)


def caixa_delimitadora_por_cor(imagem_bgr, cor_bgr, tolerancia=40):
    diferenca = np.abs(imagem_bgr.astype(int) - np.array(cor_bgr)).sum(axis=2)
    mascara = (diferenca < tolerancia).astype(np.uint8) * 255
    contornos, _ = cv2.findContours(
        mascara, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE
    )
    maior_contorno = max(contornos, key=cv2.contourArea)
    return cv2.boundingRect(maior_contorno)


x_ref, y_ref, w_ref_px, h_ref_px = caixa_delimitadora_por_cor(
    cena_medicao, COR_REFERENCIA
)
x_obj, y_obj, w_obj_px, h_obj_px = caixa_delimitadora_por_cor(
    cena_medicao, COR_OBJETO
)

# Cálculo de escala física
LARGURA_REFERENCIA_CM = 8.56
razao_cm_por_px = LARGURA_REFERENCIA_CM / w_ref_px
largura_obj_cm = w_obj_px * razao_cm_por_px
altura_obj_cm = h_obj_px * razao_cm_por_px

# Dibujo de las cajas y mediciones estimadas
resultado = cena_medicao.copy()
cv2.rectangle(
    resultado, (x_ref, y_ref), (x_ref + w_ref_px, y_ref + h_ref_px), (0, 180, 0), 2
)
cv2.rectangle(
    resultado, (x_obj, y_obj), (x_obj + w_obj_px, y_obj + h_obj_px), (0, 180, 0), 2
)

cv2.putText(
    resultado,
    f"{LARGURA_REFERENCIA_CM:.2f} cm",
    (x_ref, y_ref - 8),
    cv2.FONT_HERSHEY_SIMPLEX,
    0.55,
    (0, 120, 0),
    2,
)

cv2.putText(
    resultado,
    f"{largura_obj_cm:.1f} x {altura_obj_cm:.1f} cm",
    (x_obj, y_obj - 8),
    cv2.FONT_HERSHEY_SIMPLEX,
    0.6,
    (0, 120, 0),
    2,
)

mm.show(
    [
        cv2.cvtColor(cena_medicao, cv2.COLOR_BGR2RGB),
        cv2.cvtColor(resultado, cv2.COLOR_BGR2RGB),
    ],
    titles=[
        "Escena Original",
        "Medición por Referencia de Escala (Centímetros)",
    ],
    cols=2,
    figsize=(9, 4),
)
Figura 9.42: Medición de dimensiones físicas reales utilizando una tarjeta de referencia de escala conocida (8,56 cm) renderizada. El rectángulo gris representa la tarjeta de referencia y el rectángulo azul representa el objeto objetivo. Las dimensiones estimadas del objeto se muestran en centímetros.

Resumen del pipeline:

Etapa Qué hace Función clave
1. Escena sintética Dibuja la tarjeta de referencia y el objeto objetivo con colores distintos cv2.rectangle
2. Segmentación Aísla cada objeto por color y extrae su contorno cv2.findContours
3. Bounding Box Obtiene la caja delimitadora (posición y tamaño en píxeles) de cada objeto cv2.boundingRect
4. Escalado Convierte píxeles en centímetros usando el ancho conocido de la tarjeta Regla de tres: \(\text{cm/pixel} = \dfrac{8{,}56}{w_{ref\_px}}\)
5. Anotación Dibuja las cajas y muestra las medidas estimadas sobre la imagen cv2.rectangle + cv2.putText

💡 Aplicación en el mundo real: esta es exactamente la técnica utilizada por apps de e-commerce que estiman el tamaño de un producto a partir de una foto junto a una tarjeta, por sistemas agrícolas que miden frutas en cintas transportadoras, e incluso por pericias forenses que calculan dimensiones de vestigios en escenas del crimen — todo con la misma idea: una regla conocida dentro de la propia foto.

9.6 Resumen

Este capítulo, que cierra la Parte II del libro, presentó:

  • Convolución y pooling aprendidos: la misma operación matemática de convolución del Capítulo 3, pero con kernels tratados como parámetros ajustados mediante entrenamiento, en lugar de definidos manualmente;

  • Compartición de pesos y jerarquía de características como propiedades que hacen que las CNN sean eficientes y capaces de aprender representaciones cada vez más abstractas en capas sucesivas;

  • Entrenamiento de una CNN desde cero, con un rendimiento comparable — y no necesariamente superior — al de los clasificadores clásicos del Capítulo 7 en una base pequeña y simple, reforzando que la elección del método debe ser proporcional a la complejidad real del problema;

  • Transferencia de aprendizaje, demostrada experimentalmente como una estrategia eficaz para tareas con pocos datos etiquetados, reutilizando un extractor de características ya entrenado en una tarea relacionada, y sus limitaciones, evidenciadas por la transferencia negativa entre dominios muy distintos;

  • Aplicaciones a gran escala con modelos preentrenados de clasificación, detección (Faster R-CNN) y segmentación (DeepLabV3), siguiendo el mismo principio de transferencia de aprendizaje a escala industrial;

  • Transferencia de aprendizaje aplicada a la detección de objetos, ajustando un YOLO preentrenado en COCO para localizar y clasificar objetos geométricos sintéticos, ilustrando el mismo principio de congelamiento parcial en un dominio de origen y destino aún más distantes entre sí;

  • Segmentación semántica con U-Net, implementada y entrenada desde cero sobre un conjunto sintético de bajo contraste, superando una línea de base clásica de umbralización gracias a las conexiones de atajo entre codificador y decodificador;

  • Ingeniería de datos para Visión por Computador con Roboflow, utilizando un dataset y un modelo preentrenado para realizar inferencia en la detección de objetos geométricos, además de comparar conjuntos de datos con diferentes resoluciones, pero con las mismas clases de objetos;

  • La integración de geometría computacional (homografía y calibración) y aprendizaje profundo en dos aplicaciones reales que cierran el libro: realidad aumentada y fotogrametría.

9.7 🤖 Uso de Gemini Notebook como Tutor Complementario

En esta edición, se incentiva el uso de Gemini Notebook como herramienta complementaria de aprendizaje. Basado en inteligencia artificial, el sistema utiliza exclusivamente los documentos proporcionados por el autor como fuente de conocimiento, produciendo respuestas alineadas con el contenido y el enfoque adoptado a lo largo de este capítulo.

Importante🎓 Estudia con el Tutor Inteligente

🚀 ACCEDER A GEMINI NOTEBOOK: CAPÍTULO 09

🌐 Idioma y Lenguaje de Programación

El proyecto de este capítulo en Gemini Notebook se construyó únicamente con el texto en portugués y los ejemplos de código en Python. Si estás estudiando con la edición en inglés o francés, o siguiendo la ruta en C++, las respuestas del tutor pueden no corresponder exactamente con la versión que estás leyendo.

⚠️ Aviso sobre Contenido Generado por IA

Aunque es una herramienta valiosa de apoyo al estudio, Gemini Notebook puede eventualmente producir respuestas incompletas, imprecisas o incorrectas. Se recomienda validar la información consultando el material del capítulo, libros, artículos científicos y otras fuentes académicas confiables. Siempre que sea posible, ejecuta y experimenta con los ejemplos prácticos presentados a lo largo del texto para consolidar la comprensión de los conceptos.

9.8 Lista de Ejercicios

Los ejercicios siguientes consolidan los conceptos presentados en este capítulo mediante adaptaciones, experimentos y extensiones de los algoritmos desarrollados a lo largo del texto, utilizando las bibliotecas PyTorch, ultralytics y la biblioteca didáctica morph.

  1. (10%) Investigue el impacto de la profundidad en una arquitectura convolucional. Partiendo de la red de dos capas del Proyecto Práctico 1, añada una tercera capa convolucional con 32 filtros antes de las capas totalmente conectadas. Entrene la nueva arquitectura manteniendo el mismo número de épocas y la misma división de los datos. Compare la exactitud en el conjunto de prueba y el número total de parámetros entrenables en relación con la red original, discutiendo si el aumento de profundidad aportó un beneficio medible para imágenes de dimensión \(8 \times 8\).

  2. (15%) Evalúe el umbral de datos necesarios en el dominio de destino para que el entrenamiento de una CNN desde cero se vuelva competitivo con la transferencia de aprendizaje. Variando el número de muestras de entrenamiento disponibles en el dominio B para \(\{5, 10, 20, 40, 80\}\), mida la exactitud de prueba para ambas estrategias. Presente los resultados en un gráfico de líneas y determine a partir de qué volumen de datos el entrenamiento desde cero alcanza un rendimiento equivalente al extractor preentrenado.

  3. (15%) Investigue la estrategia de ajuste fino parcial (fine-tuning) en comparación con el congelamiento total de pesos. En el escenario de transferencia de aprendizaje entre dominios de dígitos, descongele la segunda capa convolucional (conv2) del extractor para que se actualice junto con la cabeza de clasificación durante el entrenamiento en el dominio B. Compare la exactitud obtenida con el congelamiento total y con el entrenamiento desde cero, discutiendo el compromiso entre capacidad de adaptación y riesgo de sobreajuste (overfitting).

  4. (20%) Evalúe la influencia de la profundidad del congelamiento (freeze) en el rendimiento de detectores YOLO sometidos a transferencia de aprendizaje. Utilizando el conjunto de datos sintético de formas geométricas, ejecute el ajuste fino variando el parámetro de congelamiento del backbone para \(\{0, 5, 10, 15\}\). Registre la métrica \(\text{mAP}_{50}\) en el conjunto de validación para cada configuración, presente los datos en una tabla y discuta si el congelamiento parcial es ventajoso cuando los dominios de origen (COCO) y de destino (formas geométricas) son significativamente distintos.

  5. (20%) Estudie la importancia de las conexiones de atajo (skip connections) en la arquitectura U-Net para segmentación semántica. Implemente una variación UNetSemAtalhos que funcione como un autoencoder convolucional tradicional, eliminando las concatenaciones entre las etapas del codificador y del decodificador. Entrene ambos modelos sobre la misma base de nódulos sintéticos, compare el IoU medio en el conjunto de validación y presente visualmente la diferencia en la precisión de los bordes segmentados por cada método.

  6. (20%) — Desafío: segmentación semántica con Roboflow. Utilice un proyecto de Roboflow del tipo instance segmentation, que contenga las siete clases de formas geométricas utilizadas en este capítulo. Exporte el dataset en el formato coco-segmentation y desarrolle un procedimiento para convertir los polígonos almacenados en los archivos _annotations.coco.json en máscaras semánticas multiclase, en las cuales cada píxel recibe el índice de la clase correspondiente y el valor 0 representa el fondo. Utilice las imágenes y máscaras resultantes para entrenar la UNetCompacta. Evalúe el IoU medio en el conjunto de prueba y compare visualmente las máscaras predichas con las anotaciones originales. Discuta las principales dificultades encontradas en la conversión de las anotaciones COCO a máscaras y los efectos de objetos superpuestos o pertenecientes a diferentes clases.

  7. (Bono – 10%) Desarrolle un sistema interactivo que combine detección de objetos (YOLO) con medición por referencia de escala (fotogrametría). Entrene el detector para identificar dos clases en una escena: una “Tarjeta de Referencia” (dimensión conocida de \(8{,}56\text{ cm} \times 5{,}39\text{ cm}\)) y un “Objeto Objetivo”. Al realizar la inferencia en una nueva imagen, utilice la dimensión en píxeles de la bounding box de la tarjeta detectada para convertir las dimensiones de la caja del objeto objetivo en centímetros. Muestre la imagen procesada con las etiquetas de clase, la probabilidad de confianza y las dimensiones físicas estimadas superpuestas.

  8. (Bono – 10%) Desarrolle un sistema de estimación de profundidad por visión estéreo a partir de dos imágenes de la misma escena obtenidas desde posiciones diferentes, simulando un par de cámaras estéreo. Considere que la distancia entre las dos posiciones de captura (baseline) sea conocida.

    Utilice uno de los métodos de detección de objetos presentados en el capítulo, como YOLO, para localizar los objetos de interés en las dos imágenes. Para cada detección, establezca la correspondencia entre el mismo objeto en las dos posiciones y determine su disparidad. A partir de la disparidad, del baseline y de los parámetros de la cámara, utilice la geometría estéreo para estimar la distancia de cada objeto respecto a las cámaras.

    Como extensión de la biblioteca didáctica morph, modifique el método showBoundBox para que, además de la clase y la confianza de la detección, presente sobre cada bounding box la distancia estimada del objeto. El resultado debe permitir visualizar, directamente en las imágenes, la clase, la exactitud (confianza) y la profundidad de cada objeto detectado.

    Presente las dos imágenes con las detecciones, las correspondencias entre los objetos, la imagen de disparidad y una representación de la profundidad estimada. Discuta cómo la distancia entre las cámaras, la precisión de la detección y de la correspondencia, la resolución de las imágenes y la posición del objeto en la escena influyen en la calidad de la estimación.

    Para la validación, utilice al menos un objeto cuya distancia a la cámara sea conocida. Compare la profundidad estimada con el valor real y reporte el error absoluto y el error relativo. Discuta también las limitaciones del método cuando un objeto no se detecta correctamente en las dos imágenes o cuando la correspondencia entre las regiones observadas es ambigua.

9.9 Cierre de la Parte II

Este capítulo concluye la Parte II del libro y cierra la secuencia de contenidos iniciada en el Capítulo 6, dedicada a la representación, detección, descripción y correspondencia de características en imágenes. A lo largo de estos capítulos, se presentaron métodos clásicos de VC basados en características diseñadas manualmente, como Sobel, LBP, HOG, ORB y Haar Cascade, así como métodos fundamentados en características aprendidas automáticamente, representados por las CNN.

Los ejemplos y experimentos desarrollados evidencian que ninguna de estas aproximaciones es universalmente superior. La elección de la técnica más adecuada depende de las características del problema, de la disponibilidad de datos para entrenamiento, de los requisitos de precisión y de las restricciones computacionales de la aplicación. En problemas bien estructurados y con pocos datos, los descriptores clásicos frecuentemente ofrecen soluciones simples y eficientes. En contrapartida, las tareas más complejas tienden a beneficiarse de la capacidad de aprendizaje proporcionada por las CNN.

Diversas direcciones de estudio pueden profundizar los conceptos presentados en esta parte del libro, entre las cuales se destacan:

  • Arquitecturas modernas de CNN, como ResNet, EfficientNet y Vision Transformers, que amplían la capacidad de representación y el rendimiento en tareas de clasificación y reconocimiento visual;
  • Detección y segmentación de objetos, con especial atención a las familias YOLO y a los modelos de segmentación basados en prompts, como el Segment Anything;
  • Reconstrucción tridimensional y SLAM (Simultaneous Localization and Mapping), que utilizan múltiples imágenes para estimar la geometría de la escena y la trayectoria de cámaras en movimiento;
  • Modelos generativos de imágenes, como redes adversarias generativas (GAN) y modelos de difusión, capaces de sintetizar imágenes realistas a partir de ejemplos o descripciones textuales.

Los fundamentos desarrollados a lo largo de la Parte II constituyen la base para estas y otras áreas avanzadas de la VC, en las cuales la representación adecuada de la información visual permanece como elemento central para el análisis y la comprensión de imágenes.

Referencias del Capítulo

Los conceptos y algoritmos presentados en este capítulo se fundamentaron en referencias clásicas y contemporáneas de la literatura de Aprendizaje Profundo aplicado a la VC:

  • Mcculloch (1943), para la propuesta de la primera abstracción matemática y lógica del neurona artificial, fundamentando las bases conceptuales del procesamiento neural computacional.
  • Rosenblatt (1958), para la formulación original del Perceptrón, modelo precursor del neurona artificial utilizado en las arquitecturas modernas de aprendizaje profundo.
  • Goodfellow (2016) y Lecun (2015), para los fundamentos de redes neuronales, convolución, funciones de activación y entrenamiento de modelos profundos.
  • Bishop (2006), para los conceptos rigurosos de reconocimiento de patrones, probabilidad, estimación de máxima verosimilitud y métodos estadísticos aplicados al aprendizaje automático.
  • Ronneberger (2015), para la arquitectura U-Net, utilizada en la segmentación semántica con conexiones de atajo entre codificador y decodificador.
  • Redmon (2016), para la arquitectura YOLO (You Only Look Once), utilizada en los experimentos de detección de objetos con transferencia de aprendizaje.
  • Ren (2015), para la arquitectura Faster R-CNN, empleada como modelo preentrenado de detección de objetos.
  • He (2016), para la arquitectura ResNet, base de diversos extractores de características preentrenados utilizados en este capítulo.
  • Chen (2018), para la arquitectura DeepLabV3, utilizada como modelo preentrenado de segmentación semántica.
  • Kirillov (2023), para el modelo Segment Anything (SAM), mencionado como dirección de estudio para segmentación promptable.
  • {google} (2025), referente a la herramienta Gemini Notebook, utilizada en la elaboración del infográfico de síntesis del capítulo y disponible como apoyo complementario al estudio.

9.10 💻 Parte Práctica con Ejercicios de Programación

La presente lista de Ejercicios de Programación (EP) consolida las formulaciones teóricas presentadas a lo largo del Capítulo 9 — Aprendizaje Profundo para Visión por Computador — mediante una ruta práctica aplicada. A diferencia del entrenamiento de redes neuronales completas con PyTorch, que requiere tiempo de ejecución y, en ocasiones, GPU, los EP de este capítulo aislan las magnitudes intermedias de un pipeline real de aprendizaje profundo —la salida de una única capa convolucional, el resultado de una operación de pooling, el conteo de parámetros entrenables de una arquitectura, la superposición entre cajas delimitadoras candidatas, la calidad de una máscara de segmentación y el filtro de supresión de no máximos—, permitiendo validar manualmente cada etapa del razonamiento sin depender de bibliotecas de aprendizaje automático ni de entrenamiento real.

El encadenamiento de los ejercicios reproduce el flujo conceptual del capítulo y crece en dificultad a cada paso: se comienza con el cálculo manual de la salida de una capa convolucional aprendida (🟢), a partir de un kernel y un sesgo ya entrenados; se avanza hacia la operación de pooling (🟢, máximo y promedio), que reduce la resolución espacial entre bloques convolucionales; se continúa con el conteo de parámetros entrenables (🟡) de una arquitectura CNN completa, evidenciando por qué el compartimiento de pesos vuelve a estas redes mucho más económicas que una capa totalmente conectada equivalente; se profundiza en el cálculo de Intersección sobre Unión (IoU) y en la Supresión de No Máximos (NMS) (🟡), etapa de posprocesamiento común a detectores como Faster R-CNN y YOLO; se sigue con la evaluación de máscaras de segmentación (🟠) con las mismas métricas de IoU y Dice usadas para comparar la U-Net con la línea base morfológica clásica; y se concluye con un pipeline integrado (🔴), que une la salida de un detector de objetos (después de NMS) con una medición del mundo real por referencia de escala —el mismo principio de la fotogrametría estudiada en la integración final del capítulo.

Siempre que tenga sentido, cada ejercicio señala métodos de la biblioteca didáctica morph.py (la misma usada a lo largo del capítulo, importada como mm) que resuelven una etapa del problema o que sirven de referencia para verificar tus propios cálculos —sin, no obstante, sustituir el razonamiento que debes implementar.

ImportanteDirectrices para la Resolución de los Ejercicios de Programación

En todos los ejercicios de este capítulo, las etapas de discretización o redondeo numérico deben emplear el redondeo estándar al entero más cercano (round half away from zero), mitigando ambigüedades en valores con fracción exactamente igual a \(0{,}5\). Salvo indicación explícita en contrario: (i) la operación de “convolución” sigue la convención adoptada por los frameworks de aprendizaje profundo —correlación cruzada, sin inversión espacial del kernel, exactamente como se presentó en la Sección “Capa Convolucional”; (ii) el relleno (padding) se realiza con ceros; (iii) las cajas delimitadoras se especifican en el formato esquina-a-esquina \((x_1, y_1, x_2, y_2)\), con \(x_1 < x_2\) e \(y_1 < y_2\); y (iv) los vectores/matrices siguen indexación desde \(0\), con la convención [fila][columna] para estructuras bidimensionales.

🎯 Objetivo de este Cuaderno

El cuaderno permite desarrollar, validar, organizar y probar soluciones de Ejercicios de Programación (EPs) en entornos interactivos, como Colab, con los mismos casos de prueba de Moodle, copiándolos allí solo al momento de registrar la nota oficial.

Descargar

Descargue morph.py y testsuite.py ejecutando la celda a continuación:

import os, urllib.request

url = "https://raw.githubusercontent.com/fzampirolli/pdi-vc/master/morph/config.py"
if not os.path.exists("config.py"):
    urllib.request.urlretrieve(url, "config.py")

import config
config.setup(testsuite=True)
from morph import mm
from testsuite import TestSuite
✅ Entorno listo. Morph: 1.1.9 | OpenCV: 5.0.0 | TestSuite: 1.1.2

Ejecutando los Tests

Para evaluar los tests, ejecute TestSuite("EP09_01.extensión").run() en una nueva celda, reemplazando la extensión por la del lenguaje utilizado (.py, .java, .c, .cpp, .js o .r). El sistema descarga los casos de prueba desde GitHub, ejecuta el programa y calcula la nota automáticamente.

Para probar código Python directamente, sin guardar archivo, use run_code(codigo) pasando el código como string en una variable codigo:

codigo = """
# ... su código aquí ...
"""
TestSuite("EP09_01").run_code(codigo)

9.10.1 EP09_01 🟢 Convolución 2D Manual (Forward de una Capa Aprendida)

PyTorch, presentado en este capítulo, ejecuta nn.Conv2d(x) en una única llamada — pero detrás de ella solo está la correlación cruzada entre un kernel (ya entrenado) y una vecindad de la entrada, seguida de la suma de un sesgo y de una activación, exactamente como se formalizó en la Sección “Capa Convolucional”. La diferencia esencial respecto a la convolución de kernels fijos del Capítulo 3 es que, aquí, los valores del kernel y del sesgo ya vienen listos (como si hubieran sido aprendidos por gradiente), y te corresponde a ti reproducir manualmente la pasada directa (forward pass) que el framework ejecuta internamente.

Antes de entrenar una CNN real, se te ha encargado implementar esta pasada directa desde cero, para una única capa convolucional con un único canal de entrada y un único filtro de salida, incluyendo soporte para padding y stride arbitrarios.

9.10.1.1 📋 Directrices de Implementación

  1. Entrada: Leer las dimensiones \(H \times W\) del mapa de características de entrada y, a continuación, sus \(H \times W\) valores reales.

  2. Kernel y sesgo: Leer las dimensiones \(k_h \times k_w\) del kernel (ya entrenado), sus valores reales, y el sesgo \(b\) (real, escalar).

  3. Hiperparámetros: Leer el padding \(p\) (entero, número de ceros añadidos en cada borde) y el stride \(s\) (entero, paso del deslizamiento).

  4. Relleno: Añadir \(p\) ceros en cada uno de los cuatro bordes del mapa de entrada antes de la correlación.

  5. Correlación cruzada: Para cada posición de salida \((i, j)\), calcular \[ z(i,j) = b + \sum_{u=0}^{k_h-1} \sum_{v=0}^{k_w-1} K(u,v) \cdot X_{pad}(i \cdot s + u,\; j \cdot s + v), \] recorriendo la entrada sin invertir el kernel (convención de los frameworks de aprendizaje profundo, diferente de la convolución matemática clásica).

  6. Activación: Aplicar ReLU a cada valor: \(a(i,j) = \max(0, z(i,j))\).

  7. Dimensiones de salida: \(O_h = \lfloor (H + 2p - k_h)/s \rfloor + 1\) y \(O_w = \lfloor (W + 2p - k_w)/s \rfloor + 1\).

  8. Salida: Imprimir \(O_h\) y \(O_w\) en la primera línea, seguidos de \(O_h\) líneas con \(O_w\) valores reales cada una (el mapa de características de salida, ya con ReLU aplicada), formateados con 4 decimales.

9.10.1.2 📌 Restricciones Computacionales

  • Un canal de entrada, un filtro de salida: no es necesario manejar múltiples canales ni múltiples filtros en esta versión simplificada.
  • Sin inversión del kernel: implementa correlación cruzada, no la convolución matemática clásica con kernel invertido — es esa la operación que PyTorch (y la mayoría de los frameworks) llama “convolución”.
  • Relleno con ceros: los \(p\) píxeles añadidos en cada borde valen siempre \(0\).
  • Formato: todos los valores de salida deben tener exactamente 4 decimales, incluso cuando el valor es entero (ej.: 2.0000).

9.10.1.3 🧠 Fundamentación Teórica

Elemento Papel en la capa convolucional
Kernel \(K\) Parámetros aprendidos por gradiente, análogos a los coeficientes de un filtro fijo del Capítulo 3, pero ajustados por retropropagación
Sesgo \(b\) Desplazamiento aprendido, sumado tras la correlación — permite que la neurona “se active” incluso con entrada nula
Padding Controla la dimensión espacial de salida y evita la pérdida de información en los bordes en cada capa
Stride Controla el paso del desplazamiento; valores \(> 1\) reducen la resolución espacial, como una forma de submuestreo integrado en la propia convolución
ReLU Introduce no linealidad tras la combinación lineal, exactamente como en la Sección “Función de Activación”

9.10.1.4 🧩 Métodos del morph.py que pueden ayudar

  • mm.readImg(h, w, dtype='float') — lee directamente una matriz \(h \times w\) de valores reales de la entrada estándar, ahorrando el parseo manual del mapa de características y del kernel.
  • mm.correlacao0(f, kernel, bias) — implementa la misma suma de correlación cruzada + sesgo que vas a calcular a mano, pero sin soporte para padding o stride, y convierte el resultado a uint8 (trunca valores negativos y decimales). Puede servir como referencia conceptual o para comprobar el caso más simple (\(p=0\), \(s=1\)), pero no sustituye tu implementación completa — que debe preservar signo, decimales, padding, stride y ReLU.

9.10.1.5 📦 Especificación de Entrada y Salida (VPL)

Entrada:

  • Línea 1: Enteros \(H\) y \(W\).
  • Siguientes \(H\) líneas: \(W\) valores reales cada una (mapa de entrada).
  • Siguiente línea: Enteros \(k_h\) y \(k_w\).
  • Siguientes \(k_h\) líneas: \(k_w\) valores reales cada una (kernel).
  • Siguiente línea: Real \(b\) (sesgo).
  • Siguiente línea: Enteros \(p\) y \(s\).

Salida:

  • Línea 1: Enteros \(O_h\) y \(O_w\).
  • Siguientes \(O_h\) líneas: \(O_w\) valores reales cada una, con 4 decimales.

9.10.1.6 📌 Ejemplos

Entrada Salida Observación
3 3
1 2 0
0 1 2
1 0 1
2 2
1 1
1 1
-2
0 1
2 2
2.0000 3.0000
0.0000 2.0000
Padding 0, stride 1: salida \(2\times2\) sin relleno.
3 3
1 2 0
0 1 2
1 0 1
2 2
1 0
0 1
0
1 2
2 2
1.0000 0.0000
1.0000 2.0000
Padding 1, stride 2: entrada rellenada con ceros antes de la correlación.
🎮 Simulador: Convolución 2D Manual 🟢 correlación cruzada + sesgo + ReLU

Entrada 4×4 fija, kernel 2×2 fijo (resaltado en azul) — ajuste padding (p), stride (s) y sesgo (b), exactamente los parámetros que EP09_01 pide en la entrada, y observa cómo cambian el tamaño y los valores de la salida.

Padding (p)
Stride (s)
Sesgo (b)
(0,0)
Entrada X rellenada (con padding)
original padding (0) ventana actual
Kernel K (2×2)
Salida Y = ReLU(X⊛K + b)

💡 Cada posición del control deslizante revela una celda de la matriz de salida. Recorre todas las posiciones para completar el mapa de salida. Cambiar p, s o b reinicia la exploración, porque el mapa de salida cambia de tamaño y/o de valores.

Figura 9.43: Simulador EP09_01: Convolución 2D Manual (correlación cruzada + sesgo + ReLU, con padding y stride ajustables)
%%writefile EP09_01.py
# Código Python
Overwriting EP09_01.py
TestSuite("EP09_01.py").run()
✔️ EP09_01.cases ya existe en casos/
📋 3 caso(s) cargado(s) de casos/EP09_01.cases

🔍 Probando Python: EP09_01.py
⚠️ EP09_01.py: archivo vacío (menos de 3 líneas). Pruebas omitidas.

9.10.2 EP09_02 🟢 Pooling Manual (Máximo y Media)

Entre bloques convolucionales, la arquitectura típica de una CNN intercala capas de pooling, que reducen la resolución espacial del mapa de características sin introducir nuevos parámetros entrenables — a diferencia de la convolución, el pooling no tiene pesos: solo resume cada ventana de la entrada a un único valor, mediante un máximo o una media, exactamente como se formalizó en la Sección “Pooling”.

Se le ha encargado implementar esta operación a partir de una ventana deslizante cuadrada, sin superposición parcial en los bordes (solo ventanas completas), soportando los dos tipos más comunes: max (preserva el valor más sobresaliente, típicamente usado para retener bordes y texturas fuertes) y avg (suaviza la región, preservando información de intensidad media).

9.10.2.1 📋 Directrices de Implementación

  1. Entrada: Leer las dimensiones \(H \times W\) del mapa de características de entrada y sus \(H \times W\) valores reales.
  2. Ventana: Leer los enteros \(k\) (tamaño de la ventana cuadrada \(k \times k\)) y \(s\) (stride).
  3. Tipo: Leer una string, max o avg, indicando el tipo de pooling.
  4. Sin relleno: Esta operación no utiliza padding; las ventanas que sobrepasarían el borde de la entrada se descartan.
  5. Cálculo: Para cada posición de salida \((i,j)\), calcular el máximo o la media de los \(k \times k\) valores de la ventana correspondiente, comenzando en \((i \cdot s,\, j \cdot s)\).
  6. Dimensiones de salida: \(O_h = \lfloor (H - k)/s \rfloor + 1\) y \(O_w = \lfloor (W - k)/s \rfloor + 1\).
  7. Salida: Imprimir \(O_h\) y \(O_w\) en la primera línea, seguidos de \(O_h\) líneas con \(O_w\) valores reales cada una, formateados con 4 decimales.

9.10.2.2 📌 Restricciones Computacionales

  • Ventana cuadrada: \(k \times k\), sin soporte para ventanas rectangulares en esta versión.
  • Sin padding: solo se consideran ventanas completamente contenidas en la entrada — las dimensiones que “sobran” simplemente se descartan.
  • avg usa división real: la media es siempre \(\text{suma}/k^2\), incluso cuando el resultado tiene muchos decimales — redondee solo en el formato final, conforme a la directriz general del capítulo.
  • Formato: todos los valores de salida con exactamente 4 decimales.

9.10.2.3 🧠 Fundamentación Teórica

Elemento Rol en la arquitectura
Pooling máximo Preserva la activación más fuerte de la ventana; común después de capas convolucionales para retener bordes y texturas sobresalientes
Pooling medio Suaviza la región, preservando la intensidad media; común en capas finales (global average pooling)
Ausencia de parámetros Diferencia el pooling de la convolución: reduce la resolución espacial sin costo adicional de entrenamiento
Reducción de resolución Contribuye a la invariancia a pequeñas traslaciones y a la reducción del costo computacional de las capas siguientes

9.10.2.4 🧩 Métodos de morph.py que pueden ayudar

El morph.py no implementa pooling con submuestreo directamente, pero dos familias de operaciones muestran la misma idea desde otra óptica, útil para verificar su intuición:

  • mm.dil(f, Bc) / mm.dil0(f, B) — dilatación morfológica: reemplaza cada píxel por el máximo de su vecindad definida por el elemento estructurante \(B\) (ej.: mm.sebox(n) para una ventana \((2n+1)\times(2n+1)\)). Es, conceptualmente, un “max-pooling sin submuestreo” (produce una imagen del mismo tamaño, en lugar de reducida).
  • mm.blur(f, N) — suavizado por media en una ventana \(N \times N\), análoga al avg-pooling, también sin reducción de resolución.
  • mm.readImg(h, w, dtype='float') — útil para leer el mapa de entrada en punto flotante.

9.10.2.5 📦 Especificación de Entrada y Salida (VPL)

Entrada:

  • Línea 1: Enteros \(H\) y \(W\).
  • Siguientes \(H\) líneas: \(W\) valores reales cada una.
  • Siguiente línea: Enteros \(k\) y \(s\).
  • Siguiente línea: max o avg.

Salida:

  • Línea 1: Enteros \(O_h\) y \(O_w\).
  • Siguientes \(O_h\) líneas: \(O_w\) valores reales cada una, con 4 decimales.

9.10.2.6 📌 Ejemplos

Entrada Salida Observación
4 4
1 3 2 4
5 6 1 2
2 1 0 3
4 2 5 1
2 2
max
2 2
6.0000 4.0000
4.0000 5.0000
Pooling máximo, ventana \(2\times2\), stride 2.
4 4
1 3 2 4
5 6 1 2
2 1 0 3
4 2 5 1
2 2
avg
2 2
3.7500 2.2500
2.2500 2.2500
Pooling medio sobre las mismas ventanas.
🎮 Simulador: Pooling Manual 🟢 senza padding, finestre complete

Ingresso 4×4 fisso — regola la dimensione della finestra (k), lo stride (s) e il tipo, esattamente i parametri che EP09_02 legge in ingresso, e osserva come cambiano la dimensione e i valori dell'uscita.

Finestra (k)
Stride (s)
Tipo
(0,0)
Ingresso X (4×4)
fuori dalla finestra finestra attuale scartato (avanzo)
Uscita Y (pooling)

💡 Ogni posizione dello slider rivela una cella della matrice di uscita. Le celle grigio-tratteggiate nell'ingresso sono "avanzi" che nessuna finestra raggiunge — nota come ciò accade quando (H−k) non è multiplo di s. Cambiare k, s o il tipo riavvia l'esplorazione.

Figura 9.44: Simulador EP09_02: Pooling Manual (máximo vs. média, con ventana k y stride s ajustables)
%%writefile EP09_02.py
# Código Python
Overwriting EP09_02.py
TestSuite("EP09_02.py").run()
✔️ EP09_02.cases ya existe en casos/
📋 4 caso(s) cargado(s) de casos/EP09_02.cases

🔍 Probando Python: EP09_02.py
⚠️ EP09_02.py: archivo vacío (menos de 3 líneas). Pruebas omitidas.

9.10.3 EP09_03 🟡 Conteo de Parámetros Entrenables de una CNN

Este EP formaliza el conteo de parámetros entrenables de una CNN. Dada la descripción textual de una pequeña arquitectura, compuesta por capas convolucionales, de pooling y totalmente conectadas, determine, para cada capa, el número de parámetros entrenables y el total de la red.

La arquitectura debe interpretarse secuencialmente: la salida de una capa convolucional se convierte en la entrada de la siguiente capa compatible. Así, el número de canales producidos por una capa CONV determina el número de canales de entrada (cin) de la capa convolucional siguiente.

En una capa convolucional, es importante distinguir canales de entrada y canales de salida:

  • \(c_{in}\) (channels in) es el número de canales que entran en la capa. Una imagen en tonos de gris posee \(c_{in}=1\), mientras que una imagen RGB posee \(c_{in}=3\). En una capa convolucional intermedia, cin normalmente es igual al número de canales producidos por la capa CONV anterior.
  • \(c_{out}\) (channels out) es el número de canales producidos por la capa. Es igual al número de filtros utilizados. Por lo tanto, si una capa posee 16 filtros, produce \(c_{out}=16\) canales.

Por ejemplo, considere la secuencia:

CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1
POOL
FC 784 10 1

La primera convolución recibe una imagen con un canal y produce 8 canales. Después del pooling, la segunda convolución recibe esos 8 canales y produce 16 canales. La capa POOL no altera el número de canales, solo puede reducir las dimensiones espaciales. La capa FC recibe la cantidad de entradas informada en la propia descripción.

Cada filtro convolucional posee dimensiones

\[ k_h \times k_w \times c_{in}. \]

Así, una capa con \(c_{out}\) filtros posee

\[ k_h \cdot k_w \cdot c_{in} \cdot c_{out} \]

pesos. Si hay sesgo, se añade un parámetro para cada filtro, totalizando más \(c_{out}\) parámetros.

El punto central de este ejercicio es observar que la cantidad de parámetros de una capa convolucional no depende de las dimensiones espaciales (\(H \times W\)) del mapa de características. Esto ocurre debido al comparticionamiento de pesos: el mismo filtro se reutiliza en diferentes posiciones de la entrada.

9.10.3.1 📋 Directrices de Implementación

  1. Entrada: Leer el entero \(L\) (número de capas de la arquitectura, en el orden en que se aplican).

  2. Capas: Leer \(L\) líneas, cada una describiendo una capa en uno de los tres formatos:

    • CONV kh kw cin cout bias — capa convolucional con kernel \(k_h \times k_w\), \(c_{in}\) canales de entrada, \(c_{out}\) canales de salida y bias (0 o 1), indicando si hay sesgo por filtro;
    • POOL — capa de pooling (máximo o medio), que no posee parámetros entrenables y preserva el número de canales;
    • FC in out bias — capa totalmente conectada con in entradas, out salidas y bias (0 o 1), indicando si hay sesgo por neurona.
  3. Consistencia entre capas CONV: en una secuencia de capas convolucionales, el cin de una capa debe corresponder al cout de la capa convolucional anterior. Una capa POOL no altera ese número de canales.

    Por ejemplo:

    CONV 3 3 1 8 1
    POOL
    CONV 3 3 8 16 1

    La primera CONV produce 8 canales, que son recibidos por la segunda CONV. Por lo tanto, en la segunda capa, cin=8 y cout=16.

  4. Parámetros de una capa CONV:

    Cada uno de los \(c_{out}\) filtros posee \(k_h \cdot k_w \cdot c_{in}\) pesos. Por lo tanto,

    \[ P_{\mathrm{CONV}} = k_h \cdot k_w \cdot c_{in} \cdot c_{out} + c_{out}\cdot\text{bias}. \]

  5. Parámetros de una capa FC:

    \[ P_{\mathrm{FC}} = \text{in}\cdot\text{out} + \text{out}\cdot\text{bias}. \]

  6. Parámetros de una capa POOL: siempre \(0\).

  7. Total de la red: sumar los parámetros entrenables de todas las capas.

  8. Salida: Para cada capa, en el orden de lectura, imprimir Camada i: P, donde \(i\) comienza en \(1\) y \(P\) es el número de parámetros de esa capa. Al final, imprimir Total: T.

9.10.3.2 📐 Ejemplo para entender cin y cout

Considere la secuencia:

CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1

En la primera capa:

  • cin=1: entra un canal;
  • cout=8: existen 8 filtros y, por lo tanto, salen 8 canales.

Cada filtro posee

\[ 3\cdot3\cdot1=9 \]

pesos. Como existen 8 filtros:

\[ 9\cdot8=72 \]

pesos. Con un sesgo por filtro:

\[ 72+8=80. \]

En la segunda capa:

  • cin=8: entran los 8 canales producidos por la primera CONV;
  • cout=16: existen 16 filtros y, por lo tanto, salen 16 canales.

Cada filtro posee

\[ 3\cdot3\cdot8=72 \]

pesos. Como existen 16 filtros:

\[ 72\cdot16=1152 \]

pesos. Con 16 sesgos:

\[ 1152+16=1168. \]

Así, las dos capas poseen, respectivamente, 80 y 1168 parámetros entrenables.

Observe que cout no es \(cin\) multiplicado por el número de filtros. El número de filtros es exactamente cout: cada filtro combina todos los canales de entrada y produce un único canal de salida.

9.10.3.3 📌 Restricciones Computacionales

  • Independencia de la dimensión espacial: la entrada no informa \(H \times W\). El conteo de una capa CONV depende solo de kh, kw, cin y cout.
  • Consistencia de los canales: para dos capas CONV consecutivas, el cin de la segunda debe ser igual al cout de la primera. Una capa POOL preserva el número de canales.
  • bias siempre 0 o 1: multiplique directamente el término de sesgo por ese valor.
  • Capas POOL sin argumentos adicionales: la línea contiene solo la palabra POOL.
  • Capas FC: el número de entradas in se proporciona explícitamente. No es necesario calcular las dimensiones espaciales producidas por las capas anteriores.
  • Todos los valores numéricos de entrada son enteros no negativos.

9.10.3.4 🧠 Fundamentación Teórica

Elemento Papel en el conteo de parámetros
\(c_{in}\) Número de canales recibidos por la capa
\(c_{out}\) Número de filtros y, por lo tanto, de canales producidos por la capa
Filtro convolucional Cada filtro posee \(k_h \cdot k_w \cdot c_{in}\) pesos y produce un canal de salida
Compartición de pesos El mismo filtro se reutiliza en diferentes posiciones de la entrada, haciendo el conteo independiente de \(H \times W\)
Sesgo Un único parámetro adicional por filtro (CONV) o por neurona (FC)
Pooling Puede alterar \(H \times W\), pero no posee parámetros entrenables y preserva el número de canales
Capa FC Posee un peso para cada combinación entre entrada y neurona de salida

9.10.3.5 🧩 Métodos del morph.py que pueden ayudar

Este ejercicio es puramente aritmético y no utiliza directamente funciones del morph.py. El conteo puede, sin embargo, verificarse en una arquitectura real implementada en PyTorch mediante:

sum(p.numel() for p in modelo.parameters())

Esta expresión contabiliza los parámetros del modelo, incluyendo pesos y sesgos.

9.10.3.6 📦 Especificación de Entrada y Salida (VPL)

Entrada:

  • Línea 1: Entero \(L\).
  • Próximas \(L\) líneas: descripción de cada capa, en el formato CONV kh kw cin cout bias, POOL o FC in out bias.

Salida:

  • \(L\) líneas en el formato Camada i: P.
  • Última línea: Total: T.

9.10.3.7 📌 Ejemplos

Entrada Salida Observación
3
CONV 3 3 1 8 1
POOL
FC 1352 10 1
Camada 1: 80
Camada 2: 0
Camada 3: 13530
Total: 13610
Red simple con una convolución, pooling y capa de clasificación.
5
CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1
POOL
FC 400 10 1
Camada 1: 80
Camada 2: 0
Camada 3: 1168
Camada 4: 0
Camada 5: 4010
Total: 5258
Pequeña CNN con dos convoluciones, dos poolings y una capa totalmente conectada.
6
CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1
POOL
FC 256 32 1
FC 32 10 1
Camada 1: 80
Camada 2: 0
Camada 3: 1168
Camada 4: 0
Camada 5: 8224
Camada 6: 330
Total: 9802
CNN pequeña con dos convoluciones, pooling intermedio y dos capas totalmente conectadas para clasificación.
🎮 Simulador: Conteo de Parámetros 🟡 compartilhamento de pesos
CONV Bloque azul POOL Cilindro verde FC Rombo naranja BATCH Pila roja 🖱️ Arrastra para mover capas
32×32
1
4
3
🧠 Visualización 3D
🖱️ Arrastra capas | Scroll zoom | P pausa
Figura 9.45: Simulador EP09_03: Conteo de Parámetros — Convolución vs. Capa Totalmente Conectada
%%writefile EP09_03.py
# Código Python
Overwriting EP09_03.py
TestSuite("EP09_03.py").run()
✔️ EP09_03.cases ya existe en casos/
📋 3 caso(s) cargado(s) de casos/EP09_03.cases

🔍 Probando Python: EP09_03.py
⚠️ EP09_03.py: archivo vacío (menos de 3 líneas). Pruebas omitidas.

9.10.4 EP09_04 🟡 Intersección sobre Unión (IoU) y Supresión de No-Máximos (NMS)

Los modelos de detección de objetos pueden producir varias cajas delimitadoras candidatas para un mismo objeto, con diferentes posiciones y puntuaciones de confianza. La etapa de posprocesamiento responsable de eliminar esas detecciones redundantes es la Supresión de No-Máximos (NMS), cuya operación fundamental utiliza la métrica de Intersección sobre Unión (IoU).

La NMS utiliza esta medida para decidir qué cajas deben mantenerse. En general, la caja con mayor confianza se selecciona primero; a continuación, las cajas que presentan una IoU por encima de un determinado umbral con la caja seleccionada se consideran redundantes y se eliminan. El proceso se repite hasta que no queden cajas candidatas.

En este ejercicio, deberás implementar el algoritmo de NMS desde cero, calculando la IoU entre cajas y aplicando sucesivamente el criterio de selección y supresión para producir el conjunto final de detecciones.

9.10.4.1 📋 Directrices de Implementación

  1. Entrada: Leer el entero \(N\) (número de cajas candidatas) y el umbral real \(\tau\) (umbral de IoU para la supresión), en la misma línea.

  2. Cajas: Leer \(N\) líneas, cada una con cinco valores reales:

    x1 y1 x2 y2 score

    donde \((x_1,y_1)\) representa la esquina superior izquierda, \((x_2,y_2)\) la esquina inferior derecha y score la puntuación de confianza.

  3. Intersección sobre Unión: Para dos cajas \(A\) y \(B\),

    \[ IoU(A,B)= \frac{\operatorname{Área}(A\cap B)} {\operatorname{Área}(A\cup B)}. \]

    El área de intersección debe calcularse a partir de la superposición de los intervalos en \(x\) e \(y\). Si no hay superposición, el área de intersección es cero.

  4. Algoritmo voraz de NMS:

    1. Ordena las cajas por score descendente. En caso de empate, mantén el orden original de lectura.

    2. Selecciona la caja de mayor puntuación entre las cajas restantes y añádela al conjunto de salida.

    3. Calcula la IoU entre la caja seleccionada y todas las cajas aún restantes. Suprime las cajas para las cuales

    \[ \text{IoU} > \tau. \]

    1. Repite los pasos (b) y (c) hasta que no queden cajas.
  5. Salida: Para cada caja mantenida, en el orden en que fue seleccionada, imprimir su índice original (posición de lectura, comenzando en \(0\)) y su score, formateado con 4 decimales. Al final, imprimir:

    Total mantenidas: X

9.10.4.2 📌 Restricciones Computacionales

  • Supresión estricta: solo las cajas con \(\text{IoU} > \tau\) se suprimen. Las cajas con \(\text{IoU} = \tau\) se mantienen.
  • Índices originales: la salida hace referencia a la posición en que cada caja fue leída en la entrada (comenzando en \(0\)), y no a su posición después de la ordenación.
  • Ordenación estable: en caso de score iguales, debe preservarse el orden original de lectura.
  • Rectángulos alineados a los ejes: todas las cajas se especifican mediante dos esquinas, con \(x_1 < x_2\) e \(y_1 < y_2\) garantizados en la entrada.
  • Coordenadas y puntuaciones: los valores reales pueden ser positivos o negativos, según los límites definidos por la entrada, pero las dimensiones de las cajas son siempre positivas.

9.10.4.3 🧠 Fundamentación Teórica

Elemento Papel en el posprocesamiento de detección
IoU Cuantifica la superposición espacial entre dos cajas; \(\text{IoU}=1\) para cajas idénticas y \(\text{IoU}=0\) para cajas sin superposición
Ordenación por confianza Hace que la caja de mayor score se analice primero
Umbral \(\tau\) Define la cantidad de superposición necesaria para que una caja se considere redundante
Supresión Elimina cajas que presentan una gran superposición con una caja ya seleccionada
Cajas distantes Poseen IoU cercana a cero y, en general, no se suprimen por esta regla

9.10.4.4 🧩 Métodos de morph.py que pueden ayudar

  • mm.IoU(boxA, boxB) — calcula la métrica de IoU, pero espera las cajas en el formato \((x,y,w,h)\), es decir, esquina superior izquierda, ancho y alto. La entrada de este ejercicio utiliza el formato \((x_1,y_1,x_2,y_2)\). La conversión es directa:

    \[ w=x_2-x_1,\qquad h=y_2-y_1. \]

    El uso de esta función es opcional. El objetivo principal del ejercicio es implementar correctamente el proceso de selección y supresión de la NMS.

9.10.4.5 📦 Especificación de Entrada y Salida (VPL)

Entrada:

  • Línea 1: entero \(N\) y real \(\tau\).
  • Siguientes \(N\) líneas: \(x_1\ y_1\ x_2\ y_2\ \text{score}\).

Salida:

  • Una línea por caja mantenida, en el orden de selección: índice score.
  • Última línea: Total mantenidas: X.
🎮 Simulador: IoU y Supresión de No Máximos 🟡 NMS
Caja seleccionada Caja mantenida Caja suprimida Caja candidata
5
0.50
Patrón
🎯 Visualización de las Cajas
📋 Paso a Paso de la NMS
Figura 9.46: Simulador EP09_04: IoU y Supresión de No-Máximos (NMS)
%%writefile EP09_04.py
# Código Python
Overwriting EP09_04.py
TestSuite("EP09_04.py").run()
✔️ EP09_04.cases ya existe en casos/
📋 3 caso(s) cargado(s) de casos/EP09_04.cases

🔍 Probando Python: EP09_04.py
⚠️ EP09_04.py: archivo vacío (menos de 3 líneas). Pruebas omitidas.

9.10.5 EP09_05 🟠 Evaluación de Segmentación: IoU y Dice Pixel a Pixel

El Bloque 2 de la sección “Segmentación Semántica con Arquitectura U-Net” define, en pocas líneas, la función iou_mascaras, utilizada para medir la calidad de la línea base morfológica clásica (suavizado + Otsu + apertura) y, más adelante, de la propia U-Net entrenada. A diferencia del IoU del EP09_04 — calculado sobre cajas delimitadoras (regiones rectangulares descritas por cuatro números) —, el IoU de segmentación se calcula pixel a pixel: cada posición de la imagen se compara individualmente entre la máscara predicha y la máscara de referencia.

Se le ha encargado generalizar esta evaluación, implementando no solo el IoU pixel a pixel, sino también el coeficiente de Dice, otra métrica de superposición ampliamente utilizada en segmentación médica (incluso en la función perda_dice, mencionada en el mismo bloque del capítulo como base de la función de pérdida utilizada para entrenar la U-Net).

9.10.5.1 📋 Directrices de Implementación

  1. Entrada: Leer las dimensiones \(H \times W\) de las máscaras.

  2. Máscara predicha: Leer \(H\) líneas con \(W\) valores enteros (0 o 1) cada una — por ejemplo, la salida de una U-Net después de la umbralización en \(0{,}5\) sobre la sigmoide, como en el Bloque 4 del capítulo.

  3. Máscara de referencia: Leer otras \(H\) líneas con \(W\) valores enteros (0 o 1) cada una — el ground truth.

  4. Intersección y unión: Considerando cada píxel como perteneciente al objeto cuando su valor es diferente de cero, \[ \text{intersección} = \sum_{i,j} \mathbb{1}[P_{ij}=1 \wedge R_{ij}=1], \qquad \text{unión} = \sum_{i,j} \mathbb{1}[P_{ij}=1 \vee R_{ij}=1]. \]

  5. IoU pixel a pixel: \[ \text{IoU} = \frac{\text{intersección}}{\text{unión}}. \]

  6. Coeficiente de Dice: \[ \text{Dice} = \frac{2 \cdot \text{intersección}}{|P| + |R|}, \] donde \(|P|\) y \(|R|\) son el número total de píxeles de objeto en cada máscara.

  7. Convención para máscaras vacías: si ambas máscaras no poseen ningún píxel de objeto (unión \(= 0\) y \(|P|+|R|=0\)), considere la correspondencia trivialmente perfecta: \(\text{IoU} = \text{Dice} = 1{,}0\).

  8. Salida: Dos líneas, IoU: X.XXXX y Dice: X.XXXX, cada valor con 4 decimales.

9.10.5.2 📌 Restricciones Computacionales

  • Cualquier valor no nulo cuenta como objeto: trate valores diferentes de \(0\) (no solo \(1\)) como pertenecientes a la máscara, replicando la comprobación predita > 0 utilizada en iou_mascaras en el capítulo.
  • Mismas dimensiones: las dos máscaras siempre poseen exactamente \(H \times W\) elementos.
  • Convención de vacío: aplique la regla del ítem 7 solo cuando ambas máscaras estén totalmente vacías; si solo una está vacía, la intersección es \(0\) y el IoU/Dice resultante también será \(0\).

9.10.5.3 🧠 Fundamentación Teórica

Elemento Papel en la evaluación de segmentación
IoU pixel a pixel Generaliza la métrica del EP09_04 para regiones de forma arbitraria — no solo rectángulos — comparando máscara predicha y referencia posición a posición
Coeficiente de Dice Métrica relacionada con el IoU (siempre \(\text{Dice} \ge \text{IoU}\)), más sensible a pequeñas intersecciones y ampliamente utilizada como función de pérdida en segmentación (función perda_dice del capítulo)
Convención de máscaras vacías Evita la división por cero y reconoce que “ningún objeto previsto, ningún objeto real” es, por definición, un acierto
Comparación clásico vs. U-Net El capítulo usa exactamente este tipo de métrica para justificar, numéricamente, por qué la U-Net supera la línea base morfológica en escenarios de bajo contraste

9.10.5.4 🧩 Métodos del morph.py que pueden ayudar

  • mm.readImg(h, w, dtype='uint8') — lee directamente cada máscara binaria \(h \times w\) de la entrada estándar (los valores \(0/1\) caben perfectamente en el tipo entero estándar).
  • La propia función iou_mascaras, definida en el Bloque 2 de la sección de U-Net del capítulo (no forma parte del morph.py, sino del código del capítulo), es la inspiración directa de este ejercicio — vale la pena releer esas pocas líneas antes de programar.
  • Para una extensión opcional (no exigida por este EP), mm.connectedComponents o mm.label0 (vistos en el contexto de análisis de componentes conexos) permitirían etiquetar cada nódulo individualmente y calcular el IoU por componente, en lugar de sobre la máscara completa.

9.10.5.5 📦 Especificación de Entrada y Salida (VPL)

Entrada:

  • Línea 1: Enteros \(H\) y \(W\).
  • Siguientes \(H\) líneas: \(W\) valores enteros (0 o 1) — máscara predicha.
  • Siguientes \(H\) líneas: \(W\) valores enteros (0 o 1) — máscara de referencia.

Salida:

  • Línea 1: IoU: X.XXXX.
  • Línea 2: Dice: X.XXXX.
Tip💡 Ejemplo Ilustrativo

Considere una máscara predicha con un cuadrado \(2\times2\) de píxeles activos y una referencia desplazada en una columna, superponiéndose en solo la mitad del área:

Predicha         Referencia
0 0 0 0         0 0 0 0
0 1 1 0         0 0 1 1
0 1 1 0         0 0 1 1
0 0 0 0         0 0 0 0

Intersección \(=2\) píxeles, unión \(=6\) píxeles (\(4+4-2\)), por lo tanto \(\text{IoU}=2/6\approx0{,}3333\) y \(\text{Dice}=2\cdot2/(4+4)=0{,}5000\) — observe que el Dice es siempre igual o mayor que el IoU para la misma superposición.

9.10.5.6 📌 Ejemplos

Entrada Salida Observación
4 4
0 0 0 0
0 1 1 0
0 1 1 0
0 0 0 0
0 0 0 0
0 0 1 1
0 0 1 1
0 0 0 0
IoU: 0.3333
Dice: 0.5000
Máscaras \(4\times4\) con superposición parcial de 2 píxeles.
🎮 Simulador: IoU y Dice Píxel a Píxel 🟠 Segmentación
Intersección (TP) Solo predicha (FP) Solo referencia (FN) Fondo (TN)
5×5
Cuadrado
🔵 Máscara Predicha
🟡 Máscara de Referencia
🎯 Comparación Visual
📊 Cálculos y Fórmulas
Figura 9.47: Simulador EP09_05: Evaluación de Segmentación — IoU y Dice Píxel a Píxel
%%writefile EP09_05.py
# Código Python en español
Overwriting EP09_05.py
TestSuite("EP09_05.py").run()
✔️ EP09_05.cases ya existe en casos/
📋 4 caso(s) cargado(s) de casos/EP09_05.cases

🔍 Probando Python: EP09_05.py
⚠️ EP09_05.py: archivo vacío (menos de 3 líneas). Pruebas omitidas.

9.10.6 EP09_06 🔴 Pipeline Integrado: De la Detección a la Medición del Mundo Real

Este ejercicio final integra los dos ejercicios de detección y el principio de fotogrametría presentado en la sección “Fotogrametría y Referencia de Escala” — exactamente el mismo cálculo implementado en la figura de medición por referencia de escala de este capítulo. El escenario reproduce una situación realista: un detector (Faster R-CNN o YOLO) genera varias cajas candidatas superpuestas para el mismo objeto de interés; tras filtrarlas por NMS, la caja superviviente de mayor confianza se usa, junto con una caja de referencia de ancho real conocido (como la tarjeta de \(8{,}56\) cm), para estimar las dimensiones reales del objeto detectado.

9.10.6.1 📋 Directrices de Implementación

  1. Referencia conocida: Leer el valor real \(L_{ref}\) (ancho real del objeto de referencia, en cm) y, a continuación, los cuatro reales \(x_1\ y_1\ x_2\ y_2\) de su caja delimitadora en píxeles (ya conocida, sin necesidad de detección).
  2. Candidatas del objeto a medir: Leer el entero \(N\) (número de cajas candidatas producidas por el detector para el objeto de interés) y el umbral real \(\tau\); a continuación, leer las \(N\) líneas de cajas candidatas, cada una con \(x_1\ y_1\ x_2\ y_2\ \text{score}\).
  3. Etapa 1 — NMS: Aplicar exactamente el algoritmo de Supresión de No Máximos del EP09_04 a las \(N\) cajas candidatas, usando el umbral \(\tau\), para eliminar detecciones redundantes del mismo objeto.
  4. Etapa 2 — Selección de la caja final: Tras el NMS, la caja de mayor score entre las mantenidas es la detección final del objeto (la entrada garantiza que todas las cajas candidatas corresponden a un único objeto físico, por lo que la primera caja seleccionada por el NMS ya es el resultado final).
  5. Etapa 3 — Medición por referencia de escala: Calcular la razón \(\text{cm/pixel} = L_{ref} / \text{ancho de la referencia en píxeles}\) y aplicarla tanto al ancho como a la altura (en píxeles) de la caja final del objeto, obteniendo sus dimensiones reales estimadas en centímetros.
  6. Salida: Primero, una línea por caja mantenida tras el NMS (mismo formato del EP09_04): índice score. A continuación, la línea Total mantenidas: X. Finalmente, la línea Objeto: L x A cm, donde \(L\) y \(A\) son el ancho y la altura estimados del objeto, cada uno con 2 decimales.

9.10.6.2 📌 Restricciones Computacionales

  • Reutilizar el NMS del EP09_04 íntegramente — misma regla de desempate, mismo criterio de supresión (\(\text{IoU} > \tau\)).
  • La referencia no pasa por NMS: su caja se da directamente, sin candidatas competidoras.
  • Razón única para ancho y altura: así como en la figura de fotogrametría del capítulo, la misma razón cm/pixel (derivada del ancho de la referencia) se aplica tanto al ancho como a la altura del objeto — no hay calibración vertical separada.

9.10.6.3 🧠 Fundamentación Teórica

Etapa Concepto del capítulo
Múltiples cajas candidatas Salida bruta de un detector como el Faster R-CNN o el YOLO, antes del posprocesamiento
NMS (EP09_04) Filtra las detecciones redundantes, preservando solo la más confiable para el objeto
Referencia de escala conocida Mismo principio de la tarjeta de \(8{,}56\) cm usado en la sección “Fotogrametría y Referencia de Escala”
Conversión píxel → centímetro Regla de tres simple: \(\text{cm/pixel} = L_{ref} / w_{ref\_px}\), aplicada a la caja final del objeto

9.10.6.4 🧩 Métodos del morph.py que pueden ayudar

  • mm.IoU(boxA, boxB) — la misma función sugerida en el EP09_04, aquí reutilizada dentro de la etapa de NMS de este pipeline integrado (recuerde la conversión de formato: \(w = x_2-x_1\), \(h = y_2-y_1\)).
  • Si ya resolvió el EP09_04 encapsulando el NMS en una función propia, este es el momento ideal de reutilizar ese código — la integración de módulos ya probados individualmente es exactamente la práctica de ingeniería que este ejercicio quiere reforzar.

9.10.6.5 📦 Especificación de Entrada y Salida (VPL)

Entrada:

  • Línea 1: Real \(L_{ref}\).
  • Línea 2: \(x_1\ y_1\ x_2\ y_2\) de la caja de referencia.
  • Línea 3: Entero \(N\) y real \(\tau\).
  • Siguientes \(N\) líneas: \(x_1\ y_1\ x_2\ y_2\ \text{score}\) de las cajas candidatas del objeto.

Salida:

  • Una línea por caja mantenida tras el NMS: índice score.
  • Línea siguiente: Total mantenidas: X.
  • Última línea: Objeto: L x A cm.

9.10.6.6 📌 Ejemplos

Entrada Salida Observación
8.56
30 200 170 288
3 0.5
250 100 470 250 0.92
255 105 468 245 0.88
600 600 650 650 0.40
0 0.9200
2 0.4000
Total mantenidas: 2
Objeto: 13.45 x 9.17 cm
La caja 1 se suprime por superponerse fuertemente a la caja 0; la detección final del objeto es la caja 0.
🎮 Simulador: Pipeline Integrado — Detección a Medición 🔴 Fotogrametría
Caja seleccionada Caja suprimida Referencia Objeto final
8.56
0.50
Estándar
🎯 Visualización del Pipeline
📋 Pipeline Paso a Paso
Figura 9.48: Simulador EP09_06: Pipeline Integrado — Detección a la Medición del Mundo Real
%%writefile EP09_06.py
# Código Python
Overwriting EP09_06.py
TestSuite("EP09_06.py").run()
✔️ EP09_06.cases ya existe en casos/
📋 3 caso(s) cargado(s) de casos/EP09_06.cases

🔍 Probando Python: EP09_06.py
⚠️ EP09_06.py: archivo vacío (menos de 3 líneas). Pruebas omitidas.