9  Apprendimento Profondo per la Visione Artificiale

I capitoli precedenti hanno stabilito le fondamenta della Visione Artificiale (VA) attraverso metodi classici di estrazione e rappresentazione delle caratteristiche. Nel Capitolo 7, descrittori come Local Binary Patterns (LBP) e Histogram of Oriented Gradients (HOG) hanno mostrato come trame e forme possano essere codificate da descrittori progettati manualmente. Nel Capitolo 8, algoritmi come Oriented FAST and Rotated BRIEF (ORB) e il rivelatore Haar Cascade hanno esteso questo principio a compiti di corrispondenza, rilevamento e riconoscimento di oggetti.

Queste tecniche rimangono rilevanti per la loro interpretabilità ed efficienza computazionale, ma dipendono da una fase preliminare di definizione manuale dei descrittori, denominata ingegneria delle caratteristiche (feature engineering). Questa dipendenza limita l’adattamento del modello a scenari per i quali il descrittore non è stato progettato.

L’Apprendimento Profondo (Deep Learning) propone un’alternativa: invece di specificare manualmente le caratteristiche rilevanti, il modello apprende automaticamente rappresentazioni dai dati durante l’addestramento — processo noto come apprendimento di rappresentazioni (representation learning) (GOODFELLOW, 2016). Nella VA, questa strategia è implementata principalmente dalle Reti Neurali Convoluzionali (Convolutional Neural Networks — CNN), nelle quali i filtri convoluzionali cessano di avere coefficienti fissi e vengono regolati da algoritmi di ottimizzazione.

Sebbene rappresentino un cambiamento nella costruzione di sistemi di riconoscimento di pattern, le CNN preservano concetti già studiati in questo libro: la convoluzione, presentata nel Capitolo 3, rimane l’operazione responsabile dell’estrazione locale delle caratteristiche, ora applicata con coefficienti appresi anziché progettati.

Va sottolineato che l’obiettivo di questo capitolo non è esplorare esaustivamente la teoria dell’Apprendimento Profondo, ma piuttosto offrire una panoramica dei suoi fondamenti e dimostrare come queste architetture vengano applicate nel contesto della VA. I lettori interessati a un approfondimento teorico e concettuale nell’area dovrebbero ricorrere a riferimenti specialistici della letteratura, come Goodfellow (2016) e Lecun (2015).

9.1 Obiettivi del Capitolo

Al termine di questo capitolo, lo studente dovrebbe essere in grado di:

  • Collegare la convoluzione appresa dalle CNN con la convoluzione di kernel fissi presentata nel Capitolo 3;
  • Descrivere l’architettura di base di una CNN e la funzione dei suoi strati principali;
  • Implementare, addestrare e valutare modelli CNN per la classificazione delle immagini;
  • Applicare il transfer learning (transfer learning) per adattare modelli pre-addestrati a nuovi problemi;
  • Utilizzare modelli pre-addestrati in compiti di classificazione, rilevamento di oggetti e segmentazione;
  • Implementare, addestrare e valutare un’architettura U-Net per la segmentazione semantica, confrontandola con approcci classici;
  • Preparare set di dati annotati e integrarli in un pipeline di addestramento tramite piattaforme come Roboflow;
  • Integrare geometria computazionale e Deep Learning in applicazioni di realtà aumentata e fotogrammetria.

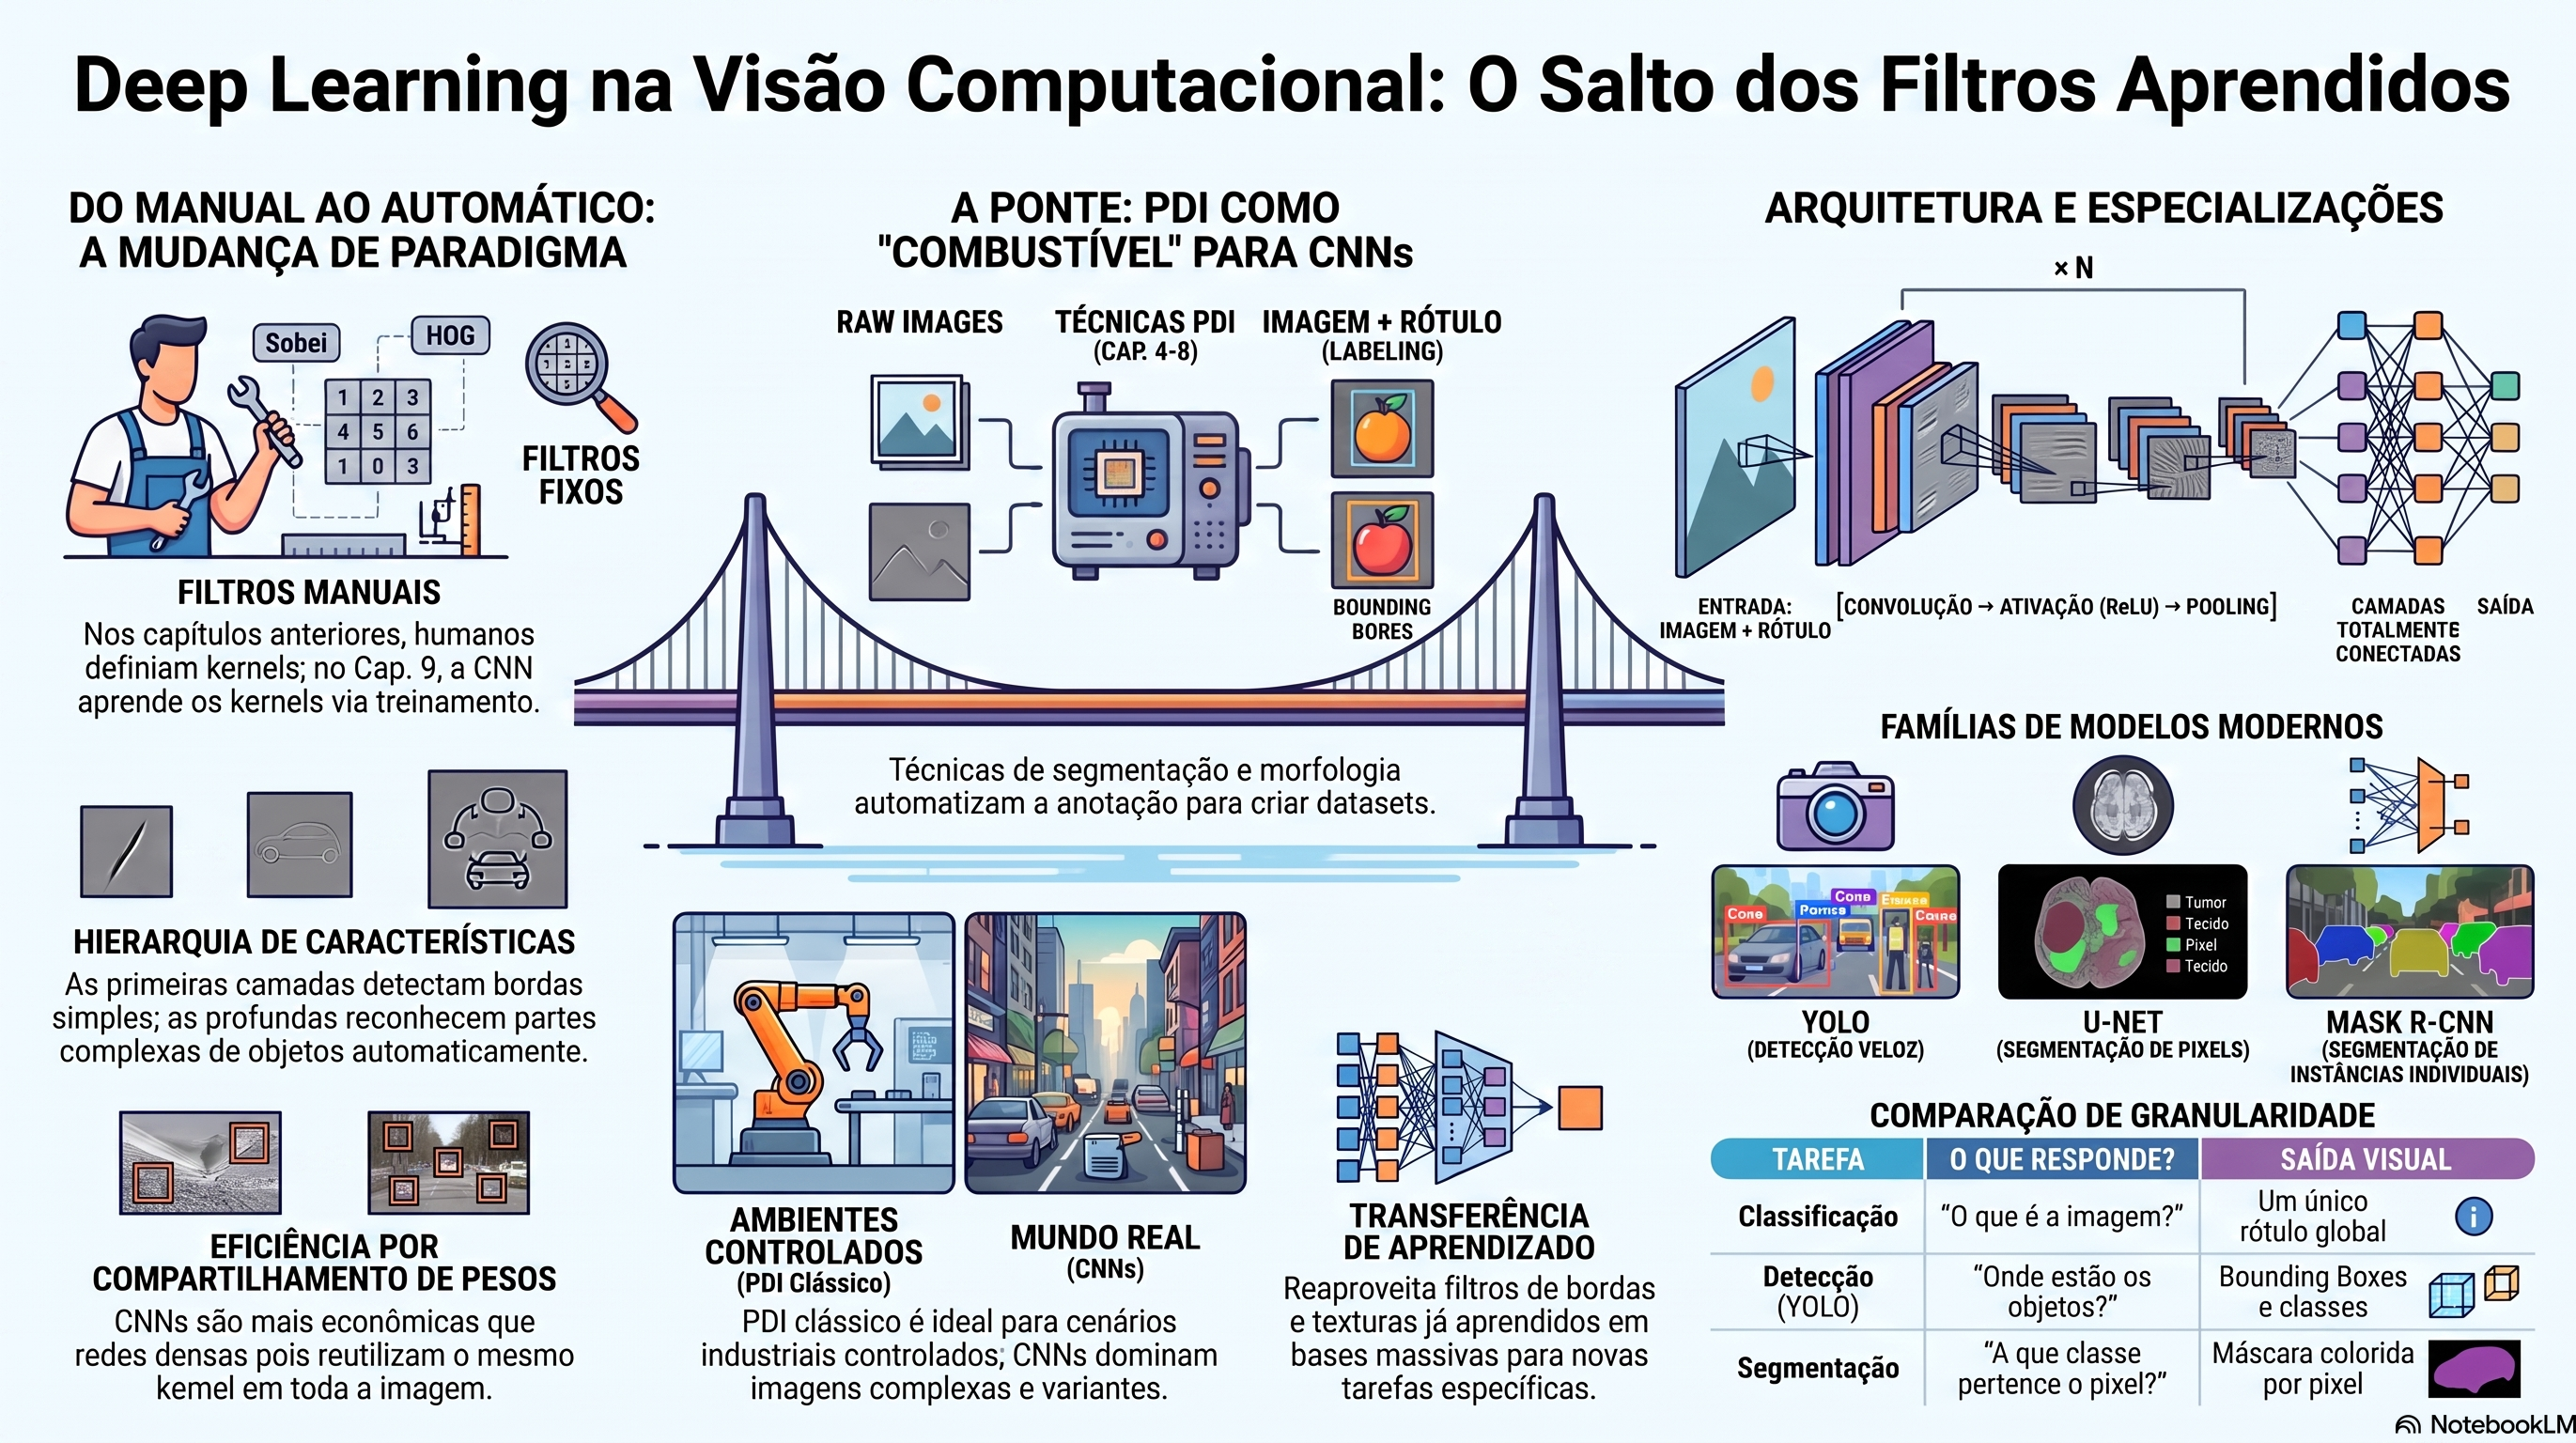
La Figura 9.1 sintetizza l’organizzazione dei concetti studiati in questo capitolo e le relazioni tra essi.

Figura 9.1: Panoramica dei principali concetti trattati in questo capitolo. Fonte: elaborato con l’ausilio di Gemini Notebook ({GOOGLE}, 2025).

9.2 Panoramica: Classificazione, Rilevamento e Segmentazione

I compiti di VC si differenziano, soprattutto, per l’informazione prodotta come output. La classificazione assegna un’unica etichetta all’intera immagine; il rilevamento di oggetti localizza e identifica gli oggetti presenti nella scena; la segmentazione associa una classe a ogni pixel e, in alcuni approcci, distingue differenti istanze di una stessa categoria.

La Tabella 9.1 riassume i compiti studiati lungo il libro, indicando la domanda a cui ciascuno risponde e la granularità dell’informazione prodotta.

Tabella 9.1: Confronto tra i principali compiti di VC secondo la granularità dell’informazione prodotta.
Compito Domanda a cui risponde Granularità dell’output Capitolo
Classificazione “Qual è la classe di questa immagine?” Un’unica etichetta per l’intera immagine 7 e 9
Rilevamento di oggetti “Quali oggetti esistono e dove si trovano?” Classe e bounding box per ogni oggetto 8 e 9
Segmentazione semantica “A quale classe appartiene ogni pixel?” Un’etichetta di classe per ogni pixel 8 e 9
Segmentazione delle istanze “Quali pixel appartengono a ogni oggetto?” Un’etichetta per pixel per ogni istanza 8 e 9
Segmentazione panottica “Qual è la classe e l’identità di ogni oggetto?” Classe e identificatore di istanza per ogni pixel 8 e 9

Questi compiti rappresentano livelli crescenti di interpretazione dell’immagine: la classificazione descrive la scena in modo globale, il rilevamento aggiunge la localizzazione degli oggetti e la segmentazione produce una rappresentazione spaziale dettagliata, consentendo di analizzare ciascuna regione individualmente. Questo capitolo si concentra, in primo luogo, sulla classificazione tramite CNN, per poi estendere gli stessi principi al rilevamento e alla segmentazione.

9.3 Configurazione dell’Ambiente

Gli esempi di questo capitolo utilizzano PyTorch, un framework ampiamente impiegato nello sviluppo e nell’addestramento di modelli di Deep Learning. Il codice seguente verifica la disponibilità delle librerie necessarie e installa automaticamente quelle non ancora presenti nell’ambiente di esecuzione.

Se PyTorch non è installato, viene selezionata automaticamente una versione compatibile con l’hardware disponibile: la versione con supporto CUDA, se è disponibile una GPU NVIDIA, oppure la versione per l’esecuzione su CPU, in caso contrario.

Successivamente, l’ambiente viene inizializzato con l’importazione delle librerie utilizzate nel corso del capitolo, la definizione di un seed casuale per favorire la riproducibilità degli esperimenti e il recupero del file morph.py — la libreria didattica di elaborazione morfologica già utilizzata nei capitoli precedenti —, qualora non sia ancora disponibile nella directory di lavoro.

import contextlib, importlib, importlib.metadata, importlib.util
import io, os, random, shutil, subprocess, sys, urllib.request, warnings

# Sopprime gli avvisi di PyTorch e i warning generali
warnings.filterwarnings("ignore", category=UserWarning)

url = ("https://raw.githubusercontent.com/fzampirolli/"
       "pdi-vc/master/morph/config.py")
if not os.path.exists("config.py"):
    urllib.request.urlretrieve(url, "config.py")

import config

# Silenzia stdout e stderr sia a livello di Python che di File Descriptors del SO
def setup_silencioso():
    with open(os.devnull, "w") as fnull:
        old_out = os.dup(1)
        old_err = os.dup(2)
        try:
            os.dup2(fnull.fileno(), 1)
            os.dup2(fnull.fileno(), 2)
            with contextlib.redirect_stdout(fnull), contextlib.redirect_stderr(fnull):
                config.setup()
        finally:
            os.dup2(old_out, 1)
            os.dup2(old_err, 2)
            os.close(old_out)
            os.close(old_err)

setup_silencioso()
from morph import mm


def setup_cap09():
    """Installa le librerie mancanti per questo capitolo in modo 100% silenzioso."""
    pkgs = {
        "skimage": "scikit-image", "numpy": "numpy",
        "sklearn": "scikit-learn", "matplotlib": "matplotlib",
        "torchviz": "torchviz", "ultralytics": "ultralytics",
        "roboflow": "roboflow",
    }
    for mod, pkg in pkgs.items():
        if importlib.util.find_spec(mod) is None:
            subprocess.run([sys.executable, "-m", "pip", "install", "-q", pkg],
                           stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

    if importlib.util.find_spec("torch") is None:
        args = (["torch", "torchvision"] if shutil.which("nvidia-smi")
                 else ["--index-url",
                       "https://download.pytorch.org/whl/cpu",
                       "torch", "torchvision"])
        subprocess.run([sys.executable, "-m", "pip", "install", "-q", *args],
                       stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

    if not shutil.which("dot") and shutil.which("apt-get"):
        subprocess.run(["apt-get", "install", "-y", "-qq", "graphviz"],
                       stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL, check=False)


setup_cap09()

import cv2, numpy as np, torch
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import torchvision.models as models
import torchvision.transforms as T
from PIL import Image
from skimage import data as skdata
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from torch.utils.data import DataLoader, TensorDataset
from torchvision.datasets import OxfordIIITPet
from torchvision.models.detection import (
    fasterrcnn_resnet50_fpn, FasterRCNN_ResNet50_FPN_Weights)
from torchvision.models.segmentation import deeplabv3_resnet50
from torchvision.transforms.functional import to_tensor
from torchviz import make_dot
from ultralytics import YOLO

torch.manual_seed(42)
FLAG_LIMPAR_DADOS = False
device = "cuda" if torch.cuda.is_available() else "cpu"
gpu = f" ({torch.cuda.get_device_name(0)})" if device == "cuda" else ""
ver = importlib.metadata.version("ultralytics")
print(f"✅ Ambiente pronto. OpenCV {cv2.__version__} | "
      f"morph {getattr(mm, '__version__', 'local_file')} | "
      f"PyTorch {torch.__version__} | Ultralytics {ver} | {device}{gpu}")
✅ Ambiente pronto. OpenCV 5.0.0 | morph local_file | PyTorch 2.6.0+cu124 | Ultralytics 8.4.113 | cuda (NVIDIA GeForce GTX TITAN X)

9.4 Fondamenti di Deep Learning per la VC

Le CNN sono la principale architettura di Deep Learning applicata all’analisi delle immagini. Il loro funzionamento si basa sulla composizione di operazioni convoluzionali organizzate in strati successivi, in cui i filtri appresi durante l’addestramento trasformano l’immagine in rappresentazioni progressivamente più astratte. In questa sezione vengono presentati i concetti fondamentali che collegano la convoluzione spaziale studiata in precedenza ai moderni modelli di VC, inclusa l’estrazione gerarchica delle caratteristiche, il processo di addestramento e l’utilizzo di modelli pre-addestrati.

9.4.1 Dalla Convoluzione Fissa alla Convoluzione Appresa

Il Capitolo 3 ha presentato la convoluzione spaziale con kernel fissi, come gli operatori di Sobel, progettati per evidenziare caratteristiche specifiche di un’immagine. Nei Capitoli 7 e 8, lo stesso principio ha sostenuto descrittori come HOG, LBP e ORB, oltre al rilevatore Haar Cascade: in tutti questi casi, i filtri sono definiti prima dell’esecuzione dell’algoritmo e rimangono invariati durante l’elaborazione.

La Figura 9.2 riprende il funzionamento della convoluzione spaziale: il simulatore consente di selezionare diversi kernel e di seguire lo spostamento della finestra di convoluzione su un’immagine. In ogni posizione, i coefficienti del kernel si combinano con l’intorno locale dell’immagine — denominato campo recettivo (receptive field) — per produrre un valore della mappa delle caratteristiche (feature map), illustrando anche la condivisione dei pesi (weight sharing).

Le CNN preservano questa operazione, ma sostituiscono i kernel fissi con filtri appresi: invece di coefficienti definiti in precedenza, la rete aggiusta questi valori durante l’addestramento a partire da esempi etichettati, cercando di minimizzare una funzione di perdita (loss function), che misura la differenza tra le previsioni del modello e le risposte attese.

La differenza essenziale tra i metodi classici e le CNN, quindi, non sta nell’operazione di convoluzione in sé, ma nel modo in cui i filtri vengono ottenuti: mentre i primi utilizzano filtri progettati manualmente, le CNN apprendono, a partire dai dati di addestramento, rappresentazioni adeguate al compito.

🎯 Simulatore: Operazione di Convoluzione 2D Classica Input 12×12 · Kernel 3×3 · Stride 1
IMMAGINE DI INPUT (12×12)
FILTRO (KERNEL 3×3)
Posizione Attuale: (0, 0) [Output 10×10]
Input (12×12)
Kernel (3×3)
Mappa di Output (10×10)
∑ (xᵢ × wᵢ) = calcolo della posizione attuale...
Figura 9.2: Simulatore interattivo di convoluzione 2D classica: scegli tra le tre immagini sintetiche di input 12×12 (casa, faccia felice o triste) e un filtro 3×3 (Sobel V, Sobel H, Nitidezza o Identità) e procedi passo dopo passo per osservare come i prodotti interni locali del campo recettivo costruiscono la mappa delle caratteristiche cella per cella.

Per comprendere come avviene questo apprendimento, è necessario studiare l’unità di base dell’elaborazione delle reti neurali: il neurone artificiale.

9.4.2 Neurone Artificiale

Il neurone artificiale (artificial neuron) è l’unità fondamentale di elaborazione di una rete neurale. Il suo primo modello matematico — un insieme di ingressi combinati e confrontati con una soglia — fu proposto da Mcculloch (1943), ancora privo di qualsiasi meccanismo di apprendimento. Il Percettrone (ROSENBLATT, 1958) fece avanzare questa formulazione introducendo una regola di aggiustamento dei pesi basata su esempi, diventando il primo modello di neurone artificiale capace di apprendere e la base delle architetture moderne di Apprendimento Profondo (Deep Learning). Il termine Apprendimento Profondo si riferisce all’uso di reti con più strati di elaborazione, in grado di apprendere rappresentazioni gerarchiche dei dati: i primi strati apprendono caratteristiche semplici, come bordi e trame, e gli strati più profondi combinano progressivamente queste rappresentazioni per identificare strutture e oggetti più complessi.

Ogni neurone riceve un insieme di ingressi, calcola una combinazione lineare di tali valori e applica una funzione di attivazione (activation function), producendo un unico valore di uscita. Matematicamente, la combinazione lineare è data da

\[ z=\sum_{i=1}^{n}w_i x_i+b, \]

dove \(x_i\) rappresentano gli ingressi, \(w_i\) i pesi associati a ciascun ingresso e \(b\) il bias (bias). L’uscita del neurone si ottiene applicando la funzione di attivazione:

\[ y=f(z). \]

Nelle CNN, questo principio assume forme diverse a seconda dello strato. Negli strati convoluzionali (convolutional layers), ogni neurone elabora solo una piccola regione dell’ingresso, denominata campo recettivo (receptive field), preservando l’organizzazione spaziale dell’immagine. Negli strati completamente connessi (fully connected layers), ogni neurone riceve tutte le uscite dello strato precedente, combinando le caratteristiche estratte per produrre l’uscita finale della rete, come la classe attribuita all’immagine.

La Figura 9.3 illustra il funzionamento di un neurone artificiale: il simulatore consente di modificare gli ingressi (\(x_1\) e \(x_2\)), i pesi (\(w_1\) e \(w_2\)), il bias (\(b\)) e la funzione di attivazione, osservando in tempo reale il calcolo della combinazione lineare e dell’uscita corrispondente.

⚙️ Simulatore: Neurone Artificiale in una CNN y = f(∑ wᵢxᵢ + b)
x₁ w₁
x₂ w₂
b
I valori di x variano da -3 a 3 perché, in una CNN, i pixel (0–255) vengono normalizzati prima di entrare nella rete. Il disegno accanto traduce questo valore normalizzato di nuovo in una tonalità di grigio, solo per dare un'intuizione visiva — i numeri che contano per il calcolo sono quelli delle barre.
Campo Recettivo → Convoluzione → Mappa delle Caratteristiche
Attivazione in f(z)
x₁, x₂ = intensità dei pixel nel campo recettivo · w₁, w₂ = pesi del kernel (filtro) · z = risultato della convoluzione in questa posizione · y = valore del pixel prodotto nella mappa delle caratteristiche, dopo l'attivazione.
z = (1.00 × 0.80) + (-1.50 × 0.50) + 0.20 = 0.25 → y = 0.25
Figura 9.3: Simulatore interattivo del neurone artificiale in un contesto di CNN: passa da un neurone di un livello convoluzionale (dove x_i sono intensità di pixel in un campo ricettivo e w_i sono pesi del kernel) a un neurone di un livello completamente connesso, regolando input, pesi, bias e funzione di attivazione per visualizzare il calcolo di z e dell’output y in tempo reale.

In una CNN, migliaia di neuroni si organizzano in strati con funzioni specifiche: i primi sono responsabili dell’estrazione delle caratteristiche tramite la convoluzione, mentre gli ultimi eseguono la classificazione a partire dalle caratteristiche apprese.

9.4.3 Livello Convoluzionale

Il livello convoluzionale (convolutional layer) è responsabile dell’estrazione delle caratteristiche dell’immagine. Ogni filtro genera una mappa delle caratteristiche (feature map), la cui intensità in ciascuna posizione indica la risposta del filtro alla regione corrispondente dell’input.

L’operazione eseguita segue lo stesso principio di scorrimento e combinazione locale presentato nel Capitolo 3 per la convoluzione spaziale. Considerando un kernel \(K\) di dimensione \(k \times k\), il valore prodotto nella posizione \((i,j)\) è dato da

\[ F(i,j)=\sum_{u=0}^{k-1}\sum_{v=0}^{k-1}K(u,v)\,I(i+u,j+v). \]

Vale la pena registrare una distinzione terminologica: l’espressione sopra corrisponde, formalmente, a una correlazione incrociata (cross-correlation), e non alla convoluzione matematica rigorosa, che richiede la riflessione del kernel prima della combinazione. La maggior parte dei framework di Deep Learning, incluso PyTorch, implementa questa operazione senza riflessione e la designa, per convenzione, come convoluzione — convenzione adottata anche in questo capitolo. Questa differenza non ha alcun effetto pratico sull’allenamento, poiché i coefficienti del kernel vengono appresi e non imposti in anticipo.

La differenza principale rispetto ai metodi classici risiede quindi nell’ottenimento del kernel \(K\): nei filtri tradizionali, i suoi coefficienti sono definiti manualmente per evidenziare caratteristiche specifiche dell’immagine; nelle CNN, i coefficienti vengono inizializzati automaticamente e regolati durante l’allenamento tramite la retropropagazione dell’errore (backpropagation), rendendo ogni filtro specializzato nell’identificare pattern rilevanti per il compito in esame.

Due concetti caratterizzano questo livello:

  • Condivisione dei pesi (weight sharing): lo stesso filtro viene applicato in tutte le posizioni dell’immagine, riducendo significativamente il numero di parametri del modello.
  • Campo recettivo (receptive field): ogni neurone convoluzionale processa solo un piccolo intorno dell’immagine, preservando la struttura spaziale dei dati.

Impilando più livelli convoluzionali, la rete apprende una gerarchia di caratteristiche: i primi livelli tendono a rilevare pattern semplici, come bordi e trame, e i livelli più profondi combinano queste informazioni per rappresentare strutture progressivamente più complesse. Dopo la convoluzione, la mappa delle caratteristiche viene sottoposta a una funzione di attivazione, introducendo non linearità nel modello e ampliando la sua capacità di rappresentare relazioni complesse tra le variabili di input.

La Figura 9.4 presenta questo livello in modo interattivo.

⚙️ Simulador: Operação de Convolução & Mapa de Características F(i,j) = f(∑ K(u,v) · I(i+u, j+v))
IMAGEM DE ENTRADA
KERNEL (FILTRO FIXO)
Zero-Padding (p = 1)
pixel real margem fixa da imagem (0) padding do algoritmo (0)
O mesmo kernel desliza sobre toda a imagem reutilizando seus coeficientes (compartilhamento de pesos). Cada imagem já vem cercada por uma margem fixa de 1 pixel de fundo (zeros, contorno tracejado âmbar), isolando a forma nos quatro lados. Escolha uma imagem e um kernel fixo acima, depois use ◀ ▶ ou "Auto" para percorrer o campo receptivo — o Feature Map à direita é preenchido célula a célula, na mesma ordem em que a convolução é calculada (as células ainda não visitadas aparecem como "···").
📌 A saída F(i,j) vem do campo receptivo entre (i,j) e (i+2,j+2); seu centro real é (i+1,j+1) — 1 linha e 1 coluna abaixo/à direita do índice usado para rotular a célula, sempre nas duas direções. Esse deslocamento só fica visível no eixo em que o kernel diferencia a imagem (por isso o Sobel V parece deslocar só para o lado, e o Sobel H, só para baixo).
Ativação em f(z)
🔍 Cálculo Detalhado no Campo Receptivo Atual
z = 0.00 → y = ReLU(z) = 0.00
Figura 9.4: Simulador interativo da Camada Convolucional: escolha entre três imagens de entrada 12×12 (casa, rosto feliz ou rosto triste) para observar como os mesmos kernels fixos reagem a diferentes bordas e formas. Navegue pelo campo receptivo com os botões ou reprodução automática, ajuste a função de ativação e alterne o zero-padding, acompanhando o mapa de características sendo revelado célula a célula, com o cálculo detalhado termo a termo e a fórmula da dimensão de saída em tempo real.

9.4.4 Funzione di Attivazione

La convoluzione è un’operazione lineare. Affinché la rete possa modellare relazioni non lineari tra ingressi e uscite, si applica una funzione di attivazione (activation function) dopo ogni strato convoluzionale.

La funzione più utilizzata nelle CNN è la ReLU (Rectified Linear Unit), definita da

\[ \mathrm{ReLU}(x)=\max(0,x). \]

Questa funzione preserva i valori positivi e sostituisce con zero i valori negativi, introducendo non linearità nel modello e favorendo l’addestramento di reti profonde con basso costo computazionale.

La Figura 9.5 illustra il funzionamento della ReLU applicata sia a valori individuali sia a una mappa delle caratteristiche, consentendo di confrontare l’uscita prima e dopo l’attivazione.

⚡ Simulatore: Funzione di Attivazione ReLU ReLU(x) = max(0, x)
x = x = -2.50 → ReLU(x) = 0.00
Curva della funzione ReLU
Mappa delle caratteristiche: prima / dopo
Figura 9.5: Simulatore interattivo della funzione di attivazione ReLU: trascina il controllo per vedere come i valori negativi vengono azzerati e i valori positivi vengono preservati, sia nella curva che in una mappa delle caratteristiche reale.

I mappe di caratteristiche risultanti dalla convoluzione e dall’attivazione preservano la struttura spaziale dell’immagine. In molte architetture, la fase successiva ne riduce la risoluzione tramite un’operazione di pooling.

9.4.5 Pooling

Il livello di pooling riduce la risoluzione spaziale delle mappe delle caratteristiche, preservando le informazioni più rilevanti per le fasi successive dell’elaborazione. L’operazione più utilizzata è il max-pooling, che seleziona il valore massimo in ogni finestra dell’immagine:

\[ P(i,j)=\max_{(u,v)\in\text{finestra}(i,j)}F(u,v). \]

Questa riduzione diminuisce il costo computazionale dei livelli successivi e rende la rappresentazione più robusta a piccole variazioni nella posizione dei pattern presenti nell’immagine.

La Figura 9.6 presenta questa operazione su una mappa delle caratteristiche di 8×8 pixel, ridotta a 4×4 tramite finestre di 2×2 con passo pari a 2, alternando tra max-pooling e average-pooling — che calcola, invece del massimo, la media dei valori della finestra corrispondente.

🔻 Simulatore: Pooling finestra 2×2, stride 2
Tipo:
Finestra attuale: (0, 0) di 4×4
O max-pooling mantiene solo il valore più alto di ciascuna finestra 2×2, riducendo la risoluzione spaziale della metà e preservando le risposte più forti della mappa delle caratteristiche.
Mappa di ingresso (8×8) — finestra attuale evidenziata
Mappa ridotta (4×4)
Figura 9.6: Simulatore interattivo di pooling: scegli tra max-pooling e average-pooling e procedi passo dopo passo per osservare la riduzione della risoluzione spaziale della mappa delle caratteristiche.

Complessivamente, convoluzione, funzione di attivazione e pooling formano il blocco fondamentale utilizzato nella costruzione di una CNN.

9.4.6 Addestramento delle Reti Neurali: Come le CNN Imparano

Una CNN impara regolando automaticamente i propri parametri — i coefficienti dei filtri convoluzionali, i pesi dei livelli completamente connessi e i bias — a partire da esempi etichettati. Questo addestramento è iterativo e coinvolge tre fasi: misurare l’errore prodotto dalla rete tramite una funzione di perdita (loss function), calcolare come tale errore dipende da ciascun parametro tramite la retropropagazione (backpropagation) e aggiornare i parametri con un algoritmo di ottimizzazione (optimizer).

9.4.6.1 Funzione di Perdita (Loss Function)

La funzione di perdita (loss function) quantifica la differenza tra la previsione della rete e la risposta corretta, denominata verità di riferimento (ground truth). Il risultato è uno scalare \(L\): minore è la perdita, più la previsione è vicina alla risposta attesa.

Nei problemi di classificazione multiclasse, la funzione più utilizzata è l’Entropia Incrociata (Cross-Entropy Loss), applicata alle probabilità prodotte dal livello Softmax:

\[ L=-\sum_{c=1}^{C} y_c \log(\hat{y}_c), \]

dove \(C\) è il numero di classi, \(y_c\) è l’etichetta reale in codifica one-hot e \(\hat{y}_c\) è la probabilità prevista per la classe \(c\). La perdita si avvicina a zero quando la rete attribuisce alta probabilità alla classe corretta e cresce rapidamente man mano che tale probabilità diminuisce.

La Figura 9.7 illustra questo comportamento: il simulatore consente di selezionare la classe corretta e modificare le probabilità prodotte dalla Softmax, mostrando in tempo reale la variazione della funzione di perdita.

📉 Simulatore: Funzione di Perdita (Entropia Incrociata) L = -log(ŷ_target)
CLASSE REALE DELL'IMMAGINE (GROUND TRUTH: y_c = 1)
PROBABILITÀ STIMATE DALLA SOFTMAX (ŷ_c)
🏠 Casa (ŷ_1): 0.70
😊 Felice (ŷ_2): 0.20
😢 Triste (ŷ_3): 0.10
Curva di Penalizzazione L = -log(ŷ_target)
CALCOLO DELLA PERDITA:
Perdita L = 0.3567
Figura 9.7: Simulatore interattivo della Funzione di Perdita (Cross-Entropy): seleziona la classe reale dell’immagine (Casa, Felice o Triste) e regola le probabilità stimate dalla Softmax per visualizzare il calcolo della penalizzazione scalare e il grafico del logaritmo negativo in tempo reale.

9.4.6.2 Retropropagazione (Backpropagation)

Dopo il calcolo della perdita, è necessario determinare come ciascun parametro della rete contribuisca a questo risultato. Questa fase è realizzata dalla retropropagazione (backpropagation), che applica la Regola della Catena del calcolo differenziale per ottenere il gradiente della funzione di perdita rispetto a ciascun parametro.

Per un parametro \(w\), questo gradiente è dato da

\[ \frac{\partial L}{\partial w}. \]

Il gradiente indica come varia la perdita in relazione a piccole modifiche di \(w\): un gradiente positivo indica che aumentare \(w\) aumenta la perdita, mentre un gradiente negativo indica l’effetto opposto.

La Figura 9.8 presenta questo processo in modo visivo, mostrando la propagazione del gradiente dallo strato di output fino ai primi strati convoluzionali.

⬅️ Simulatore: Retropropagazione (Backpropagation) ∂L/∂w = (∂L/∂y) · (∂y/∂z) · (∂z/∂w)
Passo 1 di 4: Output (Loss & Softmax)
DIREZIONE DELLA PROPAGAZIONE DELL'ERRORE (FLUSSO INVERSO ⟵)
Kernel Conv1
∂L/∂K
⟵
Max-Pooling
∂L/∂X_pool
⟵
Layer FC
∂L/∂W_fc
⟵
Loss / Softmax
∂L/∂y_pred
🔗 Regola della Catena nel Layer Corrente:
Figura 9.8: Simulatore interattivo di Backpropagation: procedi attraverso i passaggi della Regola della Catena per seguire il flusso del segnale di errore nella direzione inversa della rete, osservando il calcolo delle derivate parziali del gradiente in ogni strato.

9.4.6.3 Algoritmi di Ottimizzazione

Dopo il calcolo dei gradienti, un algoritmo di ottimizzazione (optimizer) aggiorna i parametri della rete per ridurre la funzione di perdita. Nelle reti profonde, questa ricerca avviene in uno spazio ad alta dimensionalità e, in generale, non convesso, il che rende l’ottimizzazione un problema complesso.

Per facilitare la comprensione, la Figura 9.9 utilizza una superficie di perdita semplificata, con un minimo globale, un minimo locale e una barriera tra queste regioni. Il minimo globale corrisponde al valore più basso della funzione di perdita e rappresenta il miglior insieme di parametri della rete; un minimo locale presenta anch’esso una bassa perdita, ma può essere distante dalla soluzione ottimale. Quando l’ottimizzazione rimane intrappolata in un minimo locale, gli aggiustamenti di filtri, pesi e bias diventano molto piccoli, e l’addestramento si ferma prima di raggiungere un modello con errore inferiore.

9.4.6.3.1 Discesa del Gradiente Stocastica (SGD)

La Discesa del Gradiente Stocastica (Stochastic Gradient Descent — SGD) aggiorna i parametri nella direzione opposta al gradiente:

\[ w_{\text{novo}} = w_{\text{atual}} - \eta \frac{\partial L}{\partial w}, \]

dove \(\eta\) è il tasso di apprendimento (learning rate), responsabile del controllo dell’ampiezza dell’aggiornamento. La SGD utilizza solo il gradiente dell’iterazione corrente; quando la ricerca raggiunge un minimo locale, i gradienti diventano molto piccoli e gli aggiornamenti cessano praticamente.

9.4.6.3.2 Ottimizzatori Adattivi: Adam

L’Adam (Adaptive Moment Estimation) combina stime adattative dei primi e secondi momenti dei gradienti (KINGMA, 2015), adattando il tasso di apprendimento di ogni parametro individualmente. Questa adattazione favorisce, in molti casi, il superamento dei minimi locali che trattenerebbero il SGD.

La Figura 9.9 confronta la traiettoria del SGD e dell’Adam sulla stessa superficie di perdita non convessa.

⚡ Simulador: Otimização com Curvas de Nível (SGD vs. Adam) Relevo Não Convexo: Mínimo Local vs. Global
💡 Como ler este mapa: a seta amarela aponta na direção de descida (−∇L), que é o sentido oposto ao vetor gradiente (∇L). O otimizador avança nessa direção para reduzir a perda L(w1, w2) até atingir as regiões mais profundas (tons mais escuros).
ALGORITMO PRINCIPAL (linha sólida)
TAXA DE APRENDIZADO (η)
Mapa de Calor da Perda L(w₁, w₂) — clique para escolher o início
Mínimo Global Mínimo Local Gradiente (↓ descida) Trajetória principal Fantasma (outro otimizador)
ESTADO DA OTIMIZAÇÃO:
w₁ = 1.80, w₂ = 0.20
Loss L = 2.450
PASSO
0
|∇L| (MAGNITUDE)
0.000
Status: Ponto Inicial
Figura 9.9: Simulador interativo dos Algoritmos de Otimização: compare a trajetória do SGD e do Adam sobre uma superfície de perda não convexa com mapa de calor e curvas de nível. A linha sólida mostra o otimizador selecionado avançando passo a passo; a linha tracejada mostra, para comparação instantânea, o caminho completo que o outro otimizador percorreria a partir do mesmo ponto inicial. Observe como o SGD fica retido no Mínimo Local à direita, enquanto o Adam pode ou não transpor a barreira central dependendo do impulso acumulado e da taxa de aprendizado. Clique em qualquer ponto do mapa para redefinir o ponto inicial dos pesos.

9.4.7 Architettura di una CNN

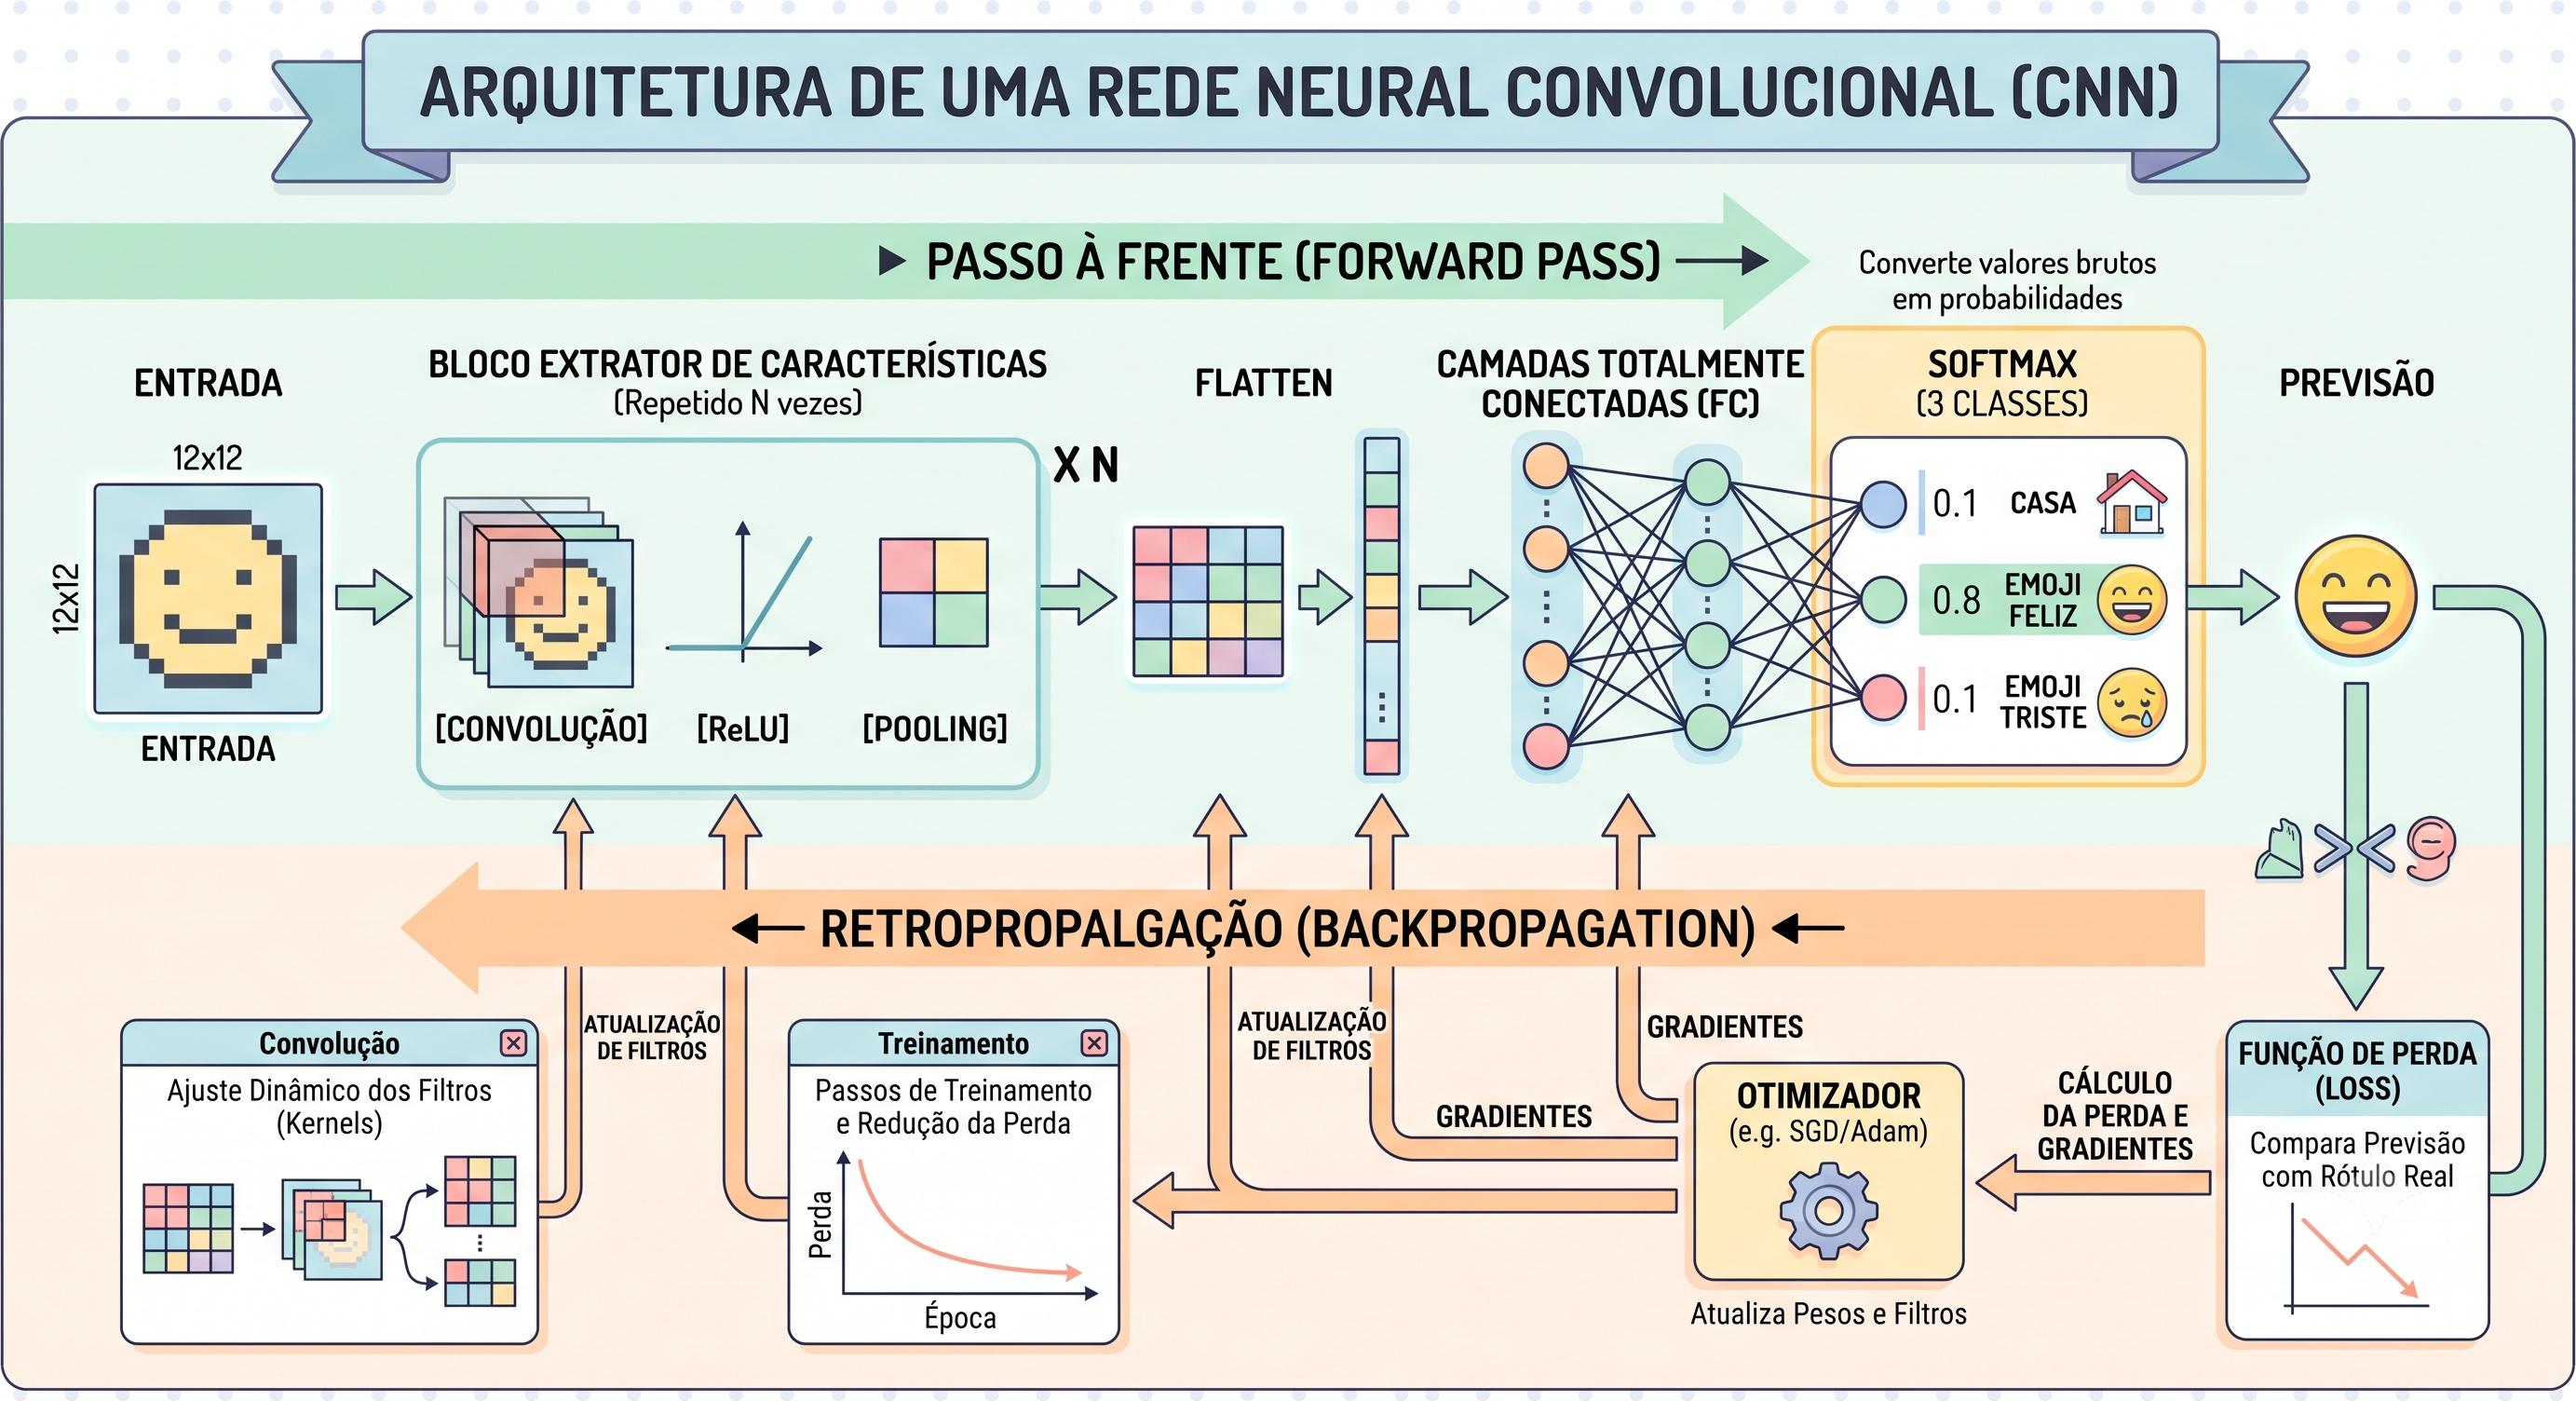
Una CNN per la classificazione delle immagini combina i livelli presentati nelle sezioni precedenti. Durante il passo in avanti (forward pass), l’immagine attraversa successivamente i livelli convoluzionali, le funzioni di attivazione, le operazioni di pooling, la fase di Flatten, i livelli completamente connessi e, infine, il livello Softmax, che produce le probabilità delle classi. Durante l’addestramento, questa previsione viene confrontata con l’etichetta corretta per calcolare la funzione di perdita, eseguire la retropropagazione e aggiornare i parametri tramite un algoritmo di ottimizzazione.

La Figura 9.10 presenta questo flusso di elaborazione e addestramento.

Figura 9.10: Architettura semplificata di una CNN per la classificazione delle immagini, evidenziando il forward pass e le fasi di addestramento tramite la funzione di perdita, la retropropagazione e l’algoritmo di ottimizzazione.

Dopo l’ultimo blocco convoluzionale, l’operazione Flatten riorganizza le mappe delle caratteristiche in un vettore unidimensionale, che alimenta i livelli completamente connessi (fully connected layers), responsabili di combinare le caratteristiche estratte per produrre i punteggi (logits) di ciascuna classe. Il livello Softmax converte questi punteggi in una distribuzione di probabilità, utilizzata sia per la classificazione sia per il calcolo della funzione di perdita durante l’addestramento.

La Figura 9.11 presenta una versione interattiva di questa architettura, consentendo di eseguire fasi successive di addestramento e di osservare la riduzione della perdita, la retropropagazione dei gradienti e l’aggiornamento dei filtri della rete.

⚙️ Simulatore: Architettura Completa di una CNN Input (12×12) → Conv → Pool → FC → Softmax
IMMAGINE DI INPUT DEL PIPELINE (12×12)
🎯 Addestramento (Forward Pass + Retropropagazione)
Input ▸ Conv+ReLU ▸ Pool ▸ Flatten ▸ FC ▸ Softmax ▸ Previsione
Perdita ◂ Ottimizzatore ◂ Retropropagazione ◂ (a ogni passo)
PERDITA (LOSS)
ACCURATEZZA
Loss: —
Accuratezza: —
Passo di addestramento: 0
I kernels e i pesi iniziano casuali (non sono più i filtri fissi del simulatore precedente). A ogni passo, la rete esegue il forward pass sulle 3 immagini, calcola la perdita (cross-entropy) e a accuratezza (quante delle 3 immagini sono classificate correttamente), retropropaga l'errore e regola tutti i pesi (inclusi i kernels della convoluzione) tramite discesa del gradiente. ⚠️ Poiché il "set di addestramento" ha solo 3 esempi, ciò dimostra il meccanismo dell'addestramento (perdita in calo, accuratezza in aumento, pesi che cambiano) — non la capacità di generalizzare a immagini nuove, che richiederebbe molti più dati.
Figura 9.11: Simulatore interattivo dell’architettura di una CNN: scegli una delle immagini di ingresso 12×12 (casa, viso felice o triste), clicca su ciascun blocco del pipeline — Ingresso, Conv+ReLU, Pooling, Flatten, FC e Softmax — ed esegui passi di addestramento reali (forward pass + retropropagazione) per osservare la perdita e l’accuratezza evolversi, i kernel essere regolati e il Softmax iniziare a puntare alla classe corretta.

9.4.8 Come il Gradiente Regola i Kernel della Convoluzione

La comprensione del processo di apprendimento in una Rete Neurale Convoluzionale (CNN) richiede la chiarificazione di un meccanismo fondamentale: come i coefficienti casuali di un filtro iniziale si trasformano in rilevatori precisi di bordi, texture e pattern complessi.

La risposta risiede nel principio della condivisione dei pesi (weight sharing). Durante la fase di propagazione in avanti (forward pass), lo stesso filtro di dimensione \(3\times3\) scorre su tutta l’estensione dell’immagine di input. Di conseguenza, ogni peso del kernel — come l’elemento \(K[0][0]\) nell’angolo superiore sinistro — viene riutilizzato più volte lungo le diverse regioni spaziali del dato di input.

Durante la fase di retropropagazione (backpropagation), questo riutilizzo stabilisce una dinamica diretta: ogni posizione spaziale elaborata dal filtro genera un contributo individuale (“voto”) per l’aggiornamento del rispettivo peso.

9.4.8.1 L’Intuizione Dietro il Calcolo

Sia \(Z[r][c]\) la mappa delle caratteristiche pre-attivazione nella posizione \((r,c)\) della finestra scorrevole, ottenuta tramite la correlazione incrociata tra il kernel \(K\) e l’input \(X\):

\[ Z[r][c] = \sum_{k_r} \sum_{k_c} K[k_r][k_c] \cdot X[r + k_r][c + k_c] \]

Applicando la regola della catena per determinare il contributo di un peso specifico \(K[k_r][k_c]\) nella funzione di perdita \(L\), si ottengono i seguenti passaggi:

  1. Errore Locale (\(dZ\)): In ogni posizione \((r,c)\), si calcola la derivata parziale della funzione di perdita rispetto alla pre-attivazione: \[dZ[r][c] = \frac{\partial L}{\partial Z[r][c]}\] che quantifica la responsabilità di quella specifica posizione nell’errore totale della rete (\(L\)).

  2. Contributo del Peso: Poiché \(\frac{\partial Z[r][c]}{\partial K[k_r][k_c]} = X[r + k_r][c + k_c]\), l’influenza di un peso specifico \(K[k_r][k_c]\) sull’errore della posizione \((r,c)\) si ottiene moltiplicando l’errore locale \(dZ[r][c]\) per il valore del pixel di input allineato a quel peso nel momento del calcolo: \[dZ[r][c] \cdot X[r + k_r][c + k_c]\]

  3. Accumulo dei Gradienti: Il gradiente finale del peso corrisponde alla somma dei contributi (“voti”) di tutte le posizioni percorse dalla finestra scorrevole:

\[ \frac{\partial L}{\partial K[k_r][k_c]} = \sum_{(r,c)} dZ[r][c] \cdot X[r + k_r][c + k_c] \]

Questa formulazione assicura una parità diretta tra la derivazione analitica e i valori calcolati nel simulatore di ispezione del gradiente (Figura 9.12).

9.4.8.2 Il Ruolo della Funzione ReLU come “Filtro di Rilevanza”

L’applicazione della funzione di attivazione ReLU (\(\max(0, z)\)) immediatamente dopo la convoluzione introduce una proprietà di selettività al gradiente:

  • Attivazione Positiva (\(Z[r][c] > 0\)): La derivata della ReLU è \(1\). L’errore locale viene propagato integralmente (\(dZ \neq 0\)), consentendo alla posizione di contribuire all’aggiornamento dei pesi del kernel.
  • Attivazione Inattiva (\(Z[r][c] \le 0\)): La derivata della ReLU è \(0\). L’errore locale viene annullato (\(dZ = 0\)), sopprimendo il contributo della posizione al gradiente finale.

Nota didattica: La ReLU garantisce che solo le regioni spaziali che hanno prodotto risposte attive durante la propagazione in avanti abbiano la capacità di modificare i pesi del kernel nel processo di retropropagazione.

9.4.8.3 Aggiornamento dei Pesi tramite Discesa del Gradiente

Dopo il consolidamento dei gradienti accumulati da tutte le posizioni, l’aggiornamento del peso avviene secondo l’algoritmo della Discesa del Gradiente Stocastica (SGD):

\[ K[k_r][k_c] \leftarrow K[k_r][k_c] - \eta \cdot \frac{\partial L}{\partial K[k_r][k_c]} \]

dove \(\eta\) denota il tasso di apprendimento (learning rate).

  • Se la somma dei gradienti è positiva, il valore del peso viene ridotto.
  • Se la somma è negativa, il valore del peso viene incrementato.

9.4.8.4 Esplorando il Simulatore Interattivo

Nota🔗 Dall’Architettura Globale all’Ispezione del Gradiente

Nel simulatore di architettura (Figura 9.11), si osserva l’errore \(dZ\) derivato dalla completa retropropagazione multistrato, originato dalla perdita di entropia incrociata (Softmax) sulle immagini di input \(12\times12\).

Per rendere possibile la verifica analitica del gradiente senza il sovraccarico di \(100\) posizioni di convoluzione e retropropagazione multistrato, il simulatore di apprendimento del kernel (Figura 9.12) adotta un modello di ispezione ridotto (\(6\times6\)). In questo scenario, si semplifica il problema sostituendo la classificazione complessa con un meta-dato di calibrazione scalare: si regola il filtro per produrre una risposta accumulata predefinita (\(\text{alvo} = 9\)) quando identifica un pattern specifico (come un bordo a 45 gradi). Il meccanismo di accumulo dei gradienti (\(dZ \cdot X\)) rimane rigorosamente identico in entrambe le formulazioni.

Per ispezionare questa dinamica a livello numerico, si utilizza il simulatore nella Figura 9.12:

  • Immagine di Input (\(X\)): Matrice \(6\times6\).
  • Filtro Convoluzionale (\(K\)): Matrice \(3\times3\) (9 pesi).
  • Mappa di Output (\(Z\) / \(A\)): Matrice \(4\times4\) (16 posizioni della finestra).
  • Funzione di Perdita (\(L\)): Definita da \(L = \frac{1}{2}(S - \text{alvo})^2\), dove \(S = \sum A[r][c]\) rappresenta la somma globale delle attivazioni post-ReLU.

Il ruolo del \(\text{alvo} = 9\): Il valore scalare \(\text{alvo} = 9\) rappresenta l’“energia di attivazione” ideale stabilita per l’immagine con bordo diagonale. Poiché la mappa \(A\) ha 16 posizioni, questo valore equivale a cercare una risposta media di \(\frac{9}{16} \approx 0,56\) per pixel attivato. Quando \(S > 9\), la rete identifica che il filtro sta reagendo con intensità eccessiva al pattern, generando un errore \(dZ > 0\) che forza la riduzione dei pesi \(K\). Quando \(S < 9\), i pesi vengono incrementati per amplificare il segnale.

9.4.8.4.1 Percorso Suggerito per la Sperimentazione:
  1. Selezione del Peso: Nella griglia \(3\times3\), scegli il peso da analizzare (es.: \(K[0][0]\)).
  2. Scansione della Finestra: Utilizza il pulsante “▶ Avanza posizione” per seguire lo spostamento della finestra attraverso le 16 posizioni spaziali. Nota l’evidenziazione visiva nella cella della mappa di input che allinea il pixel \(X\) al peso selezionato.
  3. Analisi del Voto Locale: Esamina il prodotto dell’errore locale per il pixel di input (\(dZ \cdot X\)) nel pannello di calcolo della posizione.
  4. Verifica della Cronologia: Segui il consolidamento dei 16 risultati parziali organizzati nelle quattro colonne della cronologia, osservando l’accumulo del gradiente finale.
  5. Aggiornamento del Kernel: Clicca su “▶ Applica passo di discesa del gradiente” per visualizzare la convergenza della curva di perdita e l’adattamento del kernel casuale al pattern di input selezionato.
🧮 Simulatore: Gradiente di un Peso del Kernel ∂Perdita / ∂K[kr][kc] = Σ dZ · X
MODELLO DI INPUT (IMMAGINE 6×6)? Sceglie quale immagine 6×6 alimenta la convoluzione.
TASSO DI APPRENDIMENTO (η)? Tasso di apprendimento. Regola per vedere la differenza tra convergenza fluida (0.002) e collasso per overshooting (0.02).
Esempio ridotto: immagine 6×6 e filtro 3×3 che generano mappe 4×4. Fai clic sulle schede "🔍 Come viene calcolato?" sotto ogni matrice per capire i calcoli passo dopo passo. Passa il mouse su qualsiasi cella di X, Z, A, dZ o K per vedere il calcolo esatto di quel valore, con gli elementi usati nei livelli correlati evidenziati con contorno tratteggiato/blu.
1. PESO DEL KERNEL? Seleziona quale peso del kernel vuoi analizzare singolarmente.
KERNEL ATTUALE (K)? Valori del filtro 3×3. Il peso selezionato è evidenziato in blu. Passa il mouse su un peso per vedere dove viene usato.
🔍 Come viene aggiornato?
Regola del gradiente:
K ← K − η · ∇K
• η = tasso di apprendimento.
• ∇K = somma dei 16 voti dZ × X.
INPUT X (6×6)? Immagine 6×6. Pixel blu = sovrapposizione con il peso K selezionato nella finestra corrente. Passa il mouse su un pixel per vedere in quali posizioni di Z viene usato.
🔍 Come funziona X?
Matrice di input. Nella posizione (r,c), il peso K moltiplica il pixel:
X[r + kr][c + kc]
PRE-ATTIVAZIONE Z (4×4)? Risultato della convoluzione prima del ReLU: Z = Σ K · X. Passa il mouse su una cella per vedere i 9 termini della somma, evidenziando la finestra in X e tutto il kernel K.
🔍 Come calcola Z?
Correlazione incrociata:
Moltiplicazione punto per punto del filtro 3×3 su X:
Z[r][c] = Σ K · X
ATTIVAZIONE A (4×4)? Risultato post-ReLU: A = max(0, Z). Se Z ≤ 0, l'attivazione viene azzerata. Passa il mouse su una cella per evidenziare il Z corrispondente.
🔍 Come calcola A?
Funzione ReLU:
A[r][c] = max(0, Z[r][c])
Somma globale (S):
S = Σ A[r][c]
ERRORE dZ (4×4)? Errore propagato: dZ = (S - obiettivo) · I(Z > 0). Dove A=0, anche l'errore dZ è 0. Passa il mouse su una cella per vedere il calcolo completo, evidenziando il Z corrispondente e tutte le 16 celle di A che formano S.
🔍 Come calcola dZ, S e Loss?
1. Perdita (Loss L):
L = ½ (S − obiettivo)²
2. Errore propagato dZ:
dZ = (S − obiettivo) · deriv_ReLU(Z)
2. CALCOLO E SOMMA DEI "VOTI" DI OGNI POSIZIONE? Ogni posizione (r,c) genera un voto = dZ[r][c] × X[r+kr][c+kc]. La somma di tutti i 16 voti forma il gradiente del peso.
CALCOLO DI QUESTA POSIZIONE? Mostra l'errore locale (dZ) e il pixel di input (X) moltiplicati nella posizione corrente della finestra scorrevole.
SOMMA ACCUMULATA (GRADIENTE)? Il valore accumulato dei prodotti dZ × X di tutte le posizioni già percorse. Quando raggiunge 16/16, questo è il gradiente finale del peso.
STORICO DELLE 16 POSIZIONI (COLONNE c=0, c=1, c=2, c=3)? Segui l'elenco di tutte le 16 posizioni organizzate in 4 colonne per corrispondere al movimento della finestra sull'immagine di output.
3. USA IL GRADIENTE PER AGGIORNARE IL KERNEL? Applica la regola della Discesa del Gradiente (K ← K − η · gradiente) per tutti i 9 pesi.
PERDITA NEL CORSO DEGLI AGGIORNAMENTI? Evoluzione dell'errore L = ½(S − obiettivo)²:
• Obiettivo: L → 0 (S → obiettivo).
• Se si blocca su L = 40.5: Si è verificato "overshooting" (salto eccessivo). I pesi sono diventati molto negativi, generando Z ≤ 0 (morte della ReLU). Con S = 0, la perdita si blocca su ½(0 − 9)² = 40.5.
Figura 9.12: Simulatore interattivo del calcolo del gradiente di un peso del kernel convoluzionale.
Nota🧠 Sintesi — Dalla convoluzione all’apprendimento di rappresentazioni

I simulatori di questa sezione dimostrano, in modo sequenziale, come una CNN trasformi un’immagine in ingresso in una stima probabilistica e come i suoi parametri vengano ottimizzati durante l’addestramento:

  • Convoluzione: applica filtri sull’immagine per estrarre caratteristiche locali, generando mappe di caratteristiche mediante la condivisione dei pesi.
  • ReLU: introduce non linearità nel sistema, consentendo la modellazione di relazioni complesse tra i dati.
  • Pooling: riduce la risoluzione spaziale delle mappe di caratteristiche, diminuendo il costo computazionale e conferendo invarianza a piccole traslazioni locali.
  • Flatten: riorganizza le mappe multidimensionali in un vettore unidimensionale per alimentare i layer successivi.
  • Layer completamente connesso: combina le caratteristiche estratte per produrre i punteggi grezzi (logits) associati a ciascuna classe.
  • Softmax: converte i logits in una distribuzione di probabilità normalizzata.
  • Funzione di perdita: confronta la distribuzione prevista con la verità di riferimento (ground truth), quantificando scalarmente l’errore della rete.
  • Retropropagazione: applica la regola della catena per calcolare la derivata parziale (gradiente) della funzione di perdita rispetto a ciascun parametro addestrabile.
  • Ottimizzatore: aggiorna i coefficienti dei filtri, i pesi e i bias nella direzione opposta al gradiente, riducendo la perdita a ogni iterazione.

Nel corso delle iterazioni, i filtri convoluzionali si trasformano da valori stocastici in rilevatori specializzati: i layer iniziali apprendono primitive visive di basso livello (come bordi e trame), mentre i layer più profondi consolidano queste rappresentazioni in strutture astratte e semantiche.

9.5 Applicazioni Pratiche in VC

Dopo la consolidazione teorica dei fondamenti delle CNN e la verifica visiva di ciascuna delle loro operazioni elementari tramite i simulatori interattivi, diventa essenziale osservare l’integrazione di queste fasi in pipeline complete di programmazione.

Nelle sezioni seguenti, la teoria viene tradotta in codice eseguibile in PyTorch, esplorando i tre compiti fondamentali della VC: classificazione, rilevamento di oggetti e segmentazione semantica. Questa progressione pratica consente di analizzare dalla costruzione di un’architettura convoluzionale addestrata da zero fino all’applicazione di strategie avanzate di transfer learning (transfer learning) su modelli pre-addestrati per set di dati sintetici e reali.

9.5.1 Classificazione delle Immagini con CNN

La classificazione delle immagini è una delle applicazioni più tradizionali delle CNN. In questo compito, l’obiettivo è assegnare un’unica etichetta all’immagine in ingresso, come identificare una categoria di oggetto, una specie animale o una classe diagnostica. A tal fine, la CNN trasforma progressivamente i valori dei pixel in rappresentazioni a più alto livello di astrazione, combinando strati convoluzionali, funzioni di attivazione e operazioni di riduzione spaziale fino a produrre una distribuzione di probabilità tra le classi possibili. In questa sezione vengono presentati l’architettura di base di una CNN classificatrice, il flusso di trasformazione dei dati lungo la rete e il processo di addestramento per l’ajustamento dei parametri appresi.

9.5.1.1 Addestramento di una CNN da Zero su Cifre

Per stabilire un confronto diretto con gli approcci presentati nel Capitolo 7, in questa sezione si sviluppa una CNN addestrata sullo stesso insieme di dati di cifre scritte a mano (load_digits). La differenza fondamentale risiede nella fase di rappresentazione: mentre i metodi classici dipendono da pixel grezzi o da descrittori calcolati manualmente, come l’Histogram of Oriented Gradients (HOG), la CNN apprende automaticamente i coefficienti dei filtri convoluzionali durante il processo di ottimizzazione.

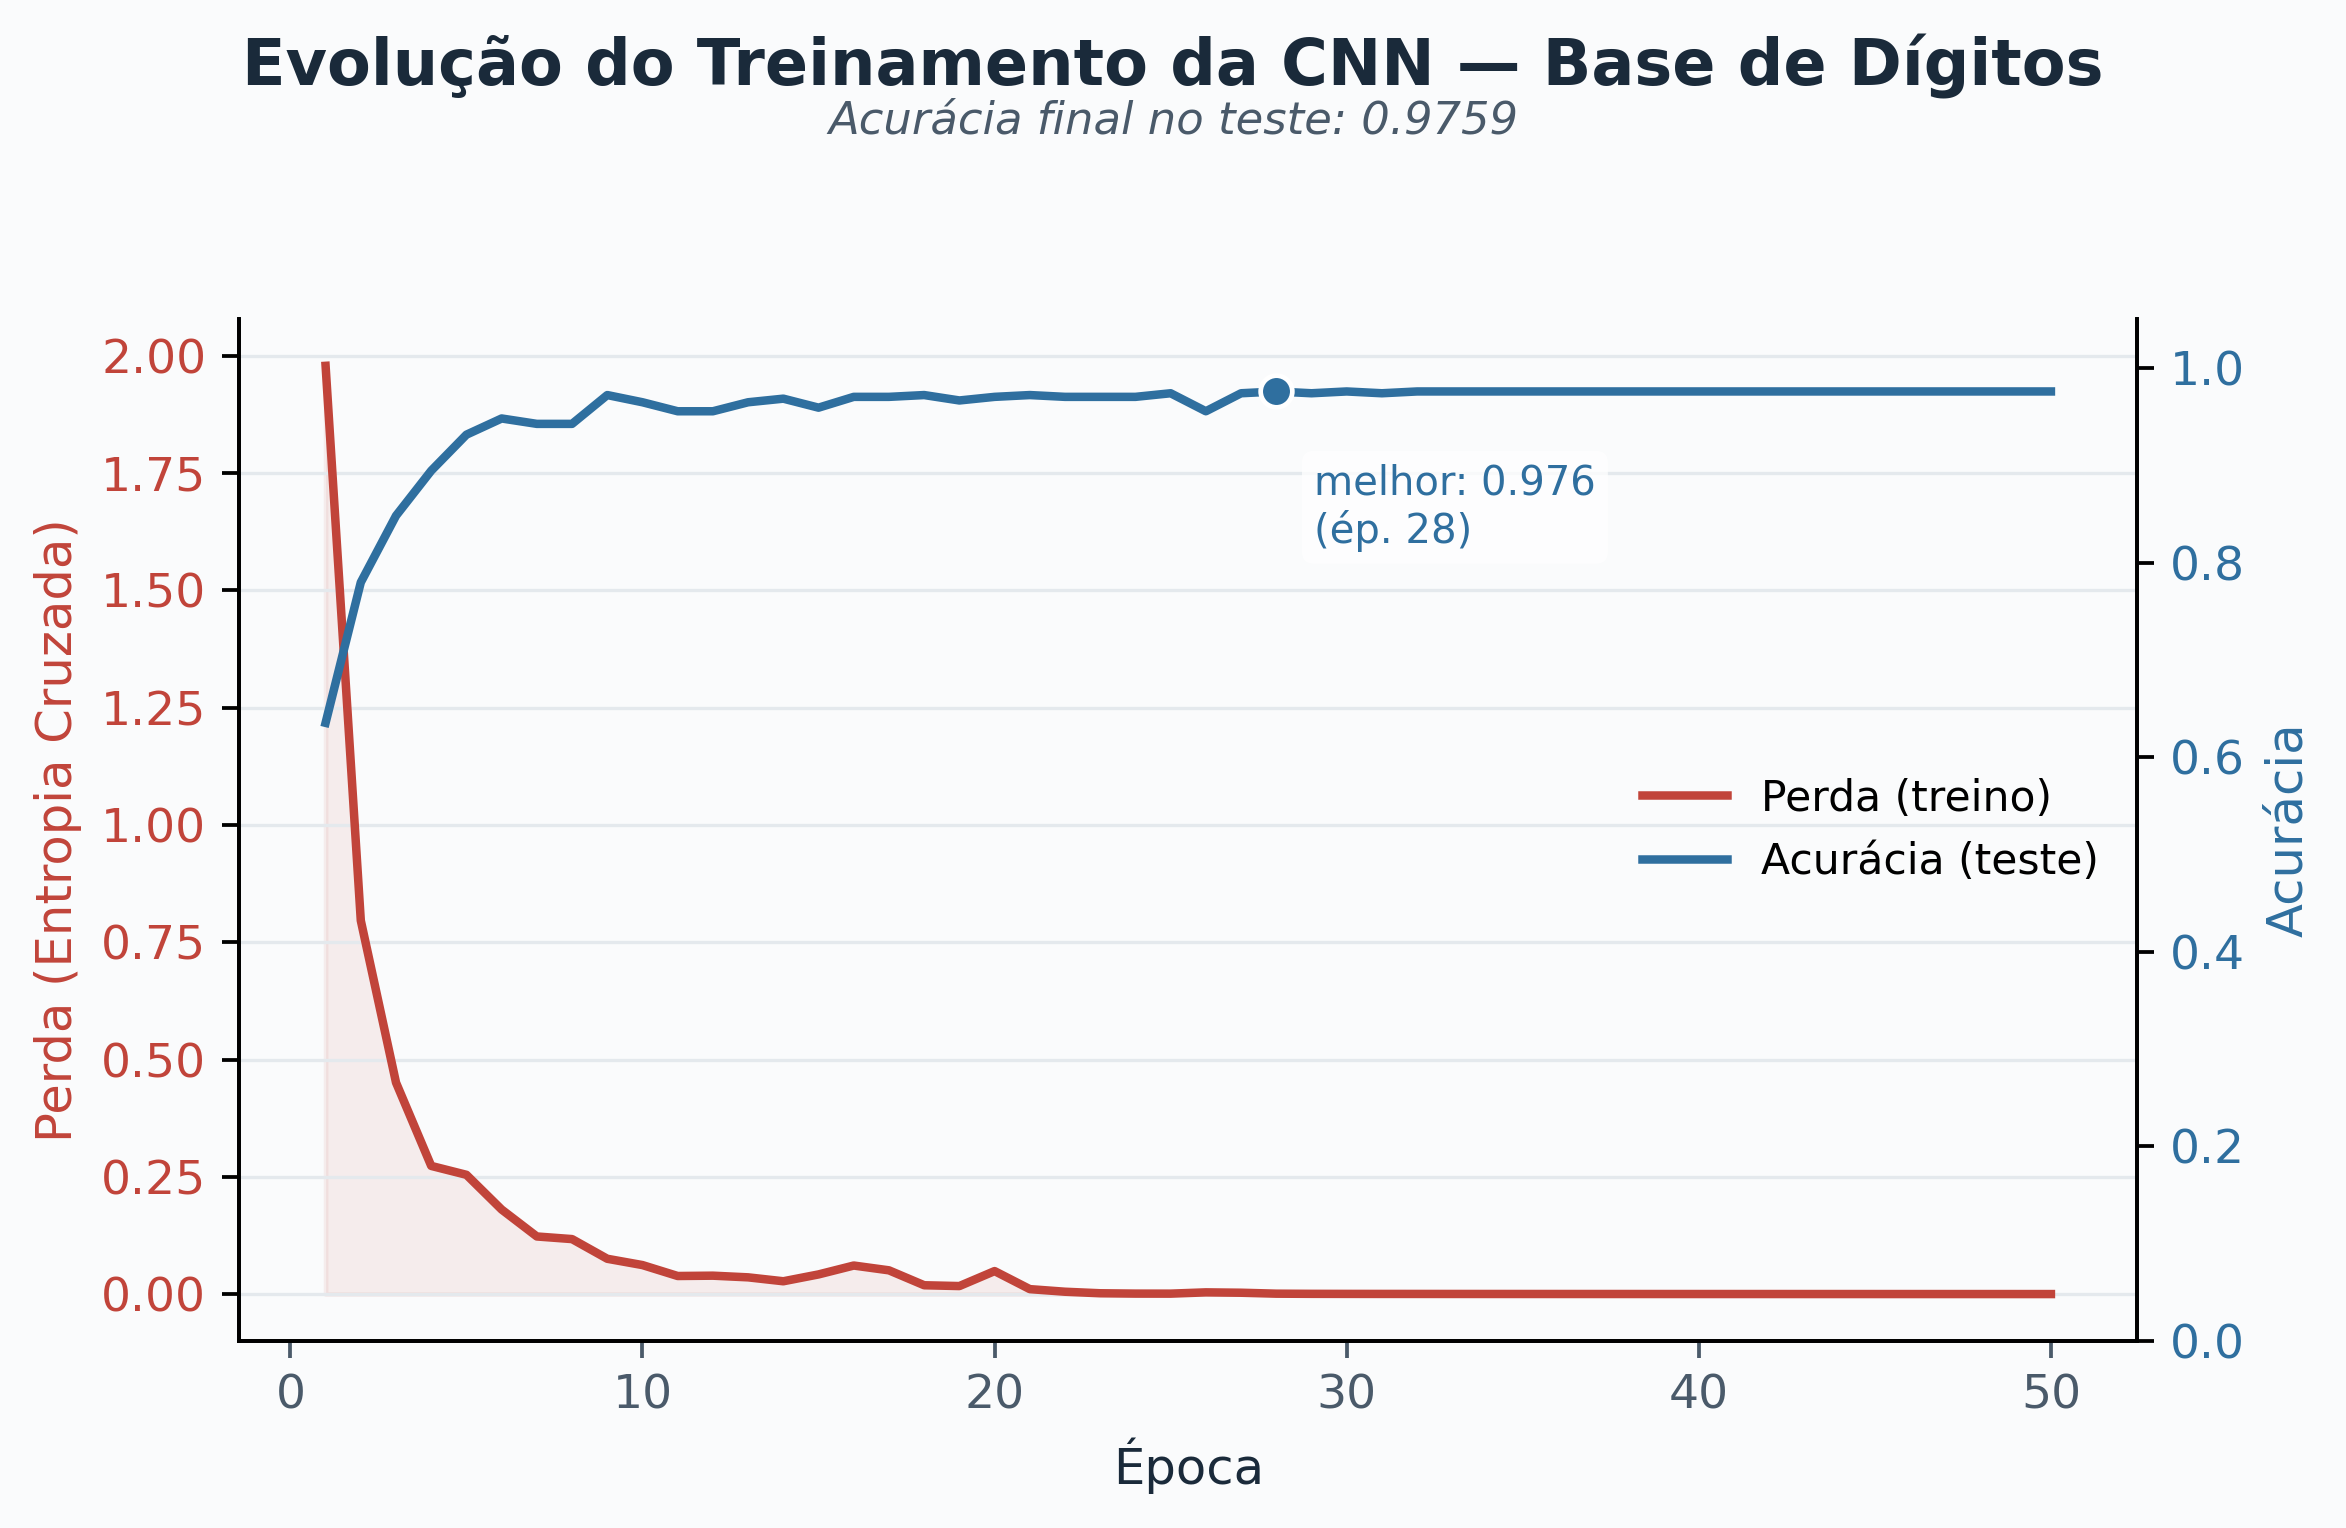
I codici seguenti (consolidati nella Figura 9.15) eseguono la preparazione dei dati, definiscono un’architettura convoluzionale semplice in PyTorch, eseguono il ciclo di addestramento tramite l’algoritmo Adam e generano le curve di evoluzione della funzione di perdita e dell’accuratezza.

9.5.1.1.1 Blocco 1: Preparazione e Strutturazione dei Dati

La fase iniziale di qualsiasi pipeline di Deep Learning consiste nella conversione e nell’adattamento dei dati di input al formato richiesto dal framework di calcolo scientifico.

9.5.1.1.1.1 Il Concetto di Tensor

Nel Deep Learning, la struttura fondamentale dei dati è il tensor. Dal punto di vista computazionale, un tensor consiste in un array multidimensionale di numeri generalizzato a \(n\) dimensioni:

  • Un tensor di ordine 0 è uno scalare (un singolo valore).
  • Un tensor di ordine 1 è un vettore (lunghezza).
  • Un tensor di ordine 2 è una matrice (righe e colonne).
  • Un tensor di ordine 3 o superiore rappresenta un volume o un iper-array di dati.

Nel contesto di PyTorch, la classe torch.Tensor estende la funzionalità degli array numerici multidimensionali (come quelli di NumPy) offrendo supporto a operazioni accelerate su hardware tramite GPU (Graphics Processing Units) e supporto al calcolo automatico delle derivate (autograd), essenziale per l’algoritmo di retropropagazione.

9.5.1.1.1.2 Analisi del Codice di Pre-elaborazione
  1. Caricamento e Normalizzazione delle Intensità: Il dataset load_digits contiene \(1.797\) campioni di cifre scritte a mano di \(8 \times 8\) pixel, le cui intensità originali variano sulla scala intera da \(0\) a \(16\). La divisione per \(16.0\) esegue la normalizzazione dei dati nell’intervallo \([0.0, 1.0]\). Questa trasformazione in scala floating-point (float32) è indispensabile nelle reti neurali per evitare la saturazione delle funzioni di attivazione e stabilizzare il calcolo dei gradienti nell’algoritmo di ottimizzazione.

  2. Divisione Stratificata (70% Addestramento / 30% Test): La funzione train_test_split separa il \(70\%\) dei campioni per l’adattamento dei parametri della rete e riserva il \(30\%\) per la valutazione del modello su dati non visti. Il parametro stratify=y garantisce il campionamento stratificato, mantenendo la proporzione esatta di ciascuna delle 10 classi di cifre (\(0\) a \(9\)) in entrambi gli insiemi, prevenendo distorsioni nella distribuzione.

  3. Adattamento Dimensionale per la Convoluzione 2D (unsqueeze): Nelle CNN, i layer convoluzionali bidimensionali (nn.Conv2d) richiedono che il tensor di input possieda strettamente 4 dimensioni nell’ordinamento \((N, C, H, W)\):

    • \(N\): numero di campioni (batch size).
    • \(C\): numero di canali di colore (\(1\) per scala di grigi, \(3\) per RGB).
    • \(H\): altezza dell’immagine in pixel (\(8\)).
    • \(W\): larghezza dell’immagine in pixel (\(8\)).

    Poiché l’array originale possiede un formato \(3\text{D}\) del tipo \((N, 8, 8)\), la chiamata .unsqueeze(1) inserisce una dimensione unitaria specificamente all’indice 1 (la posizione riservata al canale di colore \(C\)), trasformando la struttura in un tensor \(4\text{D}\) di formato \((N, 1, 8, 8)\), come richiesto da PyTorch.

  4. Conversione delle Etichette (dtype=torch.long): Le etichette delle classi \(y\) vengono convertite in tensor interi a 64 bit (torch.long). Questa specifica di tipo è un requisito della funzione di loss di Entropia Incrociata (nn.CrossEntropyLoss), che utilizza interi non negativi come indici per associare la classe corretta ai logits di output della rete.

Attenzione alle Dimensioni: La struttura finale è rappresentata dal tensor (N, 1, 8, 8), dove N è il numero di campioni (batch size), 1 è il canale di colore (scala di grigi) e 8×8 è la risoluzione spaziale dell’immagine in pixel.

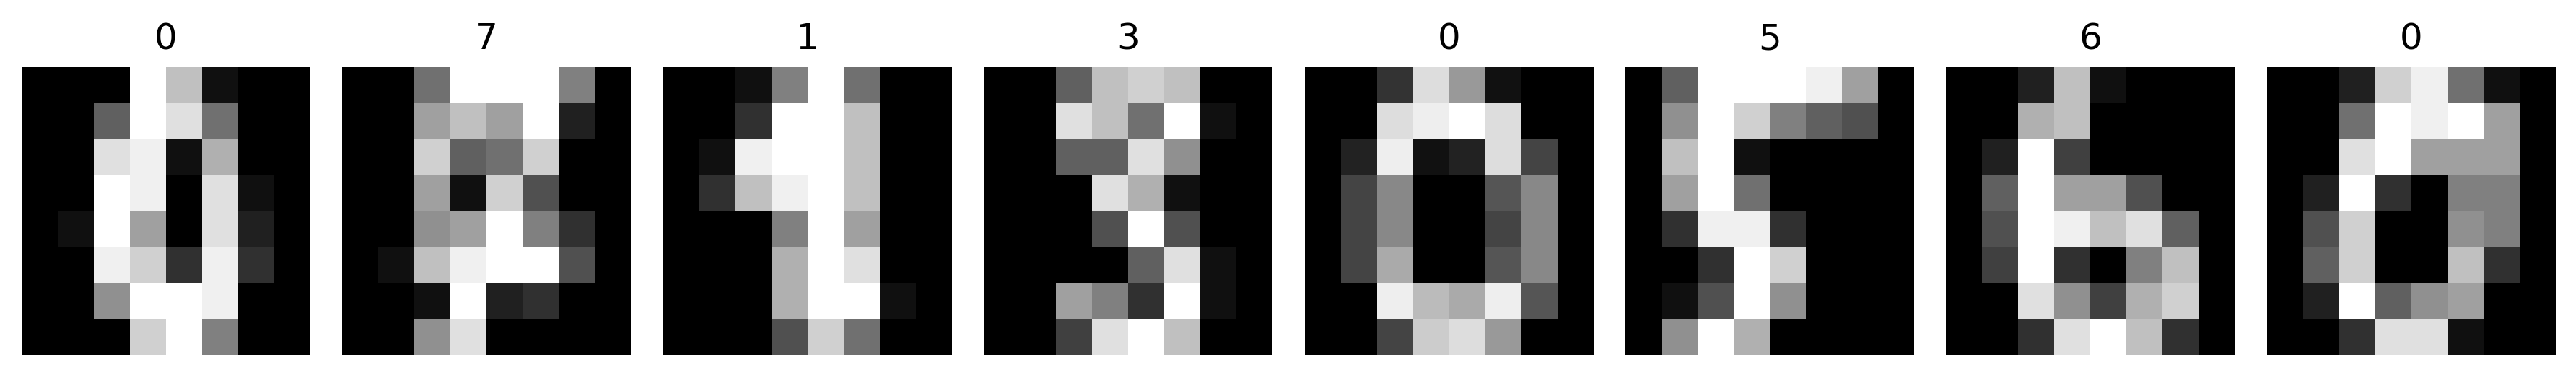
La Figura 9.13 illustra una sequenza di campioni dell’insieme di addestramento dopo la pre-elaborazione e l’adattamento dimensionale ai tensor di PyTorch. Nella fase di visualizzazione, la chiamata img.squeeze().numpy() combina due trasformazioni: il metodo .squeeze() elimina la dimensione unitaria ridondante del canale di colore, riducendo il tensor \(3\text{D}\) di formato (1, 8, 8) a una matrice \(2\text{D}\) di (8, 8); successivamente, il metodo .numpy() converte la struttura di PyTorch in una matrice nativa di NumPy, formato richiesto dagli strumenti di rendering grafico come mm.show().

# 1. Caricamento e pre-processamento dei dati
digits = load_digits()
X = digits.images.astype(np.float32) / 16.0  # Normalizzazione all'intervallo [0, 1]
y = digits.target

# Divisione stratificata in set di addestramento (70%) e test (30%)
X_treino, X_teste, y_treino, y_teste = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# Adeguamento alla dimensione prevista da PyTorch: (N_campioni, Canali, Altezza, Larghezza)
X_treino_t = torch.tensor(X_treino).unsqueeze(1)   # Dimensione: (N, 1, 8, 8)
y_treino_t = torch.tensor(y_treino, dtype=torch.long)
X_teste_t = torch.tensor(X_teste).unsqueeze(1)
y_teste_t = torch.tensor(y_teste, dtype=torch.long)

# Mostrare un campione
n_amostras = 8
imgs = [img.squeeze().numpy() for img in X_treino_t[:n_amostras]]
imgs_titles = [str(label.item()) for label in y_treino_t[:n_amostras]]
mm.show(imgs, titles=imgs_titles, cols=n_amostras, figsize=(12, 2.5))
Figura 9.13: Campioni di cifre dal set di addestramento dopo la conversione in tensori PyTorch e normalizzazione.
9.5.1.1.2 Bloco 2: Definizione dell’Architettura Convoluzionale

La costruzione di modelli in PyTorch è strutturata secondo il paradigma dell’orientamento a oggetti, creando una classe specifica per rappresentare la rete neurale (in questo esempio, la classe CNNDigitos), che eredita tutte le funzionalità della classe base nn.Module. Il costruttore __init__ è responsabile di istanziare i layer e dichiarare i loro parametri addestrabili, mentre il metodo forward stabilisce la sequenza numerica della propagazione in avanti (forward pass).

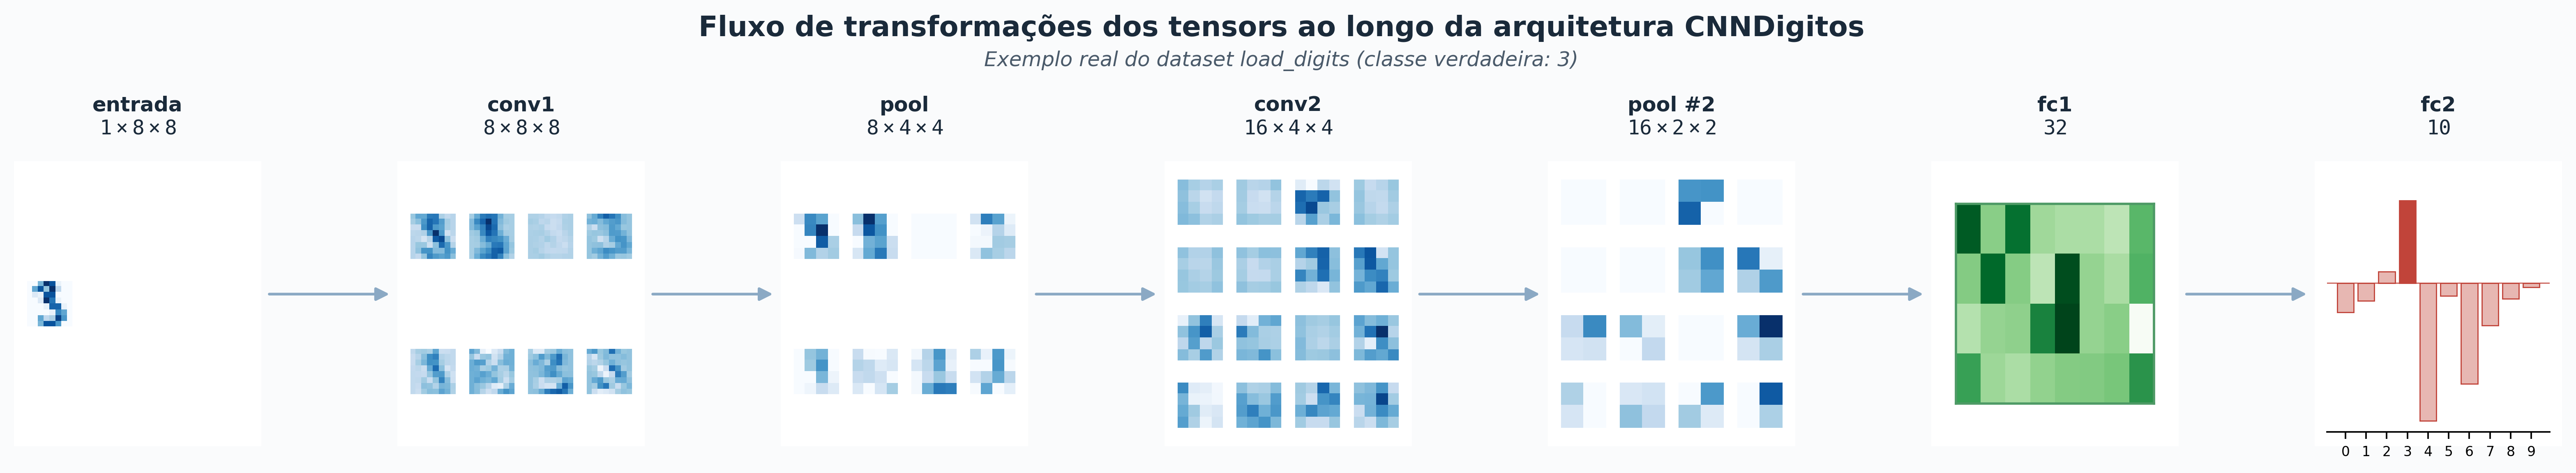
La Figura 9.14 sintetizza le trasformazioni spaziali dei tensor e il flusso di dati lungo la classe CNNDigitos.

Figura 9.14: Rappresentazione del flusso delle trasformazioni dimensionali dei tensor lungo l’architettura CNNDigitos.
  1. Costruttore (__init__) e Istanziazione dei Componenti:
    • Livello Convoluzionale 1 (self.conv1): Applica \(8\) filtri \(3 \times 3\) con padding=1 sull’input in scala di grigi (\(1\) canale), preservando la risoluzione spaziale di \(8 \times 8\) pixel.
    • Livello Convoluzionale 2 (self.conv2): Processa le \(8\) mappe di caratteristiche ricevute dal livello precedente applicando \(16\) filtri \(3 \times 3\) con padding=1.
    • Sottocampionamento (self.pool): Istanzia l’operazione di Max-Pooling con finestra \(2 \times 2\) e passo (stride) \(2\), riducendo la dimensione spaziale (altezza e larghezza) della metà a ogni applicazione.
    • Livelli Totalmente Connessi (self.fc1 e self.fc2): La prima proiezione densa riceve il tensor appiattito di dimensione \(16 \times 2 \times 2 = 64\) e produce \(32\) caratteristiche intermedie. La seconda proietta queste \(32\) caratteristiche nei \(10\) logit finali di output.
  2. Propagazione in Avanti nel Metodo forward:
    • Primo Blocco Convoluzionale: Il tensor di input di formato \((N, 1, 8, 8)\) passa attraverso conv1 + ReLU e viene sottocampionato da pool, risultando nel formato \((N, 8, 4, 4)\).
    • Secondo Blocco Convoluzionale: Il tensor \((N, 8, 4, 4)\) viene processato da conv2 + ReLU e ridotto da pool al formato \((N, 16, 2, 2)\).
    • Appiattimento (Flatten): Il metodo x.view(x.size(0), -1) riconfigura la struttura \(3\text{D}\) in un vettore \(1\text{D}\) di \(64\) elementi per campione, preservando la dimensione del batch \(N\).
    • Classificazione: Il vettore di \(64\) elementi alimenta fc1 con attivazione ReLU (\(32\) neuroni) e termina in fc2, producendo i \(10\) logit non normalizzati per il calcolo della funzione di perdita.
# 2. Definizione dell'architettura convoluzionale
class CNNDigitos(nn.Module):
    """
    Architettura convoluzionale compatta:
    2 strati convoluzionali con ReLU e Max-Pooling + 2 strati densi.
    """
    def __init__(self, n_classes=10):
        super().__init__()
        
        # Conv1: 1 canale di ingresso, 8 filtri 3x3 con padding 1 (uscita: 8x8)
        self.conv1 = nn.Conv2d(1, 8, kernel_size=3, padding=1)
        # Conv2: 8 canali di ingresso, 16 filtri 3x3 con padding 1 (uscita: 4x4)
        self.conv2 = nn.Conv2d(8, 16, kernel_size=3, padding=1)

        self.relu = nn.ReLU()

        # Max-Pooling 2x2 con passo (stride) 2
        self.pool = nn.MaxPool2d(2, 2)

        # Strati totalmente connessi (FC)
        self.fc1 = nn.Linear(16 * 2 * 2, 32)
        self.fc2 = nn.Linear(32, n_classes)

    def forward(self, x):
        # Primo blocco: Conv (8x8) -> ReLU -> Pool (4x4)
        x = self.pool(self.relu(self.conv1(x)))

        # Secondo blocco: Conv (4x4) -> ReLU -> Pool (2x2)
        x = self.pool(self.relu(self.conv2(x)))
        
        # Appiattimento (Flatten): riconfigura la matrice 3D (16, 2, 2) in vettore 1D (64)
        x = x.view(x.size(0), -1)

        # Strato denso intermedio con ReLU
        x = self.relu(self.fc1(x))

        # Strato finale di classificazione (logits)
        return self.fc2(x)
9.5.1.1.2.1 Analisi dei Strati e del Flusso della Classe CNNDigiti
  1. Costruttore (__init__) e Istanziazione dei Componenti:
    • Strato Convoluzionale 1 (self.conv1): Applica \(8\) filtri \(3 \times 3\) con padding=1 sull’ingresso in scala di grigi (\(1\) canale), preservando la risoluzione di \(8 \times 8\) pixel.
    • Strato Convoluzionale 2 (self.conv2): Processa le \(8\) mappe di caratteristiche ricevute applicando \(16\) filtri \(3 \times 3\) con padding=1.
    • Sottocampionamento (self.pool): Istanzia l’operazione di Max-Pooling con finestra \(2 \times 2\) e passo (stride) \(2\), riducendo le dimensioni spaziali (altezza e larghezza) della metà a ogni applicazione.
    • Strati Totalmente Connessi (self.fc1 e self.fc2): La prima proiezione densa riceve il tensore appiattito di dimensione \(16 \times 2 \times 2 = 64\) e produce \(32\) caratteristiche intermedie. La seconda proietta queste \(32\) caratteristiche nei \(10\) logit di uscita.
  2. Propagazione in Avanti nel Metodo forward:
    • Primo Blocco: Il tensore \((N, 1, 8, 8)\) passa attraverso conv1 + ReLU e viene ridotto da pool a \((N, 8, 4, 4)\).
    • Secondo Blocco: Il tensore \((N, 8, 4, 4)\) passa attraverso conv2 + ReLU e viene ridotto da pool a \((N, 16, 2, 2)\).
    • Appiattimento (Flatten): Il metodo x.view(x.size(0), -1) converte la struttura \(3\text{D}\) in un vettore \(1\text{D}\) di \(64\) elementi per campione.
    • Classificazione: Il vettore di \(64\) elementi alimenta fc1 con attivazione ReLU (\(32\) neuroni) e termina in fc2, che produce i \(10\) logit finali per il calcolo della perdita di Entropia Incrociata.
9.5.1.1.3 Bloco 3: Istanziazione e Parametri di Ottimizzazione

La fase di configurazione dell’apprendimento richiede l’istanziazione dell’architettura definita e la scelta di due componenti fondamentali: la funzione di perdita, che quantifica l’errore del modello, e l’algoritmo di ottimizzazione, responsabile dell’aggiustamento dei parametri verso il minimo di tale funzione.

  1. Istanziazione e Conteggio dei Parametri: Il modello viene creato mediante l’istanziazione dell’oggetto modello_cnn della classe CNNDigiti. L’espressione sum(p.numel() for p in modello_cnn.parameters()) esamina tutti i tensor dei parametri addestrabili della rete (pesi e bias di ogni livello) e calcola la cardinalità totale del modello, quantificandone la capacità di rappresentazione.

  2. Funzione di Perdita (nn.CrossEntropyLoss): La perdita di Entropia Incrociata (Cross-Entropy Loss) rappresenta la scelta standard per i problemi di classificazione multiclasse. In PyTorch, questa implementazione combina internamente l’applicazione della funzione LogSoftmax con la Perdita di Log-Verosimiglianza Negativa (NLLLoss). Per tale ragione, il livello di output della rete produce logit grezzi, eliminando la necessità di applicare esplicitamente la funzione Softmax al termine del metodo forward.

  3. Ottimizzatore Adattivo (optim.Adam): L’aggiornamento dei parametri utilizza l’algoritmo Adam (Adaptive Moment Estimation), con un tasso di apprendimento iniziale \(\eta = 0,01\) (lr=1e-2). L’Adam combina i principi del momento con l’adattamento della dimensione del passo basato sulla media mobile delle derivate del primo e secondo ordine, regolando individualmente il tasso di apprendimento di ciascun parametro della rete.

# 3. Inizializzazione del Modello e Parametri di Ottimizzazione
modelo_cnn = CNNDigitos()
num_params = sum(p.numel() for p in modelo_cnn.parameters())
print(f"Parametri addestrabili del modello: {num_params}")

criterio = nn.CrossEntropyLoss()
otimizador = optim.Adam(modelo_cnn.parameters(), lr=1e-2)
Parametri addestrabili del modello: 3658
9.5.1.1.4 Blocco 4: Ciclo di Addestramento e Valutazione

L’addestramento di una CNN avviene in modo iterativo tramite l’algoritmo di Discesa del Gradiente Stocastica per mini-batch (Mini-batch SGD).

Le curve di apprendimento risultanti da questo processo sono presentate nella Figura 9.15, generata al termine dell’esecuzione.

  1. Fase di Addestramento (modello_cnn.train()): Il ciclo principale esegue l’addestramento per \(50\) epoche. In ogni epoca, si svolgono le seguenti fasi:

    • Rimescolamento Stocastico: La funzione torch.randperm(n) genera una permutazione casuale degli indici dei campioni, garantendo che l’ordinamento dei mini-batch vari a ogni epoca per evitare bias di campionamento.
    • Divisione in Mini-batch: L’insieme di addestramento viene suddiviso in lotti di \(32\) campioni (tam_lote = 32).
    • Azzera i Gradient (otimizzatore.zero_grad()): Pulisce i gradienti accumulati nel tensor nell’iterazione precedente, evitando la somma indesiderata di derivate tra lotti distinti.
    • Passo in Avanti e Perdita: Il forward pass calcola le previsioni saida, e la chiamata criterio(saida, y_treino_t[idx]) quantifica l’errore del lotto.
    • Retropropagazione (perda.backward()): Applica la regola della catena per calcolare le derivate parziali della perdita rispetto a ciascun parametro (\(\frac{\partial L}{\partial w}\)).
    • Aggiornamento dei Pesi (otimizzatore.step()): Aggiorna i parametri del modello secondo le equazioni dell’ottimizzatore Adam.
  2. Fase di Valutazione (modello_cnn.eval()): Al termine di ogni epoca, il modello viene portato in modalità di valutazione. Il contesto with torch.no_grad() disattiva temporaneamente il motore di calcolo automatico delle derivate (autograd), riducendo il consumo di memoria e accelerando l’inferenza sull’insieme di test (X_teste_t). L’operazione .argmax(dim=1) estrae la classe di maggiore probabilità per ciascun campione, consentendo di calcolare l’accuratezza sul test.

  3. Visualizzazione con la Libreria morph: La funzione mm.showTrainCurves della libreria didattica morph consolida lo storico della perdita di addestramento e l’accuratezza sul test in un unico pannello grafico, permettendo di diagnosticare la convergenza del modello e monitorare la stabilità dell’apprendimento lungo le epoche.

# 4. Ciclo di Training (Mini-batch SGD)
n = X_treino_t.size(0)                    # Numero di campioni
tam_lote = 32                             # Dimensione del mini-batch
epocas = 50                               # Totale epoche
historico_perda, historico_acc = [], []   # Storico delle metriche

for epoca in range(epocas):                  # Ripete per epoca
    modelo_cnn.train()                       # Modalità training
    perm = torch.randperm(n)                 # Mescola i campioni
    perda_epoca = 0.0                        # Accumula perdite
    for i in range(0, n, tam_lote):          # Scorre i mini-batch
        idx = perm[i:i + tam_lote]           # Indici del lotto
        otimizador.zero_grad()               # Azzera gradienti
        saida = modelo_cnn(X_treino_t[idx])  # Propagazione diretta
        perda = criterio(saida, y_treino_t[idx]) # Calcola perdita
        perda.backward()                         # Retropropagazione
        otimizador.step()                        # Aggiorna pesi
        perda_epoca += perda.item() * len(idx)   # Somma perdita

    # Valutazione del modello sul set di test alla fine di ogni epoca
    modelo_cnn.eval()                            # Modalità valutazione
    with torch.no_grad():                        # Senza gradienti
        pred_teste = modelo_cnn(X_teste_t).argmax(dim=1)  # Predizioni
        acc_teste = (pred_teste == y_teste_t).float().mean().item()  # Accuratezza
    historico_perda.append(perda_epoca / n)      # Registra perdita
    historico_acc.append(acc_teste)              # Registra accuratezza

acc_final_cnn = historico_acc[-1]                # Ultima accuratezza
print(f"Accuratezza finale della CNN sul set di test: {acc_final_cnn:.4f}")  # Mostra risultato

final = mm.showTrainCurves(                      # Traccia curve
    historico_perda, historico_acc,
    titulo="Evolução do Treinamento da CNN — Base de Dígitos",
    subtitulo=f"Acurácia final no teste: {acc_final_cnn:.4f}",
)
Accuratezza finale della CNN sul set di test: 0.9759
Figura 9.15: Curve di training e valutazione della CNN sul dataset di cifre: evoluzione della perdita di entropia incrociata sul set di training e dell’accuratezza sul set di test nel corso di 50 epoche.
9.5.1.1.5 Bloco 5: Visualizzazione del Flusso di Attivazioni

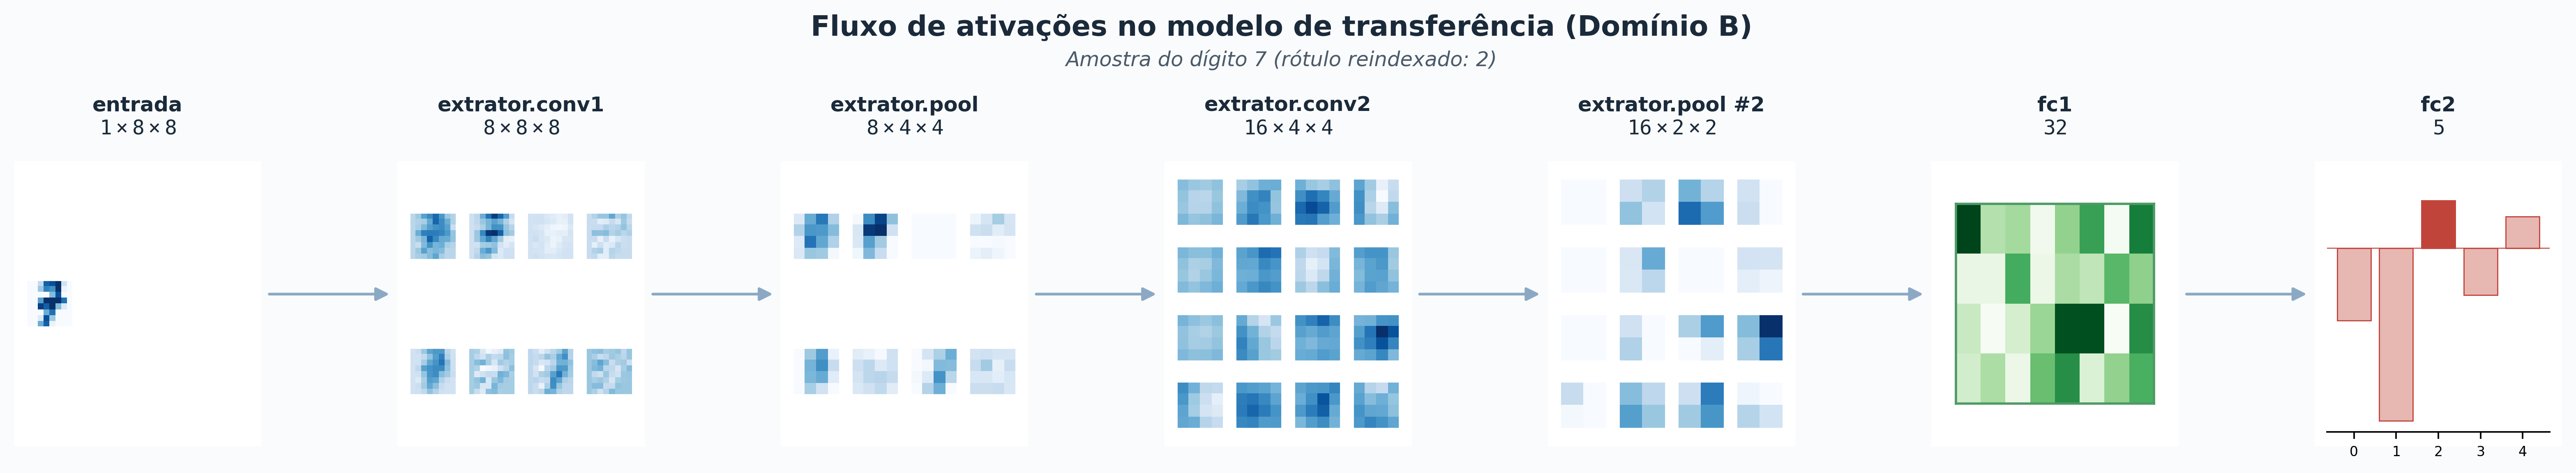
L’ispezione della rete addestrata consente di osservare la trasformazione progressiva del tensor di ingresso attraverso i livelli dell’architettura CNNDigitos. La Figura 9.16 illustra le dimensioni e le attivazioni intermedie ottenute elaborando un esempio reale della cifra \(3\).

  1. Selezione e Preparazione del Campione: Il seme stocastico viene fissato con torch.manual_seed(7) per garantire la riproducibilità dei risultati. La prima occorrenza della cifra \(3\) nel dataset load_digits viene isolata, normalizzata nell’intervallo \([0.0, 1.0]\) e riconfigurata come un tensor x di dimensione \((1, 1, 8, 8)\).

  2. Ispezione Intermedia con mm.showNet: La funzione mm.showNet della libreria morph esegue la propagazione in avanti (forward pass) del tensor x nell’istanza modelo_cnn precedentemente addestrata. Utilizzando hook di forward, la funzione intercetta lo stato numerico delle attivazioni nei livelli convoluzionali (nn.Conv2d), di pooling (nn.MaxPool2d) e completamente connessi (nn.Linear), restituendoli nel dizionario acts. Le funzioni di attivazione non lineare (nn.ReLU) non vengono registrate come stadi indipendenti, poiché la loro applicazione avviene direttamente sul tensor di uscita del livello corrispondente.

  3. Verifica dei Risultati: L’istruzione list(acts.keys()) visualizza la sequenza degli identificatori dei livelli monitorati, consentendo di confermare la riduzione dimensionale progressiva e la generazione del logit di valore massimo nell’indice corrispondente alla classe \(3\), come dimostrato nella Figura 9.16.

torch.manual_seed(7)
digits = load_digits()
idx = np.where(digits.target == 3)[0][0]
img = digits.images[idx] / 16.0
x = torch.tensor(img, dtype=torch.float32).view(1, 1, 8, 8)

# Riutilizzo dell'istanza del modello precedentemente addestrata
acts = mm.showNet(
    modelo_cnn,
    x,
    titulo="Fluxo de transformações dos tensors ao longo da arquitetura CNNDigitos",
    subtitulo=f"Exemplo real do dataset load_digits (classe verdadeira: {digits.target[idx]})",
)
print("Livelli catturati:", list(acts.keys()))
Figura 9.16: Flusso di attivazioni della CNN addestrata durante l’elaborazione di un esempio reale della cifra 3, dal dataset load_digits: dimensioni dei tensori strato per strato, dall’input al logit di output.
Livelli catturati: ['conv1', 'pool', 'conv2', 'pool #2', 'fc1', 'fc2']
9.5.1.1.6 Ispezionando il Grafo Computazionale con torchviz

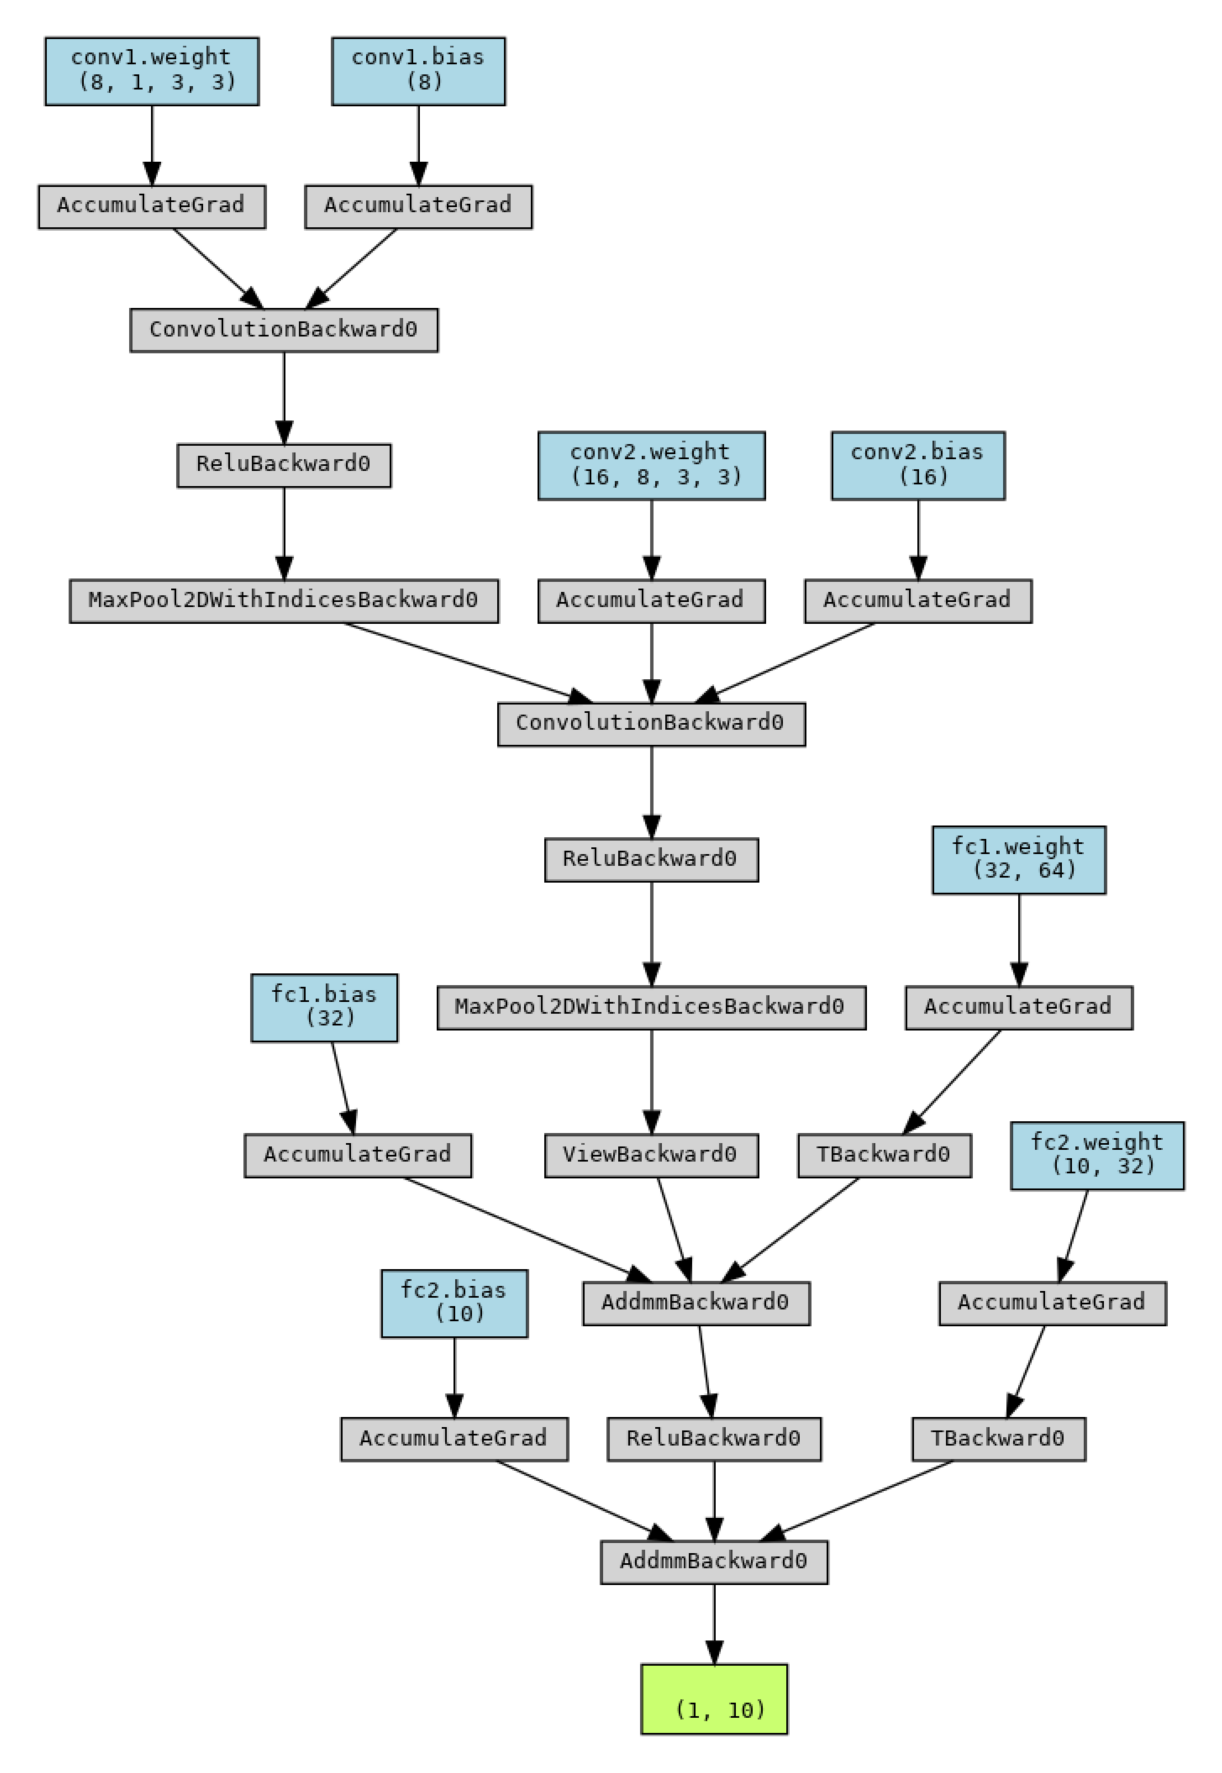
Mentre mm.showNet privilegia la chiarezza didattica — mostrando una colonna per livello con parametri addestrabili —, la libreria torchviz proietta il grafo di autograd esattamente come PyTorch lo costruisce internamente per il calcolo dei gradienti. La Figura 9.17 illustra questa prospettiva rappresentando l’architettura CNNDigitos.

  1. Propagazione in Avanti Tracciata: Con il modello addestrato in modalità eval(), il forward pass sul tensor x della cifra \(3\) è sufficiente affinché il motore di autograd registri tutte le operazioni eseguite, incluse quelle senza parametri addestrabili, come la funzione di attivazione ReLU e la riconfigurazione dimensionale view.

  2. Generazione del Grafo (make_dot): La funzione make_dot(saida, params=...) costruisce il grafo a partire dal tensor di uscita, percorrendo retroattivamente la cronologia delle operazioni fino ai nodi foglia (i parametri addestrabili del modello). Ogni nodo del diagramma rappresenta un’operazione del backward pass (come ReluBackward o AddmmBackward), e non solo un blocco concettuale del nn.Module.

  3. Esportazione e Renderizzazione (.render): Il metodo .render(..., format="png", cleanup=True) richiama l’eseguibile dot di Graphviz per compilare l’immagine in formato PNG, eliminando automaticamente i file intermedi del codice sorgente.

La Figura 9.17 evidenzia come questo grafo computazionale, anche per un’architettura compatta, presenti una densità maggiore rispetto al pannello di mm.showNet, poiché dettaglia ogni operazione atomica responsabile del flusso dei gradienti.

# 1. Forward pass con tracciamento del gradiente abilitato
modelo_cnn.eval()
saida = modelo_cnn(x)  # Riutilizzo del tensore x (cifra 3)

# 2. Grafo di base: flusso delle operazioni fino all'uscita
grafo_simples = make_dot(saida, params=dict(modelo_cnn.named_parameters()))
caminho_simples = grafo_simples.render("cnn_digitos_grafo_simples", format="png", cleanup=True)

# 3. Visualizzazione diretta nell'ambiente Quarto/Jupyter
# Il .render() restituisce il percorso del file PNG generato; dobbiamo aprirlo come immagine
imagem_simples = np.array(Image.open(caminho_simples).convert("RGB"))
mm.show(imagem_simples, figsize=(5,10))
Figura 9.17: Grafo computacional della CNNDigitos generato tramite torchviz, che mostra le operazioni di forward e i nodi di gradiente (backward) associati a ciascun parametro addestrabile.
9.5.1.1.7 Visão Dettagliata del Grafo Computazionale con torchviz

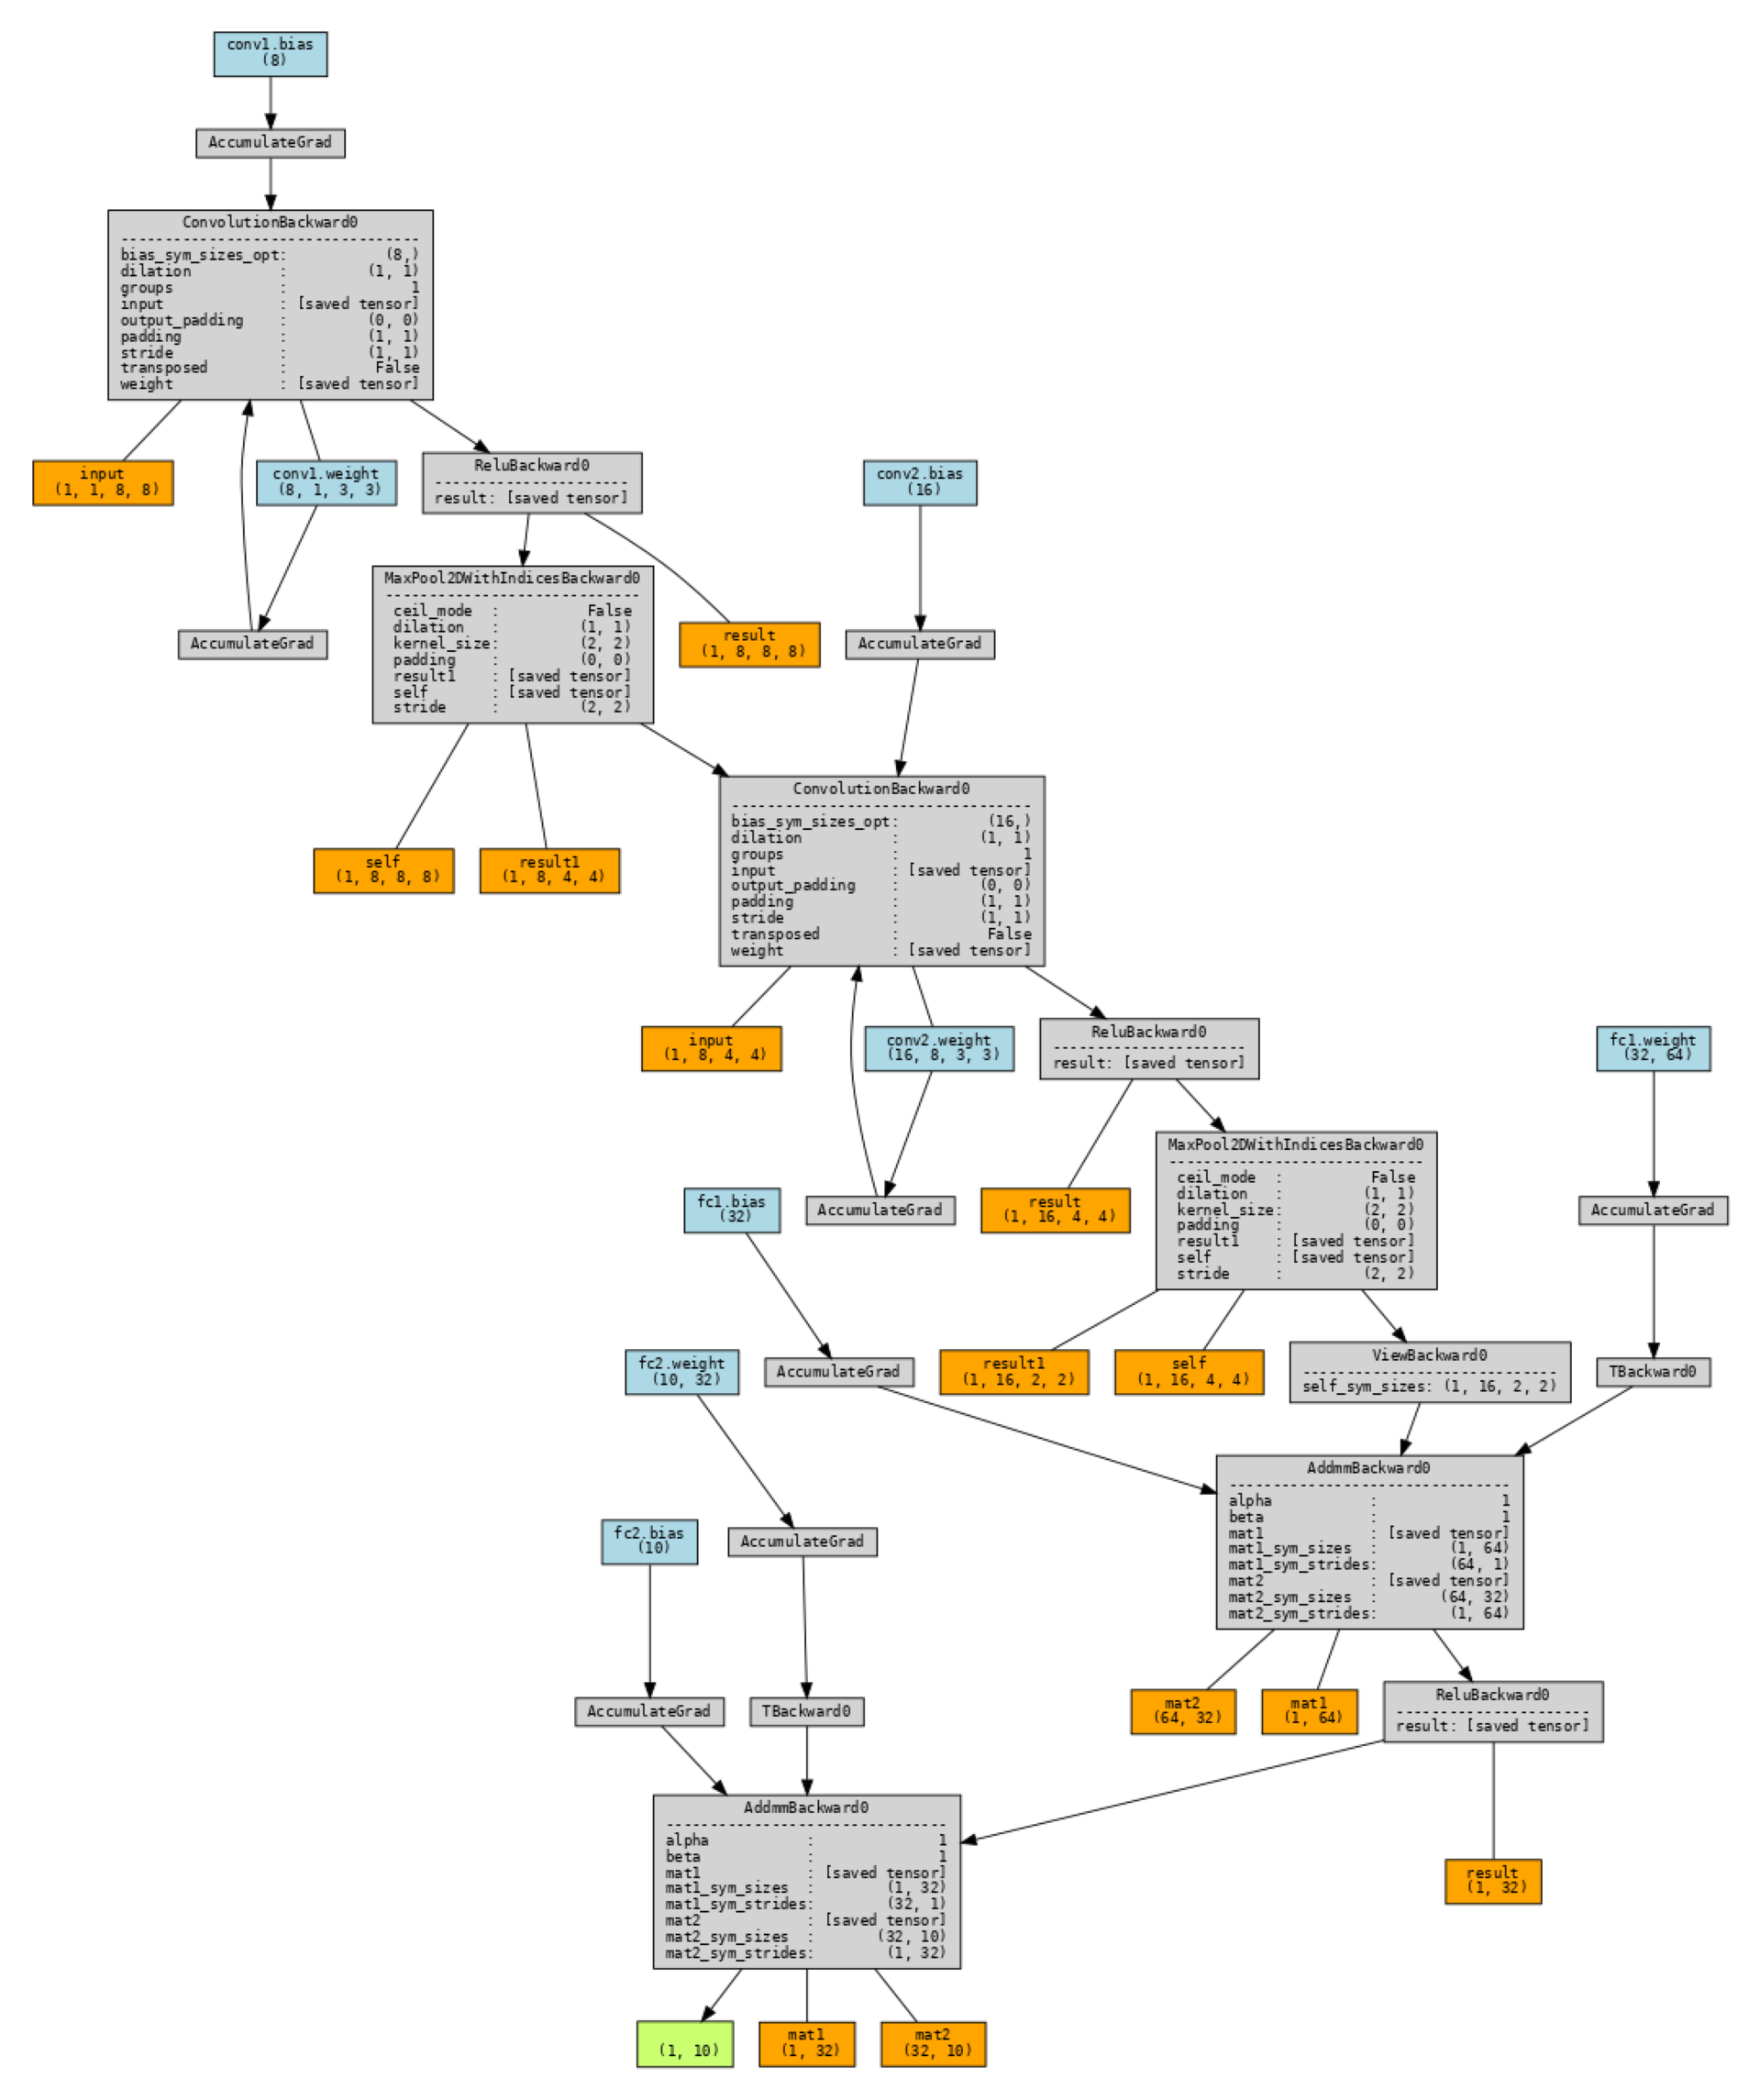
Oltre alla rappresentazione semplificata, la libreria torchviz consente di espandere il grafo di autograd per ispezionare i dettagli interni dell’esecuzione della rete CNNDigitos. La Figura 9.18 presenta questa struttura espansa per lo stesso tensor di input x.

  1. Tracciamento con Attributi di Operazione (show_attrs=True): L’inclusione degli attributi visualizza le configurazioni iperparametriche associate a ciascun nodo computazionale durante la propagazione in avanti (forward pass), come le dimensioni del kernel (kernel_size), i passi (stride) e i riempimenti (padding) nelle convoluzioni e nei sottocampionamenti.

  2. Rilevamento dei Tensor Salvati in Memoria (show_saved=True): Il parametro forza la visualizzazione esplicita dei tensor intermedi che PyTorch conserva in memoria durante il forward pass. Questi dati vengono preservati perché saranno strettamente necessari per il calcolo delle derivate parziali durante la fase di retropropagazione (backward pass).

  3. Generazione e Compilazione dei Grafi: Mentre grafo_simples genera una visione diretta del flusso dei gradienti, grafo_dettagliato compila il grafo espanso nel file cnn_digitos_grafo_detalhado.png tramite l’eseguibile dot di Graphviz.

Come osservato nella Figura 9.18, questa visualizzazione minuziosa è utile per eseguire il debug del consumo di memoria video (VRAM) e per verificare come il motore di PyTorch allochi internamente ciascun nodo della regola della catena.

# stesso codice precedente (make_dot + render)...

# 2. Grafo dettagliato: visualizzazione delle dimensioni e dei tensori salvati per la retropropagazione
grafo_detalhado = make_dot(
    saida,
    params=dict(modelo_cnn.named_parameters()),
    show_attrs=True,   # Mostra gli attributi delle operazioni (es.: kernel_size, stride)
    show_saved=True,   # Mostra i tensori salvati in memoria per la retropropagazione
)

caminho_detalhado = grafo_detalhado.render("cnn_digitos_grafo_detalhado", 
                                           format="png", cleanup=True)

# 3. Visualizzazione diretta nell'ambiente Quarto/Jupyter
imagem_detalhado = np.array(Image.open(caminho_detalhado).convert("RGB"))
mm.show(imagem_detalhado, figsize=(8, 16))
Figura 9.18: Grafo dettagliato della classe CNNDigiti generato tramite torchviz.
9.5.1.1.8 Confronto con il Capitolo 7

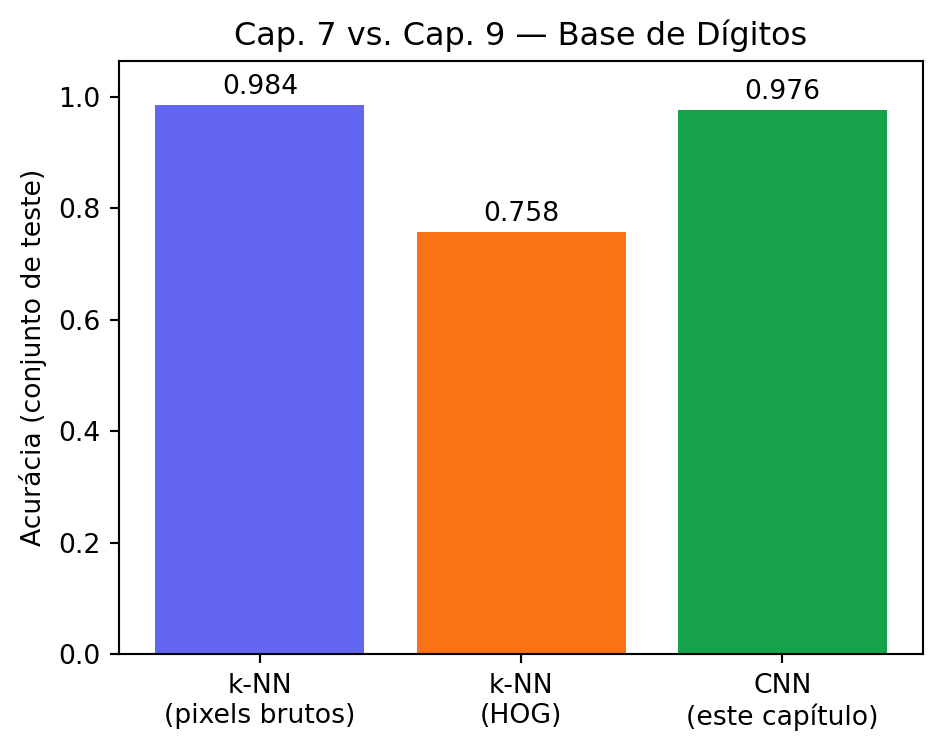
La Figura 9.19 riunisce i risultati ottenuti sullo stesso insieme di dati (load_digits), stabilendo un parallelo diretto tra gli approcci classici esplorati in precedenza e la CNN sviluppata in questo capitolo.

  1. Prestazioni dei Pixel Grezzi vs. Descrittori Manuali: Negli esperimenti del Capitolo 7, il classificatore \(k\text{-NN}\) (\(k=3\)) ha raggiunto un’accuratezza del \(98,4\%\) quando alimentato direttamente con i pixel grezzi delle immagini. Al contrario, l’estrazione preventiva delle caratteristiche tramite Histogram of Oriented Gradients (HOG) ha prodotto prestazioni significativamente inferiori (\(75,8\%\)). Questo calo si verifica perché il HOG è stato concepito per catturare i gradienti dei bordi in immagini a risoluzione più elevata; in matrici di soli \(8 \times 8\) pixel, la risoluzione spaziale è insufficiente per formare istogrammi di orientamento informativi.

  2. Equivalenza della CNN e Apprendimento End-to-End: La rete convoluzionale CNNDigitos raggiunge prestazioni competitive del \(97,6\%\), avvicinandosi all’accuratezza del \(k\text{-NN}\) con pixel grezzi su una base piccola e pre-allineata. Il grande vantaggio concettuale risiede nell’apprendimento della rappresentazione: invece di dipendere da descrittori progettati manualmente (handcrafted features) o di mantenere l’intero insieme di dati in memoria per la ricerca dei vicini al momento dell’inferenza, la CNN ottimizza automaticamente i propri filtri convoluzionali durante l’addestramento, generando un modello compatto in grado di eseguire l’estrazione delle caratteristiche e la classificazione in modo integrato (end-to-end).

import matplotlib.pyplot as plt

# Valori ottenuti nel Capitolo 7 (k-NN, k=3), riprodotti per confronto diretto
ACC_KNN_PIXELS_CAP7 = 0.9844
ACC_KNN_HOG_CAP7 = 0.7578

metodos = ["k-NN\n(pixels brutos)", "k-NN\n(HOG)", "CNN\n(este capítulo)"]
acuracias = [ACC_KNN_PIXELS_CAP7, ACC_KNN_HOG_CAP7, acc_final_cnn]

plt.figure(figsize=(5, 4))
cores = ["#6366f1", "#f97316", "#16a34a"]
plt.bar(metodos, acuracias, color=cores)
plt.ylim(0, max(acuracias) + 0.08)
plt.ylabel("Acurácia (conjunto de teste)")
plt.title("Cap. 7 vs. Cap. 9 — Base de Dígitos")

for i, v in enumerate(acuracias):
    plt.text(i, v + 0.02, f"{v:.3f}", ha="center")

plt.tight_layout()
plt.show()
Figura 9.19: Confronto di accuratezza tra i classificatori classici del Capitolo 7 (pixel grezzi e HOG con k-NN) e la CNN addestrata in questo capitolo, sulla stessa base di cifre.
Nota🧠 Perché funziona? — E perché la CNN non “vince” sempre

Il risultato osservato qui ripete il pattern già visto nel Capitolo 7: la CNN, pur imparando automaticamente le proprie caratteristiche, non supera necessariamente il \(k\text{-NN}\) con pixel grezzi in questa specifica base. La spiegazione è la stessa: load_digits è una base piccola (meno di \(1.800\) esempi), con immagini già centralizzate, normalizzate e a bassissima risoluzione (\(8 \times 8\)) — condizioni in cui il confronto diretto delle intensità è già altamente informativo, e ci sono pochi dati perché la rete impari filtri realmente superiori ai descrittori semplici.

Il vero valore distintivo delle CNN emerge in scenari che descrittori artigianali e classificatori semplici non riescono ad affrontare: immagini più grandi e più realistiche, con migliaia di categorie, variazione sostanziale di posa, illuminazione e sfondo, e insiemi di addestramento massicci — esattamente il regime in cui i modelli presentati nella sezione “Applicazioni su Larga Scala”, più avanti, sono stati addestrati. La lezione pedagogica che attraversa i Capitoli 7, 8 e 9 di questo libro è coerente: la sofisticazione di un metodo deve essere proporzionale alla complessità del problema — usare una CNN per un problema che un \(k\text{-NN}\) risolve ugualmente bene è uno spreco di risorse computazionali, non una virtù.

Questa stessa proporzionalità vale per gli strumenti di ispezione usati lungo il capitolo. Il mm.showNet è stato costruito per scopi didattici e funziona bene in reti poco profonde come la CNNDigitos, ma non scala a architetture profonde: ogni strato tracciato diventa una colonna nella figura, e gli strati convoluzionali con centinaia di canali generano mosaici troppo grandi per un’interpretazione visiva; inoltre, gli hook memorizzano tutte le attivazioni in memoria, e il layout assume un flusso sequenziale, non rappresentando fedelmente connessioni residue o ramificazioni (come in ResNet o moduli Inception). Pertanto, showNet deve essere inteso come una lente pedagogica per reti piccole — analoga al ruolo di mm.showBoundBox nel debug visivo delle rilevazioni — e non come sostituto di strumenti orientati alla produzione, come TensorBoard o torchviz.

9.5.1.2 Apprendimento per Trasferimento

Addestrare una CNN da zero richiede generalmente una grande quantità di dati etichettati e notevoli risorse computazionali, poiché il processo di addestramento deve regolare tutti i parametri della rete. In molte applicazioni, tuttavia, è disponibile solo un insieme ridotto di dati per il compito di interesse. In questa situazione, l’apprendimento per trasferimento (transfer learning) riutilizza le rappresentazioni apprese da un modello precedentemente addestrato su un compito sorgente con un grande volume di dati, riducendo il costo di addestramento e la necessità di nuovi campioni.

Nella visione artificiale, questa strategia sfrutta l’organizzazione gerarchica delle CNN. I livelli iniziali apprendono caratteristiche visive di basso livello, come bordi, texture, gradienti di intensità e pattern di colore, che rimangono utili in diversi domini. I livelli più profondi combinano queste informazioni per formare rappresentazioni progressivamente più astratte e specializzate, legate alle classi presenti nel database di addestramento.

Questa sezione indaga in quali condizioni l’apprendimento per trasferimento produce buoni risultati. Il primo esperimento mostra che un estrattore piccolo, addestrato su un dominio ristretto, può condurre a un trasferimento negativo (negative transfer). Il secondo dimostra perché modelli profondi pre-addestrati su grandi basi di immagini raggiungono elevate prestazioni in nuovi compiti. Infine, il terzo applica questa strategia a un problema di diagnosi fitosanitaria, illustrando uno scenario vicino alle applicazioni reali.

9.5.1.2.1 Esperimento 1 — Limiti di un Estrattore Piccolo e Specializzato

Il primo esperimento mostra che il trasferimento dell’apprendimento non sempre migliora le prestazioni di un modello. A tale scopo, il set di cifre scritte a mano (load_digits) viene suddiviso in due domini disgiunti:

  • Dominio A (origine): cifre da \(0\) a \(4\), utilizzate per addestrare una piccola CNN;
  • Dominio B (destinazione): cifre da \(5\) a \(9\), rietichettate da \(0\) a \(4\), formando un nuovo compito con solo \(20\) campioni di addestramento.

L’obiettivo consiste nel valutare l’effetto del riutilizzo dell’estrattore di caratteristiche appreso nel Dominio A senza consentirne l’adattamento al Dominio B.

9.5.1.2.1.1 Bloco 1: Divisione dei Domini, Scarsità e Visualizzazione dei Campioni

Questo blocco prepara il dataset per l’esperimento. Diversamente dal progetto precedente, che utilizzava tutte le cifre in un unico problema di classificazione, la base è suddivisa in due compiti indipendenti: un compito di origine (Dominio A) e un compito di destinazione (Dominio B).

La Figura 9.20 presenta esempi dei due domini dopo la separazione delle classi, la conversione in tensor di PyTorch e il pre-processing.

  1. Separazione delle classi: Le maschere booleane mask_A e mask_B separano gli esempi di ciascun dominio. Successivamente, il codice rietichetta i target del Dominio B (y[mask_B] - 5) nell’intervallo $[0,4]`, consentendo a entrambi i modelli di utilizzare cinque classi di output.

  2. Scarsità dei dati: Il generatore np.random.default_rng(0) seleziona solo \(20\) campioni per l’addestramento del Dominio B, circa quattro per classe, simulando uno scenario in cui l’addestramento da zero tende a soffrire di overfitting.

  3. Conversione in tensor: La funzione para_tensor converte le immagini nel formato \((N,1,8,8)\) e i target in torch.long, compatibili con i layer nn.Conv2d e la funzione di loss.

  4. Visualizzazione dei campioni: Il codice utilizza .squeeze().numpy() per convertire i tensor in array NumPy. La Figura 9.20 presenta esempi dei due domini ed evidenzia la rietichettatura applicata ai target del Dominio B.

# 1. Divisione del dataset in due domini disgiunti
classes_A, classes_B = [0, 1, 2, 3, 4], [5, 6, 7, 8, 9]
mask_A, mask_B = np.isin(y, classes_A), np.isin(y, classes_B)

XA, yA = X[mask_A], y[mask_A]
XB, yB = X[mask_B], y[mask_B] - 5  # Reindicizzazione delle etichette nell'intervallo [0, 4]

# Divisione in addestramento e test per entrambi i domini
XA_tr, XA_te, yA_tr, yA_te = train_test_split(
    XA, yA, test_size=0.25, random_state=42, stratify=yA
)
XB_tr, XB_te, yB_tr, yB_te = train_test_split(
    XB, yB, test_size=0.25, random_state=42, stratify=yB
)

# Simulazione di estrema scarsità nel dominio di destinazione: solo 20 campioni di addestramento
rng = np.random.default_rng(0)
idx_poucos = rng.choice(len(XB_tr), size=20, replace=False)
XB_tr_poucos, yB_tr_poucos = XB_tr[idx_poucos], yB_tr[idx_poucos]

# Funzione ausiliaria per la conversione in tensori PyTorch
def para_tensor(Ximg, yarr):
    return torch.tensor(Ximg).unsqueeze(1), torch.tensor(yarr, dtype=torch.long)

XA_tr_t, yA_tr_t = para_tensor(XA_tr, yA_tr)
XA_te_t, yA_te_t = para_tensor(XA_te, yA_te)
XB_tr_t, yB_tr_t = para_tensor(XB_tr_poucos, yB_tr_poucos)
XB_te_t, yB_te_t = para_tensor(XB_te, yB_te)

# Visualizzazione di campioni di entrambi i domini
n_amostras = 5
imgs_A = [img.squeeze().numpy() for img in XA_tr_t[:n_amostras]]
titles_A = [f"A: {label.item()}" for label in yA_tr_t[:n_amostras]]

imgs_B = [img.squeeze().numpy() for img in XB_tr_t[:n_amostras]]
titles_B = [f"B: {label.item()} (orig: {label.item()+5})" for label in yB_tr_t[:n_amostras]]

mm.show(
    imgs_A + imgs_B,
    titles=titles_A + titles_B,
    cols=n_amostras,
    figsize=(12, 4.5)
)
Figura 9.20: Campioni dei set di addestramento dopo il preprocessamento e l’adattamento dimensionale ai tensori PyTorch: Dominio A (cifre da 0 a 4, compito di origine) e Dominio B (cifre da 5 a 9 reindicizzate da 0 a 4, compito di destinazione).
9.5.1.2.1.2 Blocco 2: Architettura Modulare e Routine Generiche

Per consentire il trasferimento dell’apprendimento, l’architettura convoluzionale e il ciclo di addestramento sono stati rifattorizzati rispetto alla classe CNNDigitos del progetto precedente.

  1. Modularizzazione dell’Architettura (Differenza rispetto a CNNDigitos):

    • Nel progetto precedente, la classe CNNDigitos dichiarava tutti i layer (conv1, conv2, pool, fc1, fc2) come membri diretti di un’unica classe monolitica.
    • Qui, l’architettura è separata in due componenti: la classe ExtratorConv incapsula il blocco spaziale convoluzionale (\(2\) convoluzioni \(3 \times 3\), \(2\) Max-Pooling \(2 \times 2\) e l’appiattimento a \(64\) elementi), mentre la classe CNNCompleta istanzia questo estrattore in self.extrator e vi aggiunge la “testa” classificatrice (fc1 e fc2).
    • Questa separazione è ciò che consente di copiare lo stato interno dell’estrattore (state_dict()) da un modello all’altro in modo isolato.
  2. Adeguamento del Numero di Classi di Uscita: Mentre CNNDigitos nel progetto precedente possedeva \(10\) logit nel layer di uscita (self.fc2 = nn.Linear(32, 10)), la classe CNNCompleta riceve n_classes=5 nel costruttore per adattarsi alla suddivisione dei domini \(A\) e \(B\).

  3. Flessibilizzazione del Ciclo di Addestramento (treinar):

    • Nel progetto precedente, il ciclo di addestramento iterava direttamente sugli attributi globali del modello (modelo_cnn.parameters()) e calcolava metriche specifiche in linea.
    • La funzione treinar astrae questo processo e introduce il parametro opzionale parametros. Se fornito, l’ottimizzatore Adam aggiorna solo i parametri di questa lista, ignorando i layer i cui gradienti sono stati disattivati. Questa flessibilità è cruciale per eseguire l’addestramento con congelamento parziale della rete.
  4. Isolamento della Valutazione (calcular_acuracia): Come nella fase di test del progetto precedente, la funzione pone il modello in eval() e utilizza il contesto torch.no_grad() per disattivare autograd, calcolando l’accuratezza tramite .argmax(dim=1).

# Definizione del blocco convoluzionale riutilizzabile (stessa estrazione del progetto precedente)
class ExtratorConv(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 8, 3, padding=1)
        self.conv2 = nn.Conv2d(8, 16, 3, padding=1)
        self.pool = nn.MaxPool2d(2, 2)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.pool(self.relu(self.conv1(x)))
        x = self.pool(self.relu(self.conv2(x)))
        return x.view(x.size(0), -1)

# Architettura modulare che combina l'estrattore e la testa classificatrice
class CNNCompleta(nn.Module):
    def __init__(self, n_classes=5):
        super().__init__()
        self.extrator = ExtratorConv()
        self.fc1 = nn.Linear(64, 32)
        self.fc2 = nn.Linear(32, n_classes)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.extrator(x)
        x = self.relu(self.fc1(x))
        return self.fc2(x)

# Routine generica di addestramento con ottimizzazione selettiva dei parametri
def treinar(modelo, X_t, y_t, epocas, lr, tam_lote=16, parametros=None):
    # Parametri addestrabili
    params = parametros if parametros is not None else modelo.parameters()  
    otim = optim.Adam(params, lr=lr)               # Ottimizzatore Adam
    crit = nn.CrossEntropyLoss()                   # Funzione di perdita
    n_amostras = X_t.size(0)                       # Numero di campioni
    for _ in range(epocas):                        # Ripeti per epoca
        perm = torch.randperm(n_amostras)          # Mescola i campioni
        for i in range(0, n_amostras, tam_lote):   # Scorri mini-batch
            idx = perm[i:i + tam_lote]             # Indici del lotto
            otim.zero_grad()                       # Azzera i gradienti
            perda = crit(modelo(X_t[idx]), y_t[idx])  # Calcola la perdita
            perda.backward()                       # Retropropagazione
            otim.step()                            # Aggiorna i pesi

# Routine di valutazione
def calcular_acuracia(modelo, X_t, y_t):
    modelo.eval()                                  # Modalità di valutazione
    with torch.no_grad():                          # Senza gradienti
        pred = modelo(X_t).argmax(dim=1)           # Classi predette
    return (pred == y_t).float().mean().item()     # Restituisce l'accuratezza
9.5.1.2.1.3 Bloco 3: Pre-addestramento, Trasferimento e Analisi Comparativa

Questo blocco esegue il confronto tra l’addestramento del modello da zero e l’applicazione del trasferimento con il congelamento statico dell’estrattore. Per garantire piena trasparenza all’esperimento, le dimensioni dei set di addestramento e test di entrambi i domini vengono stampate sul terminale.

  1. Quantificazione dei Campioni per Dominio:

    • Dominio A (origine, cifre \(0\) a \(4\)): Dispone di \(675\) campioni di addestramento (\(75\%\)) e \(226\) di test (\(25\%\)), fornendo dati abbondanti affinché il modello_origine apprenda l’estrattore convoluzionale fino a raggiungere il \(100\%\) di accuratezza.
    • Dominio B (destinazione, cifre \(5\) a \(9\)): Possiede \(224\) campioni di test in totale, ma il suo set di addestramento è intenzionalmente ridotto da \(672\) a soli \(20\) campioni (XB_tr_poucos), creando uno scenario severo di scarsità di dati.
  2. Fase 1: Pre-addestramento nel Dominio A (Origine): Il modello_origine viene addestrato da zero sui \(675\) campioni delle cifre \(0\) a \(4\). Durante \(40\) epoche, l’estrattore convoluzionale regola i suoi filtri per identificare le caratteristiche distintive di queste prime cinque cifre, raggiungendo il \(100\%\) di accuratezza sul set di test (\(226\) campioni).

  3. Fase 2: Trasferimento dei Pesi e Congelamento:

    • Viene creato il modello_trasferimento per risolvere il compito del Dominio B (cifre \(5\) a \(9\)).

    • I pesi appresi nel Dominio A vengono copiati tramite:

      • load_state_dict(modello_origine.estrattore.state_dict())
    • Congelamento: Il ciclo for p in modello_trasferimento.estrattore.parameters(): p.requires_grad = False disattiva il calcolo dei gradienti nei layer convoluzionali.

    • Addestramento Selettivo: La chiamata treinar(...) passa strettamente i parametri dei layer densi (params_cabeca), regolando la testa di classificazione con soli \(20\) campioni di addestramento.

  4. Fase 3: Addestramento da Zero nel Dominio B (Controllo Sperimentale): Il modello_da_zero possiede la stessa architettura, ma viene addestrato da zero sugli stessi \(20\) campioni del Dominio B, senza alcun riutilizzo di pesi, per le stesse \(40\) epoche.

  5. Analisi dei Risultati (Figura 9.21):

    • Con Trasferimento Congelato (\(72,77\%\)): Riutilizzando l’estrattore addestrato nel Dominio A e congelando i suoi parametri, la rete raggiunge il \(72,77\%\) di accuratezza sul test (\(224\) campioni) regolando solo i layer densi.
    • Addestrato da Zero (\(76,79\%\)): L’addestramento da zero supera il trasferimento congelato sul set di test del Dominio B.
    • Causa della Differenza: Trattandosi di un modello minuscolo (solo \(16\) filtri convoluzionali in matrici di \(8 \times 8\)), l’estrattore addestrato nel Dominio A è diventato iper-specializzato nelle forme geometriche delle cifre \(0\) a \(4\). Congelando rigidamente questi pochi filtri, il modello di destinazione è rimasto limitato a rilevatori inadeguati per le cifre \(5\) a \(9\). La rete addestrata da zero, anche con soli \(20\) campioni, è riuscita ad adattare i suoi \(16\) filtri direttamente ai tratti del Dominio B.
# Fixar semente para reprodutibilidade
torch.manual_seed(42)

# Exibição do tamanho dos grupos de treino e teste
print("=== Detalhamento do Tamanho das Bases ===")
print(f"Domínio A (0-4) — Treino: {len(XA_tr_t)} amostras | Teste: {len(XA_te_t)} amostras")
print(f"Domínio B (5-9) — Treino completo: {len(XB_tr)} | Treino reduzido: {len(XB_tr_poucos)}",
      f"| Teste: {len(XB_te_t)} amostras\n")

# 1. Pré-treinamento na tarefa de origem (Domínio A: dígitos 0-4)
modelo_origem = CNNCompleta(n_classes=5)                       # Cria CNN

#######
treinar(modelo_origem, XA_tr_t, yA_tr_t, epocas=40, lr=1e-2)   # Treina modelo
         
acc_A = calcular_acuracia(modelo_origem, XA_te_t, yA_te_t)     # Mede acurácia
                          
print(f"Acurácia no domínio de origem A "                      # Exibe resultado
      f"(dígitos 0-4, {len(XA_te_t)} testes): " f"{acc_A:.4f}")

# 2. Transferência de Aprendizado (Extrator Congelado)
modelo_transferencia = CNNCompleta(n_classes=5)        # Cria CNN
modelo_transferencia.extrator.load_state_dict(         # Copia extrator
    modelo_origem.extrator.state_dict())

for p in modelo_transferencia.extrator.parameters():   # Percorre extrator
    p.requires_grad = False                            # Congela pesos

params_cabeca = list(modelo_transferencia.fc1.parameters())  # FC1
params_cabeca += list(modelo_transferencia.fc2.parameters()) # +FC2

#######
treinar(modelo_transferencia, XB_tr_t, yB_tr_t,              # Treina cabeça
         epocas=40, lr=1e-2, parametros=params_cabeca)

acc_transferencia = calcular_acuracia(modelo_transferencia, XB_te_t, yB_te_t) # Mede acurácia

# 3. Treinamento do Zero no Domínio B
modelo_do_zero = CNNCompleta(n_classes=5)                     # Cria CNN

#######
treinar(modelo_do_zero, XB_tr_t, yB_tr_t, epocas=40, lr=1e-2) # Treina modelo
         
acc_do_zero = calcular_acuracia(modelo_do_zero,  XB_te_t, yB_te_t) # Mede acurácia
                               

print(f"Domínio de destino B (dígitos 5-9), apenas {len(XB_tr_poucos)} ", 
      f"exemplos de treino ({len(XB_te_t)} testes):")
print(f"  Com transferência (extrator congelado): {acc_transferencia:.4f}")
print(f"  Treinando do zero (mesmos dados/épocas): {acc_do_zero:.4f}")

# Visualização comparativa
plt.figure(figsize=(4.5, 4))
plt.bar(["Do zero", "Transferência"], [acc_do_zero, acc_transferencia], 
        color=["#dc2626", "#16a34a"])
plt.ylim(0, max([acc_do_zero, acc_transferencia]) + 0.1)
plt.ylabel("Acurácia no domínio B (teste)")
plt.title(f"Efeito da Transferência ({len(XB_tr_poucos)} exemplos de treino)")

for i, v in enumerate([acc_do_zero, acc_transferencia]):
    plt.text(i, v + 0.02, f"{v:.3f}", ha="center")

plt.tight_layout()
plt.show()
=== Detalhamento do Tamanho das Bases ===
Domínio A (0-4) — Treino: 675 amostras | Teste: 226 amostras
Domínio B (5-9) — Treino completo: 672 | Treino reduzido: 20 | Teste: 224 amostras

Acurácia no domínio de origem A (dígitos 0-4, 226 testes): 1.0000
Domínio de destino B (dígitos 5-9), apenas 20  exemplos de treino (224 testes):
  Com transferência (extrator congelado): 0.7277
  Treinando do zero (mesmos dados/épocas): 0.7679
Figura 9.21: Comparação de acurácia no conjunto de teste do Domínio B (dígitos 5 a 9) sob restrição de dados (20 exemplos de treino): demonstração do impacto do congelamento rígido e da transferência negativa em redes de baixa capacidade.
9.5.1.2.1.4 Bloco 4: Visualizzazione del Flusso di Attivazioni con mm.showNet

Per confermare che l’estrazione delle caratteristiche riutilizzata preserva le trasformazioni dimensionali studiate nel progetto precedente, si utilizza nuovamente la funzione mm.showNet della libreria morph. La Figura 9.22 mostra il flusso di attivazioni del modello_transferimento durante l’elaborazione di un campione del Dominio B (cifra \(7\), reindicizzata per la classe \(2\)).

  1. Preservazione del Flusso Convoluzionale: Poiché l’architettura EstrazioneConv replica gli stessi strati di convoluzione e pooling della CNNCifre del progetto precedente, le dimensioni dei tensor intermedi rimangono in \((1, 8, 4, 4)\) nel primo blocco.
  2. Ispezione della Testa Adattata: La differenza rispetto al progetto precedente emerge nello strato di uscita (fc2): mentre il modello del progetto precedente proiettava il vettore intermedio in \(10\) logit (classi da \(0\) a \(9\)), il modello di trasferimento proietta il vettore in \(5\) logit (classi da \(0\) a \(4\)), catturando le probabilità relative del Dominio B.
# Seleziona il primo campione di test del Dominio B
x_amostra_B = XB_te_t[0:1]  # Tensore di dimensione (1, 1, 8, 8)
classe_verdadeira = yB_te_t[0].item()
classe_original = classe_verdadeira + 5

# Ispezione del flusso di attivazioni nel modello di transfer learning
acts_transfer = mm.showNet(
    modelo_transferencia,
    x_amostra_B,
    titulo="Fluxo de ativações no modelo de transferência (Domínio B)",
    subtitulo=f"Amostra do dígito {classe_original} (rótulo reindexado: {classe_verdadeira})",
)

print("Livelli catturati nel modello di transfer learning:\n", list(acts_transfer.keys()))
Figura 9.22: Flusso di attivazioni e trasformazioni dimensionali dei tensori nel modello di transfer learning durante l’elaborazione di un campione di test del Dominio B (cifra 7, reindicizzato come classe 2).
Livelli catturati nel modello di transfer learning:
 ['extrator.conv1', 'extrator.pool', 'extrator.conv2', 'extrator.pool #2', 'fc1', 'fc2']
9.5.1.2.1.5 Analisi dell’Esperimento 1

Il modello addestrato da zero raggiunge un’accuratezza superiore rispetto al modello con transfer learning ed estrattore congelato. Questo risultato caratterizza un caso di trasferimento negativo (negative transfer) e deriva da tre fattori:

  1. Bassa capacità: L’estrattore possiede solo \(16\) filtri \(3 \times 3\), insufficienti per apprendere rappresentazioni generalizzabili.

  2. Specializzazione nel dominio: L’addestramento con le cifre da \(0\) a \(4\) produce filtri poco discriminativi per le cifre da \(5\) a \(9\).

  3. Assenza di adattamento: Il congelamento impedisce all’estrattore di adattare i propri filtri al nuovo compito.

Nota💡 Provocazione Pedagogica

Questo esperimento utilizza un estrattore di piccole dimensioni addestrato su un dominio ristretto. Il risultato sarebbe diverso se l’estrattore avesse appreso le proprie rappresentazioni su una base con milioni di immagini e grande diversità di oggetti?

9.5.1.2.2 Esperimento 2 — Quando il Transfer Learning Funziona Davvero (ResNet-18 Pre-addestrata)

Il secondo esperimento replica la stessa struttura del primo — pochi esempi di addestramento, due classi, confronto tra strategie —, ma sostituisce l’estrattore artigianale di \(16\) filtri con la ResNet-18, un’architettura di \(18\) strati pre-addestrata su ImageNet (\(1,4\) milioni di immagini, \(1.000\) categorie), e il dataset sintetico di cifre con fotografie reali del Oxford-IIIT Pet Dataset (PARKHI, 2012).

Il compito: distinguere due razze canine — Carlino e Boxer — a partire da sole \(15\) fotografie di addestramento per classe.

Consiglio🐶 Perché questo scenario?

La sfida qui non è la somiglianza visiva tra le razze — Carlino e Boxer hanno corporature e proporzioni ben distinte —, bensì la scarsità di dati: solo \(30\) fotografie reali in totale, senza alcuna immagine sintetica. È il tipo di problema con budget di dati ridotto che, nella pratica, motiva l’uso di reti pre-addestrate: non c’è tempo né risorse per fotografare ed etichettare migliaia di cani prima di addestrare un classificatore da zero.

9.5.1.2.2.1 Blocco 1: Caricamento del Dataset Reale e Campionamento Sparso
  1. Fonte: il Oxford-IIIT Pet Dataset (PARKHI, 2012) viene caricato tramite torchvision.datasets.OxfordIIITPet, che scarica automaticamente le \(7.349\) fotografie e le relative etichette di razza alla prima esecuzione.
  2. Filtraggio: vengono mantenute solo le due razze di interesse (Pug, Boxer).
  3. Sparsità deliberata: vengono selezionate solo \(15\) fotografie di addestramento per classe (\(30\) in totale) — il resto costituisce il set di test, utilizzato esclusivamente per la valutazione.

La Figura 9.23 mostra campioni di addestramento di ciascuna razza.

import random

RACAS_ALVO = ["Pug", "Boxer"]
N_TREINO_POR_CLASSE = 15
N_TESTE_POR_CLASSE = 20

# 1. Download del dataset completo (37 razze) — licenza CC BY-SA 4.0
pets_completo = OxfordIIITPet(
    root="dados_pets", split="trainval", target_types="category", download=True
)
nomes_racas = pets_completo.classes
indices_alvo = [nomes_racas.index(r) for r in RACAS_ALVO]

# 2. Filtraggio delle due razze di interesse, separate per classe
por_classe = {idx: [] for idx in indices_alvo}
for img, lbl in pets_completo:
    if lbl in indices_alvo:
        por_classe[lbl].append(img)

# 3. Campionamento: poche immagini di addestramento, più immagini di test
rng = random.Random(42)
imgs_treino, y_treino, imgs_teste, y_teste = [], [], [], []
for classe_idx, idx_original in enumerate(indices_alvo):
    imgs_raca = por_classe[idx_original][:]
    rng.shuffle(imgs_raca)
    imgs_treino += imgs_raca[:N_TREINO_POR_CLASSE]
    y_treino += [classe_idx] * N_TREINO_POR_CLASSE
    imgs_teste += imgs_raca[N_TREINO_POR_CLASSE : N_TREINO_POR_CLASSE + N_TESTE_POR_CLASSE]
    y_teste += [classe_idx] * N_TESTE_POR_CLASSE

print(f"Addestramento: {len(imgs_treino)} immagini | Test: {len(imgs_teste)} immagini")

amostras_pil = imgs_treino[:4] + imgs_treino[N_TREINO_POR_CLASSE:N_TREINO_POR_CLASSE + 4]
amostras_exibicao = [np.array(img.convert("RGB")) for img in amostras_pil]  # PIL -> ndarray
titulos_exibicao = [RACAS_ALVO[0]] * 4 + [RACAS_ALVO[1]] * 4
mm.show(amostras_exibicao, titles=titulos_exibicao, cols=4, figsize=(11, 6))
Figura 9.23
9.5.1.2.2.2 Bloco 2: Tre Strategie sulla Stessa Architettura

Per isolare l’effetto del trasferimento di apprendimento, le tre strategie riutilizzano esattamente la stessa architettura (ResNet-18), variando solo l’origine dei pesi e quali parametri rimangono addestrabili:

  1. do_zero: pesi casuali (weights=None) — equivalente ad addestrare l’architettura della ResNet-18 interamente da zero, come nel Blocco 2 dell’Esperimento 1.
  2. congelado: pesi pre-addestrati su ImageNet, con requires_grad = False in tutti i livelli convoluzionali — solo il nuovo livello finale viene addestrato.
  3. fine_tuning: pesi pre-addestrati su ImageNet come punto di partenza, ma senza congelamento — l’intera rete si adatta al nuovo dominio, con un tasso di apprendimento basso per non distruggere la conoscenza precedente.

In tutti i casi, il livello finale fc viene sostituito da nn.Linear(fc.in_features, 2), corrispondente alle due razze di destinazione.

transformacao_resnet = T.Compose([
    T.Resize((224, 224)),
    T.ToTensor(),
    T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

def prepara_tensores(imgs, labels):
    X = torch.stack([transformacao_resnet(img.convert("RGB")) for img in imgs])
    y = torch.tensor(labels, dtype=torch.long)
    return X, y

X_tr, y_tr = prepara_tensores(imgs_treino, y_treino)
X_te, y_te = prepara_tensores(imgs_teste, y_teste)

def cria_modelo_pets(estrategia):
    pesos = None if estrategia == "do_zero" else models.ResNet18_Weights.DEFAULT
    modelo = models.resnet18(weights=pesos)
    if estrategia == "congelado":
        for p in modelo.parameters():
            p.requires_grad = False
    modelo.fc = nn.Linear(modelo.fc.in_features, len(RACAS_ALVO))
    return modelo

modelo_do_zero = cria_modelo_pets("do_zero")
modelo_congelado = cria_modelo_pets("congelado")
modelo_fine_tuning = cria_modelo_pets("fine_tuning")
9.5.1.2.2.3 Blocco 3: Addestramento Comparativo e Analisi dell’Accuratezza

Riutilizzando le funzioni generiche treinar e calcular_acuracia, definite nel Blocco 2 dell’Esperimento 1, i tre modelli vengono addestrati sullo stesso insieme di \(30\) fotografie e valutati sul set di test (immagini mai viste durante l’addestramento):

  • Il modello do_zero tende a sovra-adattarsi rapidamente alle \(30\) fotografie di addestramento, senza generalizzare al set di test — \(30\) esempi sono drasticamente insufficienti per regolare gli \(11\) milioni di parametri della ResNet-18 da zero.
  • Il modello congelado dovrebbe già raggiungere un’accuratezza considerevolmente superiore, poiché riutilizza, senza alcuna regolazione, caratteristiche visive generiche (bordi, trame, contorni) apprese su ImageNet — solo il nuovo strato lineare deve essere adattato alle \(30\) fotografie.
  • Il modello fine_tuning tende a eguagliare o superare l’estrattore congelato, poiché parte dalla stessa conoscenza preliminare, ma consente inoltre una messa a punto fine dell’intera rete sulle peculiarità visive delle razze.

La Figura 9.24 riassume i tre risultati.

torch.manual_seed(42)

configuracoes = [
    ("Do zero",              modelo_do_zero,      None, 2e-3),
    ("Extrator congelado",   modelo_congelado,    "fc", 1e-3),
    ("Fine-tuning completo", modelo_fine_tuning,  None, 1e-4),
]

resultados_pets = {}
for nome, modelo, alvo_params, taxa in configuracoes:
    parametros = modelo.fc.parameters() if alvo_params == "fc" else None
    treinar(modelo, X_tr, y_tr, epocas=15, lr=taxa, tam_lote=8, parametros=parametros)
    resultados_pets[nome] = calcular_acuracia(modelo, X_te, y_te)
    print(f"{nome}: {resultados_pets[nome]*100:.1f}%")

plt.figure(figsize=(5.5, 4))
cores = ["#dc2626", "#f59e0b", "#16a34a"]
plt.bar(resultados_pets.keys(), resultados_pets.values(), color=cores)
plt.ylim(0, 1.05)
plt.axhline(0.5, color="gray", linestyle="--", linewidth=1, label="Chute aleatório (50%)")
plt.ylabel("Acurácia no teste")
plt.title("Pug vs. Boxer — 15 fotos de treino/classe")
for i, v in enumerate(resultados_pets.values()):
    plt.text(i, v + 0.02, f"{v*100:.1f}%", ha="center")
plt.xticks(rotation=10)
plt.legend()
plt.tight_layout()
plt.show()
Figura 9.24
9.5.1.2.2.4 Bloco 4: Ispezione Qualitativa delle Previsioni

Come nell’Esperimento 1 e nella sezione successiva sulla diagnostica fogliare, è istruttivo osservare singolarmente alcune previsioni del modello migliore (tipicamente fine_tuning o congelato) su fotografie reali di test, confrontando l’etichetta prevista con la razza effettiva.

melhor_modelo = modelo_fine_tuning  # oppure modello_congelato, in base al risultato del Blocco 3
melhor_modelo.eval()

idx_amostras = list(range(4)) + list(range(N_TESTE_POR_CLASSE, N_TESTE_POR_CLASSE + 4))

imgs_pred, titulos_pred = [], []
with torch.no_grad():
    for idx in idx_amostras:
        entrada = X_te[idx].unsqueeze(0)
        pred_idx = melhor_modelo(entrada).argmax(dim=1).item()
        real_idx = y_te[idx].item()
        marcador = "✓" if pred_idx == real_idx else "✗"
        imgs_pred.append(np.array(imgs_teste[idx].convert("RGB")))  # PIL -> ndarray
        titulos_pred.append(f"{marcador} previsto: {RACAS_ALVO[pred_idx]}\n"
                             f"real: {RACAS_ALVO[real_idx]}")

mm.show(imgs_pred, titles=titulos_pred, cols=4, figsize=(12, 7))
Figura 9.25
# Pulizia esplicita dei dati scaricati e liberazione della memoria
if FLAG_LIMPAR_DADOS:
    if os.path.exists('./dados_pets'):
        shutil.rmtree('./dados_pets')
        print('🧹 Directory dati temporanea ./dati_pets rimossa con successo.')

    if torch.cuda.is_available():
        torch.cuda.empty_cache()
9.5.1.2.3 Esperimento 3 — Diagnostico Fitopatologico con Transferimento di Apprendimento

L’esperimento precedente ha mostrato che una ResNet-18 preaddestrata su ImageNet può adattarsi a un nuovo compito utilizzando poche campioni. Ora, la stessa strategia viene applicata a un problema di diagnostica fitopatologica. La ResNet-18 deve classificare immagini di foglie in tre categorie: ["foglia_sana", "foglia_malata", "sintomo_sconosciuto"].

  • foglia_sana: foglia senza lesioni visibili.
  • foglia_malata: foglia con macchie scure che simulano una malattia fungina.
  • sintomo_sconosciuto: foglia con clorosi giallastra, che rappresenta un pattern diverso dalla malattia nota.
Consiglio🌱 Perché questo scenario?

La diagnostica fitopatologica costituisce un’importante applicazione della visione artificiale nell’agricoltura di precisione. Un modello preaddestrato su ImageNet può riutilizzare caratteristiche come bordi, texture e pattern di colore per apprendere questo nuovo compito con poche immagini.

9.5.1.2.3.1 Blocco 1: Generazione del Dataset Sintetico

Questo blocco genera un insieme sintetico con 30 immagini per classe per l’addestramento e 8 per la validazione, per un totale rispettivamente di 90 e 24 immagini.

  1. Generazione della foglia: La funzione desenha_folha_base crea il contorno della foglia, variando dimensioni, orientamento e tonalità di verde.

  2. Simulazione della malattia: La funzione aplica_manchas_doenca aggiunge macchie scure irregolari che simulano lesioni fungine.

  3. Simulazione di un altro sintomo: La funzione aplica_sintoma_desconhecido aggiunge regioni giallastre che rappresentano un pattern distinto dalla malattia nota.

  4. Visualizzazione dei campioni: La Figura 9.26 presenta esempi delle tre categorie dell’insieme sintetico.

CLASSES_FOLHA = ["folha_saudavel", "folha_doente", "sintoma_desconhecido"]


def desenha_folha_base(tam_img, rng):
    '''Disegna il contorno ovale di una foglia verde con nervatura centrale,
    con piccole variazioni di tonalità, dimensione e orientamento tra i campioni.'''
    img = np.full((tam_img, tam_img, 3), 245, dtype=np.uint8)  # sfondo chiaro
    cx, cy = tam_img // 2, tam_img // 2
    eixo_a = rng.randint(int(tam_img * 0.30), int(tam_img * 0.38))
    eixo_b = rng.randint(int(tam_img * 0.20), int(tam_img * 0.26))
    angulo = rng.uniform(-15, 15)
    verde = (rng.randint(40, 70), rng.randint(120, 160), rng.randint(40, 70))
    cv2.ellipse(img, (cx, cy), (eixo_a, eixo_b), angulo, 0, 360, verde, -1, cv2.LINE_AA)
    ang_rad = np.deg2rad(angulo)
    dx, dy = np.cos(ang_rad), np.sin(ang_rad)
    p1 = (int(cx - eixo_a * dx), int(cy - eixo_a * dy))
    p2 = (int(cx + eixo_a * dx), int(cy + eixo_a * dy))
    cv2.line(img, p1, p2, (25, 90, 25), 2, cv2.LINE_AA)  # nervatura centrale
    return img, (cx, cy, eixo_a, eixo_b, angulo)


def aplica_manchas_doenca(img, centro_folha, rng, n_manchas=(4, 8)):
    '''Simula lesioni fogliari: macchie scure dai bordi irregolari
    (pattern tipico di malattie fungine).'''
    cx, cy, eixo_a, eixo_b, _ = centro_folha
    for _ in range(rng.randint(*n_manchas)):
        raio = rng.randint(1, 3)
        px = cx + rng.randint(-int(eixo_a * 0.7), int(eixo_a * 0.7))
        py = cy + rng.randint(-int(eixo_b * 0.7), int(eixo_b * 0.7))
        cor_mancha = (rng.randint(50, 90), rng.randint(25, 45), rng.randint(10, 25))
        cv2.circle(img, (px, py), raio, cor_mancha, -1, cv2.LINE_AA)
        cv2.circle(img, (px, py), raio + 1, (120, 85, 30), 1, cv2.LINE_AA)  # alone
    return img


def aplica_sintoma_desconhecido(img, centro_folha, rng):
    '''Simula un pattern distinto (marmorizzato giallastro/clorosi), diverso
    dalle macchie scure della malattia nota.'''
    cx, cy, eixo_a, eixo_b, _ = centro_folha
    for _ in range(rng.randint(3, 5)):
        eixo_m = (rng.randint(1, 3), rng.randint(2, 3))
        px = cx + rng.randint(-int(eixo_a * 0.6), int(eixo_a * 0.6))
        py = cy + rng.randint(-int(eixo_b * 0.6), int(eixo_b * 0.6))
        cor_clorose = (rng.randint(200, 235), rng.randint(195, 225), rng.randint(50, 90))
        ang_m = rng.uniform(0, 180)
        cv2.ellipse(img, (px, py), eixo_m, ang_m, 0, 360, cor_clorose, -1, cv2.LINE_AA)
    return img


def aplica_ruido_sal_pimenta(img, prop_ruido=0.02, rng=None):
    '''Applica rumore sale (punti bianchi) e pepe (punti neri) casuali.
    prop_rumore: frazione di pixel modificati (es: 0.02 = 2% dei pixel).'''
    if prop_ruido <= 0:
        return img
    
    img_ruido = img.copy()
    num_pixels = int(prop_ruido * img.shape[0] * img.shape[1])
    n_sal = num_pixels // 2
    n_pimenta = num_pixels - n_sal

    # Applica Sale (Bianco - [255, 255, 255])
    for _ in range(n_sal):
        y = rng.randint(0, img.shape[0] - 1)
        x = rng.randint(0, img.shape[1] - 1)
        img_ruido[y, x] = [255, 255, 255]

    # Applica Pepe (Nero - [0, 0, 0])
    for _ in range(n_pimenta):
        y = rng.randint(0, img.shape[0] - 1)
        x = rng.randint(0, img.shape[1] - 1)
        img_ruido[y, x] = [0, 0, 0]

    return img_ruido


def gera_folha(classe_idx, tam_img=128, rng=None, prop_ruido=0.02):
    rng = rng or random.Random()
    img, geometria = desenha_folha_base(tam_img, rng)
    nome = CLASSES_FOLHA[classe_idx]
    
    if nome == "folha_doente":
        img = aplica_manchas_doenca(img, geometria, rng)
    elif nome == "sintoma_desconhecido":
        img = aplica_sintoma_desconhecido(img, geometria, rng)
        
    ruido_exp = rng.randint(-3, 3)  # leggera variazione di esposizione
    img = np.clip(img.astype(np.int16) + ruido_exp, 0, 255).astype(np.uint8)
    
    # Applicazione del rumore Sale e Pepe
    img = aplica_ruido_sal_pimenta(img, prop_ruido=prop_ruido, rng=rng)
    
    return img


def gera_conjunto(n_por_classe, tam_img=128, seed=0, prop_ruido=0.02):
    rng = random.Random(seed)
    imgs, labels = [], []
    for classe_idx in range(len(CLASSES_FOLHA)):
        for _ in range(n_por_classe):
          imgs.append(gera_folha(classe_idx, tam_img=tam_img, rng=rng, prop_ruido=prop_ruido))
          labels.append(classe_idx)
    return imgs, labels


N_POR_CLASSE_TREINO, N_POR_CLASSE_VAL = 30, 8

imgs_treino, labels_treino = gera_conjunto(n_por_classe=N_POR_CLASSE_TREINO, seed=42, 
                                           prop_ruido=0.02)
imgs_val, labels_val = gera_conjunto(n_por_classe=N_POR_CLASSE_VAL, seed=123, prop_ruido=0.02)

print(f"Addestramento: {len(imgs_treino)} immagini ({N_POR_CLASSE_TREINO} per classe) | "
      f"Validazione: {len(imgs_val)} immagini ({N_POR_CLASSE_VAL} per classe)")

# Visualizzazione di 2 campioni per ogni classe (6 immagini in totale)
amostras_exibir, titulos_exibir = [], []
for classe_idx, nome in enumerate(CLASSES_FOLHA):
    for k in range(2):
        idx = classe_idx * N_POR_CLASSE_TREINO + k
        amostras_exibir.append(imgs_treino[idx])
        titulos_exibir.append(nome)

mm.show(amostras_exibir, titles=titulos_exibir, cols=3, figsize=(10, 7))
Addestramento: 90 immagini (30 per classe) | Validazione: 24 immagini (8 per classe)
Figura 9.26: Campioni sintetici del dataset di diagnosi fogliare: foglia sana, foglia malata (macchie scure) e sintomo sconosciuto (clorosi giallastra) con rumore sale e pepe.
Nota🧠 Trappola Comune

Il trasferimento dell’apprendimento richiede che ogni classe presenti pattern visivi distinti. Ripetere la stessa immagine con etichette diverse impedisce al livello classificatore di apprendere una frontiera di decisione, poiché l’estrattore genera praticamente le stesse caratteristiche per tutti i campioni.

In questo esperimento, ogni immagine viene generata in modo indipendente, con pattern visivi compatibili con la propria classe (foglia sana, lesioni fungine o clorosi), fornendo informazioni sufficienti per l’addestramento del livello classificatore.

9.5.1.2.3.2 Bloco 2: Preparazione dei Tensori e Adattamento dell’Architettura

Modelli come la ResNet-18 richiedono immagini a colori di \(224 \times 224\) pixel normalizzate secondo le statistiche della ImageNet (\(\mu = [0,485; 0,456; 0,406]\) e \(\sigma = [0,229; 0,224; 0,225]\)).

  1. Trasformazione di Input (transforms.Compose): si applicano il ridimensionamento e la normalizzazione standard a ciascuna immagine del dataset sintetico, producendo i tensori X_treino/X_val e le etichette y_treino/y_val — ogni esempio è un’immagine genuinamente distinta, associata all’etichetta corretta della propria classe.
  2. Congelamento dell’Estrattore: il ciclo for p in modelo_resnet.parameters(): p.requires_grad = False disattiva i gradienti nei layer convoluzionali pre-addestrati.
  3. Nuovo Layer Finale: il layer modelo_resnet.fc viene sostituito da una nuova istanza nn.Linear(modelo_resnet.fc.in_features, n_classes_destino), appena inizializzata e con gradienti attivi per impostazione predefinita. Il numero di caratteristiche di input viene ottenuto dinamicamente dal layer originale stesso (in_features, pari a \(512\) nella ResNet-18), invece di essere fissato manualmente nel codice — pratica raccomandata, poiché rende il frammento riutilizzabile per altre varianti dell’architettura senza modifiche.
# 1. Pipeline di trasformazioni previste dalla ResNet
transformacao_resnet = T.Compose([
    T.Resize((224, 224)),
    T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])


def prepara_tensores(imgs, labels):
    tensores = [transformacao_resnet(T.functional.to_tensor(img)) for img in imgs]
    X = torch.stack(tensores)
    y = torch.tensor(labels, dtype=torch.long)
    return X, y


# 2. Conversione del dataset sintetico (Blocco 1) in tensori normalizzati
X_treino, y_treino = prepara_tensores(imgs_treino, labels_treino)
X_val, y_val = prepara_tensores(imgs_val, labels_val)

loader_treino = DataLoader(TensorDataset(X_treino, y_treino), batch_size=16, shuffle=True)
loader_val = DataLoader(TensorDataset(X_val, y_val), batch_size=16, shuffle=False)

# 3. Caricamento della ResNet-18 pre-addestrata e congelamento dell'estrattore
n_classes_destino = len(CLASSES_FOLHA)
modelo_resnet = models.resnet18(weights=models.ResNet18_Weights.DEFAULT)

for parametro in modelo_resnet.parameters():
    parametro.requires_grad = False

# 4. Sostituzione del layer finale per le 3 nuove classi di destinazione
modelo_resnet.fc = nn.Linear(modelo_resnet.fc.in_features, n_classes_destino)

print(f"Nuovo layer finale: {modelo_resnet.fc}")
9.5.1.2.3.3 Bloco 3: Ciclo di Addestramento e Valutazione

Con l’estrattore congelato e il nuovo strato di uscita correttamente collegato, si esegue il fine-tuning della nuova testa di classificazione.

  1. Ottimizzazione Mirata: l’ottimizzatore Adam riceve strettamente modelo_resnet.fc.parameters(), aggiornando solo il nuovo strato di uscita — il resto della rete rimane congelato, come definito nel Blocco 2.
  2. Esecuzione del Ciclo: a ogni epoca, il modello itera sui lotti di addestramento, calcola la perdita tramite Entropia Incrociata e regola i pesi dello strato finale; successivamente, si valuta l’accuratezza sul set di validazione (immagini mai viste durante l’addestramento).
  3. Curve di Addestramento: la Figura 9.27 monitora l’evoluzione della perdita di addestramento e dell’accuratezza di validazione lungo le epoche — poiché le tre classi sono visivamente distinte tra loro, ci si aspetta una convergenza genuina, ben al di sopra della soglia del \(33\%\) corrispondente a una scelta casuale tra \(3\) classi.
dispositivo = torch.device("cuda" if torch.cuda.is_available() else "cpu")
modelo_resnet = modelo_resnet.to(dispositivo)

criterio = nn.CrossEntropyLoss()
otimizador = optim.Adam(modelo_resnet.fc.parameters(), lr=1e-3)

historico_perda, historico_acc = [], []
epocas = 10

for epoca in range(epocas):
    modelo_resnet.train()
    perda_acumulada, n_batches = 0.0, 0

    for X_batch, y_batch in loader_treino:
        X_batch, y_batch = X_batch.to(dispositivo), y_batch.to(dispositivo)

        otimizador.zero_grad()
        saidas = modelo_resnet(X_batch)
        perda = criterio(saidas, y_batch)
        perda.backward()
        otimizador.step()

        perda_acumulada += perda.item()
        n_batches += 1
    historico_perda.append(perda_acumulada / n_batches)

    modelo_resnet.eval()
    acertos, total = 0, 0
    with torch.no_grad():
        for X_batch, y_batch in loader_val:
            X_batch, y_batch = X_batch.to(dispositivo), y_batch.to(dispositivo)
            predicoes = modelo_resnet(X_batch).argmax(dim=1)
            acertos += (predicoes == y_batch).sum().item()
            total += y_batch.size(0)
    acc = acertos / total
    historico_acc.append(acc)

    print(f"Epoca {epoca+1}/{epocas} — perdita: {historico_perda[-1]:.4f} — ",
          f" accuratezza_val: {acc*100:.1f}%")

f=mm.showTrainCurves(
    historico_perda, historico_acc,
    titulo="Fine-Tuning da ResNet-18 — Diagnóstico Foliar",
    subtitulo="Apenas a nova camada linear (fc) é treinada; o extrator permanece congelado",
)
Figura 9.27
9.5.1.2.3.4 Blocco 4: Ispezione Qualitativa delle Previsioni

Oltre alla curva di accuratezza aggregata, è istruttivo osservare individualmente alcune previsioni del modello sul set di validazione, confrontando l’etichetta prevista con quella reale. La Figura 9.28 mostra due campioni per ciascuna classe.

modelo_resnet.eval()

# Due campioni di ciascuna classe nell'insieme di validazione
idx_amostras = [0, N_POR_CLASSE_VAL, 2 * N_POR_CLASSE_VAL,
                1, N_POR_CLASSE_VAL + 1, 2 * N_POR_CLASSE_VAL + 1]

imgs_pred, titulos_pred = [], []
with torch.no_grad():
    for idx in idx_amostras:
        entrada = X_val[idx].unsqueeze(0).to(dispositivo)
        pred_idx = modelo_resnet(entrada).argmax(dim=1).item()
        real_idx = y_val[idx].item()
        marcador = "✓" if pred_idx == real_idx else "✗"
        imgs_pred.append(imgs_val[idx])
        titulos_pred.append(f"{marcador} previsto: {CLASSES_FOLHA[pred_idx]}\n"+
                            f"real: {CLASSES_FOLHA[real_idx]}")

mm.show(imgs_pred, titles=titulos_pred, cols=3, figsize=(10, 7))
Figura 9.28
9.5.1.2.3.5 Analisi dell’Esperimento 3

La ResNet-18 raggiunge un’elevata accuratezza anche utilizzando un insieme ridotto di immagini sintetiche. Questo risultato mostra che le rappresentazioni apprese su ImageNet rimangono utili in un dominio completamente diverso, richiedendo solo l’adattamento del livello classificatore.

L’esperimento illustra inoltre una situazione comune nelle applicazioni reali, in cui la disponibilità di dati etichettati è limitata. In questi scenari, il transfer learning riduce i tempi di addestramento e consente di ottenere modelli con buone prestazioni anche senza addestrare l’intera rete.

Nota🧠 Sintesi Comparativa — Quando Funziona il Transfer Learning?

I tre esperimenti mostrano che il transfer learning dipende dalla capacità di generalizzazione dell’estrattore di caratteristiche.

  • Esperimento 1: un estrattore di piccole dimensioni, addestrato su un dominio ristretto, apprende rappresentazioni poco generalizzabili e può produrre transfer negativo.

  • Esperimento 2: una ResNet-18 pre-addestrata su ImageNet trasferisce rappresentazioni generali a un compito di classificazione delle razze di cani e gatti, raggiungendo un’elevata accuratezza con poche immagini.

  • Esperimento 3: la stessa strategia adatta il modello a un problema di diagnosi fitosanitaria, dimostrando che un unico estrattore può servire come base per diversi domini applicativi.

9.5.1.2.4 Confronto tra Approcci di Trasferimento

La Tabella 9.2 riassume i risultati ottenuti nei tre esperimenti.

Tabella 9.2: Confronto tra i tre scenari di trasferimento dell’apprendimento presentati in questa sezione.
Aspetto Esperimento 1 Esperimento 2 Esperimento 3
Estrattore Piccola CNN ResNet-18 ResNet-18
Addestramento dell’estrattore Cifre (\(0\)–\(4\)) ImageNet ImageNet
Capacità di generalizzazione Bassa Alta Alta
Nuovo compito Cifre (\(5\)–\(9\)) Razze di cani e gatti Diagnosi fitosanitaria
Risultato Trasferimento negativo Trasferimento positivo Trasferimento positivo

9.5.2 Rilevamento di Oggetti

Gli esperimenti precedenti hanno mostrato come il transfer learning adatti modelli pre-addestrati per compiti di classificazione delle immagini. Lo stesso principio è alla base anche delle architetture di rilevamento degli oggetti, in cui un estrattore di caratteristiche pre-addestrato fornisce rappresentazioni visive generali, mentre moduli specializzati localizzano e classificano gli oggetti nell’immagine.

Le sezioni successive presentano la Faster R-CNN come esempio di rilevatore pre-addestrato utilizzato direttamente per l’inferenza e, successivamente, un esperimento completo di fine-tuning con l’architettura YOLO.

9.5.2.1 Faster R-CNN: Rilevatore Pre-addestrato

La rilevazione degli oggetti estende l’uso di modelli pre-addestrati a un compito più complesso della classificazione. La Faster R-CNN utilizza una CNN pre-addestrata, come la ResNet-50, come estrattore di caratteristiche (backbone) e aggiunge moduli specializzati per localizzare e classificare gli oggetti.

Riguardo a questo estrattore, l’architettura incorpora due “teste” principali:

  • Region Proposal Network (RPN): propone regioni dell’immagine con alta probabilità di contenere oggetti.
  • Testa classificatrice: affina queste regioni, assegna una classe a ciascun oggetto e regola le sue scatole delimitatrici.

Il codice seguente utilizza una Faster R-CNN con pesi pre-addestrati su COCO per rilevare oggetti in un’immagine, producendo le loro classi, coordinate e punteggi di confidenza.

Nota🔍 Dove si trova qui il transfer learning?

A differenza degli esperimenti precedenti, questo esempio non esegue il fine-tuning. Il modello esegue solo l’inferenza (eval()), riutilizzando direttamente i pesi del backbone, della RPN e della testa classificatrice addestrati su COCO.

L’adattamento a un nuovo dominio richiederebbe di sostituire il layer box_predictor con una nuova testa di classificazione, compatibile con le classi dell’applicazione, e di addestrarla su un insieme di immagini annotate. Questa procedura segue lo stesso principio presentato nella sezione sul transfer learning e costituisce il flusso usuale per applicazioni specifiche, come la rilevazione di parassiti, difetti di fabbricazione o veicoli.

  1. Categorie COCO: Il codice recupera i nomi delle classi dalle meta-informazioni dei pesi (FasterRCNN_ResNet50_FPN_Weights.DEFAULT.meta["categories"]). Sebbene questo elenco contenga \(91\) voci per ragioni storiche del formato di annotazione di COCO, solo \(80\) corrispondono a categorie di oggetti.

  2. Inferenza: L’immagine caricata da mm.read() viene convertita in tensor e processata dal modello in modalità di valutazione (eval()). Il codice mantiene solo le rilevazioni con confidenza superiore all’\(80\%\).

  3. Annotazione dell’immagine: Per ogni oggetto rilevato, il codice disegna la scatola delimitatrice (cv2.rectangle) e scrive la classe predetta e la sua confidenza (cv2.putText).

  4. Visualizzazione: La Figura 9.29 presenta l’immagine annotata con le rilevazioni effettuate dal modello.

# 1. Caricamento dell'immagine e dei nomi delle categorie di COCO
url_imagem = "https://raw.githubusercontent.com/pytorch/hub/master/images/dog.jpg"
url_imagem = "http://images.cocodataset.org/val2017/000000039769.jpg"
img = mm.read(url_imagem)

pesos_coco = FasterRCNN_ResNet50_FPN_Weights.DEFAULT
categorias_coco = pesos_coco.meta["categories"]  # Mappatura indice -> nome della classe

# 2. Caricamento del modello Faster R-CNN pre-addestrato
modelo_detection = fasterrcnn_resnet50_fpn(weights=pesos_coco).eval()

# 3. Esecuzione dell'inferenza senza calcolo dei gradienti
with torch.no_grad():
    predicao = modelo_detection([to_tensor(img)])[0]

# 4. Filtraggio delle rilevazioni con confidenza superiore all'80%
limiar_confianca = 0.8
mascara_confianca = predicao["scores"] >= limiar_confianca

caixas_filtradas = predicao["boxes"][mascara_confianca].numpy()
scores_filtrados = predicao["scores"][mascara_confianca].numpy()
labels_filtrados = predicao["labels"][mascara_confianca].numpy()

img_com_caixas = img.copy()

# 5. Disegno delle bounding box e delle etichette di classe
for box, score, label_idx in zip(caixas_filtradas, scores_filtrados, labels_filtrados):
    x1, y1, x2, y2 = box.astype(int)
    nome_classe = categorias_coco[label_idx]
    texto_rotulo = f"{nome_classe}: {score:.2f}"

    # Disegna il rettangolo rosso (RGB: 255, 0, 0) con spessore di 3 pixel
    cv2.rectangle(img_com_caixas, (x1, y1), (x2, y2), (255, 0, 0), 3)

    # Scrive la classe e la confidenza sopra la bounding box
    cv2.putText(
        img_com_caixas,
        texto_rotulo,
        (x1, max(y1 - 10, 20)),
        cv2.FONT_HERSHEY_SIMPLEX,
        0.8,
        (255, 0, 0),
        2,
        cv2.LINE_AA,
    )

# 6. Visualizzazione grafica dell'immagine risultante
mm.show(img_com_caixas, title="Faster R-CNN (COCO) — Rilevamento con Classe e Confidenza")
Figura 9.29

9.5.2.2 Rilevamento di Oggetti e Trasferimento dell’Apprendimento con YOLO

Le sezioni precedenti hanno applicato il trasferimento dell’apprendimento a problemi di classificazione delle immagini, in cui il modello associa un’unica etichetta all’intera immagine. In questa sezione, lo stesso principio viene esteso al rilevamento di oggetti, un compito che richiede di identificare simultaneamente cosa è presente nell’immagine e dove si trova ciascun oggetto.

La sottosezione precedente ha presentato la Faster R-CNN come esempio di rilevatore pre-addestrato utilizzato direttamente per l’inferenza, senza alcun adattamento al nuovo dominio. In questo esperimento, il modello viene sottoposto a una fase di ottimizzazione fine (fine-tuning): si parte da un’architettura YOLO (You Only Look Once) pre-addestrata sul dataset COCO e si adatta la rete per rilevare e classificare oggetti di un nuovo dominio.

A differenza della Faster R-CNN, che esegue il rilevamento in due fasi, la famiglia YOLO adotta un’architettura a stadio singolo (single-stage detector), stimando, in un’unica propagazione attraverso la rete, le scatole delimitatrici (bounding boxes), la confidenza di ciascun rilevamento e la classe corrispondente. Questa strategia riduce il costo computazionale e rende possibili applicazioni in tempo reale.

Come esempio, l’esperimento utilizza un insieme sintetico di forme geometriche (triangoli, quadrati, stelle, tra le altre), con variazioni di colore, dimensione, rotazione e degrado dovuto a rumore di tipo sale e pepe.

9.5.2.2.1 Bloco 1: Generazione del Dataset Sintetico

Il blocco seguente genera un insieme sintetico per l’addestramento e la valutazione del rivelatore. Ogni immagine contiene da uno a tre oggetti appartenenti a una delle nove classi:

CLASSES = [
    'Triangle', 'Square', 'Pentagon', 'Hexagon',
    'Heptagon', 'Circle', 'Ellipse', 'Star', 'Cross'
]
  1. Generazione delle forme: Le funzioni poligono_regular, poligono_estrela e poligono_cruz costruiscono le coordinate degli oggetti. La funzione desenha_objeto disegna ogni forma con posizione, dimensione, orientamento e colore casuali e calcola la sua bounding box.

  2. Annotazione nel formato YOLO: La funzione gera_imagem_ruidosa genera da uno a tre oggetti per immagine e converte ogni bounding box nel formato YOLO, rappresentato dalla classe e dalle coordinate normalizzate del centro, larghezza e altezza.

  3. Degradazione dell’immagine: La funzione adiciona_ruido_sal_pimenta aggiunge rumore impulsivo, simulando imperfezioni di acquisizione.

  4. Visualizzazione dei campioni: La Figura 9.30 presenta esempi dell’insieme sintetico con le bounding boxes sovrapposte tramite la funzione mm.showBoundBox().

CLASSES = [
    'Triangle', 'Square', 'Pentagon', 'Hexagon',
    'Heptagon', 'Circle', 'Ellipse', 'Star', 'Cross'
]
N_LADOS = {'Triangle': 3, 'Square': 4, 'Pentagon': 5, 'Hexagon': 6, 'Heptagon': 7}

def poligono_regular(cx, cy, r, n_lados, rot_graus):
    ang0 = np.deg2rad(rot_graus - 90)
    angs = ang0 + 2 * np.pi * np.arange(n_lados) / n_lados
    return np.stack([cx + r * np.cos(angs), cy + r * np.sin(angs)], axis=1)

def poligono_estrela(cx, cy, r_externo, rot_graus, n_pontas=5):
    r_interno = r_externo * 0.45
    ang0 = np.deg2rad(rot_graus - 90)
    angs = ang0 + np.pi * np.arange(2 * n_pontas) / n_pontas
    raios = np.where(np.arange(2 * n_pontas) % 2 == 0, r_externo, r_interno)
    return np.stack([cx + raios * np.cos(angs), cy + raios * np.sin(angs)], axis=1)

def poligono_cruz(cx, cy, r, rot_graus, espessura_rel=0.35):
    w = r * espessura_rel
    base = np.array([
        (-w, -r), (w, -r), (w, -w), (r, -w), (r, w), (w, w),
        (w, r), (-w, r), (-w, w), (-r, w), (-r, -w), (-w, -w),
    ])
    theta = np.deg2rad(rot_graus)
    R = np.array([[np.cos(theta), -np.sin(theta)], [np.sin(theta), np.cos(theta)]])
    return base @ R.T + np.array([cx, cy])

def desenha_objeto(img, classe_idx, cx, cy, tamanho, rotacao, cor):
    nome = CLASSES[classe_idx]
    if nome in N_LADOS:
        pts = poligono_regular(cx, cy, tamanho, N_LADOS[nome], rotacao)
        cv2.fillPoly(img, [pts.astype(np.int32)], cor)
        xs, ys = pts[:, 0], pts[:, 1]
    elif nome == 'Star':
        pts = poligono_estrela(cx, cy, tamanho, rotacao)
        cv2.fillPoly(img, [pts.astype(np.int32)], cor)
        xs, ys = pts[:, 0], pts[:, 1]
    elif nome == 'Cross':
        pts = poligono_cruz(cx, cy, tamanho, rotacao)
        cv2.fillPoly(img, [pts.astype(np.int32)], cor)
        xs, ys = pts[:, 0], pts[:, 1]
    elif nome == 'Circle':
        cv2.circle(img, (int(cx), int(cy)), int(tamanho), cor, -1)
        xs, ys = np.array([cx - tamanho, cx + tamanho]), np.array([cy - tamanho, cy + tamanho])
    else:  # Ellisse
        eixo = (int(tamanho), int(tamanho * 0.6))
        cv2.ellipse(img, (int(cx), int(cy)), eixo, rotacao, 0, 360, cor, -1)
        ang = np.deg2rad(rotacao)
        dx = np.hypot(eixo[0] * np.cos(ang), eixo[1] * np.sin(ang))
        dy = np.hypot(eixo[0] * np.sin(ang), eixo[1] * np.cos(ang))
        xs, ys = np.array([cx - dx, cx + dx]), np.array([cy - dy, cy + dy])
    return xs.min(), ys.min(), xs.max(), ys.max()

def adiciona_ruido_sal_pimenta(img, quantidade=0.05):
    img_ruidosa = img.copy()
    h, w, c = img_ruidosa.shape
    num_ruido = int(quantidade * h * w)
    
    # Sale (255, 255, 255)
    coords_sal = [np.random.randint(0, i - 1, num_ruido) for i in (h, w)]
    img_ruidosa[coords_sal[0], coords_sal[1]] = [255, 255, 255]
    
    # Pepe (0, 0, 0)
    coords_pimenta = [np.random.randint(0, i - 1, num_ruido) for i in (h, w)]
    img_ruidosa[coords_pimenta[0], coords_pimenta[1]] = [0, 0, 0]
    
    return img_ruidosa

def gera_imagem_ruidosa(tam_img=160, n_objetos=(1, 3), taxa_ruido=0.01, rng=None):
    rng = rng or random.Random()
    img_limpa = np.full((tam_img, tam_img, 3), 255, dtype=np.uint8)
    anotacoes = []
    
    for _ in range(rng.randint(*n_objetos)):
        classe_idx = rng.randrange(len(CLASSES))
        tamanho = rng.randint(tam_img // 10, tam_img // 5)
        cx = rng.randint(tamanho + 2, tam_img - tamanho - 2)
        cy = rng.randint(tamanho + 2, tam_img - tamanho - 2)
        rotacao = rng.uniform(0, 360)
        cor = tuple(rng.sample(range(30, 226), 3))
        
        x0, y0, x1, y1 = desenha_objeto(img_limpa, classe_idx, cx, cy, tamanho, rotacao, cor)
        x0, y0 = max(x0, 0), max(y0, 0)
        x1, y1 = min(x1, tam_img), min(y1, tam_img)
        
        # Formato YOLO: (classe, centro_x, centro_y, larghezza, altezza) normalizzati
        xc, yc = (x0 + x1) / 2 / tam_img, (y0 + y1) / 2 / tam_img
        w, h = (x1 - x0) / tam_img, (y1 - y0) / tam_img
        anotacoes.append((classe_idx, xc, yc, w, h)) 
        
    img_ruidosa = adiciona_ruido_sal_pimenta(img_limpa, quantidade=taxa_ruido)
    return img_ruidosa, anotacoes
# Generazione di 5 campioni per la visualizzazione iniziale in cima al progetto
n_amostras_iniciais = 5
rng_demo = random.Random(42)

imgs_demo = []
titulos_demo = []

for idx in range(n_amostras_iniciais):
    img_ruid, anotacoes = gera_imagem_ruidosa(rng=rng_demo)
    
    # Scrittura temporanea dell'annotazione per la lettura nativa tramite mm.showBoundBox
    filename_temp = f"temp_label_{idx}.txt"
    with open(filename_temp, "w") as f:
        for c, xc, yc, w, h in anotacoes:
            f.write(f"{c} {xc:.4f} {yc:.4f} {w:.4f} {h:.4f}\n")
            
    img_anotada = mm.showBoundBox(img_ruid, filename=filename_temp, fmt="yolo", show=False)
    imgs_demo.append(img_anotada)
    titulos_demo.append(f"Amostra {idx+1}")

# Visualizzazione del pannello di 5 campioni
mm.show(
    imgs_demo,
    titles=titulos_demo,
    cols=n_amostras_iniciais,
    figsize=(14, 3)
)
Figura 9.30: Campioni iniziali del dataset sintetico rumoroso di oggetti geometrici con le bounding box in formato YOLO sovrapposte.
9.5.2.2.2 Bloco 2: Organizzazione del Dataset e Creazione del File data.yaml

Questo blocco organizza il set di dati nel formato previsto dalla libreria Ultralytics YOLO. Le immagini e le annotazioni sono distribuite in directory separate per l’addestramento e la validazione, mentre il file data.yaml raccoglie le informazioni necessarie per l’addestramento del rilevatore.

shapes_dataset/
├── data.yaml
├── images/
│   ├── train/
│   └── val/
└── labels/
    ├── train/
    └── val/
  1. Generazione del set di dati: Il codice crea 90 immagini per l’addestramento e 20 per la validazione. Per ciascuna immagine, scrive un file .txt contenente una riga per oggetto, nel formato YOLO (classe, x_c, y_c, larghezza, altezza), con tutte le coordinate normalizzate.

  2. Organizzazione dei file: Le immagini sono archiviate in images/train e images/val, mentre le annotazioni corrispondenti vengono salvate in labels/train e labels/val, preservando lo stesso nome del file.

  3. Creazione del file data.yaml: Il codice genera automaticamente il file di configurazione contenente il percorso del dataset, le directory di addestramento e validazione e la mappatura tra gli indici numerici e i nomi delle nove classi.

base_dir = "shapes_dataset"
rng_global = random.Random(42)

for split, n_imgs in [("train", 90), ("val", 20)]:
    os.makedirs(f"{base_dir}/images/{split}", exist_ok=True)
    os.makedirs(f"{base_dir}/labels/{split}", exist_ok=True)
    
    for i in range(n_imgs):
        img_ruid, anotacoes = gera_imagem_ruidosa(rng=rng_global)
        cv2.imwrite(f"{base_dir}/images/{split}/{i:04d}.jpg", img_ruid)
        
        with open(f"{base_dir}/labels/{split}/{i:04d}.txt", "w") as f:
            for c, xc, yc, w, h in anotacoes:
                f.write(f"{c} {xc:.4f} {yc:.4f} {w:.4f} {h:.4f}\n")

with open(f"{base_dir}/data.yaml", "w") as f:
    f.write(
        f"path: {os.path.abspath(base_dir)}\n"
        "train: images/train\nval: images/val\nnames:\n"
    )
    for i, nome in enumerate(CLASSES):
        f.write(f"  {i}: {nome}\n")

print("Set di dati rumoroso generato con successo: 90 immagini di addestramento e 20 di validazione.")
Set di dati rumoroso generato con successo: 90 immagini di addestramento e 20 di validazione.
9.5.2.2.3 Bloco 3: Pre-elaborazione con Filtro Mediano

Questo blocco applica una pre-elaborazione per ridurre l’effetto del rumore di tipo sale e pepe introdotto nella generazione del dataset. Il Filtro Mediano (cv2.medianBlur) rimuove questo tipo di degradazione preservando meglio i bordi degli oggetti rispetto ai filtri di smoothing convenzionali.

  1. Filtraggio dell’immagine: Il codice applica un filtro mediano con finestra \(3 \times 3\) all’immagine rumorosa, riducendo i pixel impulsivi senza alterare le annotazioni del dataset.

  2. Visualizzazione comparativa: La Figura 9.31 confronta l’immagine originale e l’immagine filtrata, mantenendo le bounding boxes sovrapposte tramite la funzione mm.showBoundBox().

# 1. Caricamento del primo campione rumoroso del dataset
caminho_img = f"{base_dir}/images/train/0000.jpg"
caminho_label = f"{base_dir}/labels/train/0000.txt"

img_ruidosa = mm.read(caminho_img)

# 2. Pre-elaborazione con Filtro Mediano (finestra 3x3)
img_filtrada = cv2.medianBlur(img_ruidosa, ksize=3)

# 3. Sovrapposizione delle bounding box con mm.showBoundBox
img_ruid_anotada = mm.showBoundBox(img_ruidosa, filename=caminho_label, fmt="yolo", show=False)
img_filt_anotada = mm.showBoundBox(img_filtrada, filename=caminho_label, fmt="yolo", show=False)

# 4. Visualizzazione comparativa con mm.show
mm.show(
    [img_ruid_anotada, img_filt_anotada],
    titles=[
        "1. Immagine Rumorosa Originale (Sale e Pepe)",
        "2. Pre-elaborata (Filtro Mediano 3x3)"
    ],
    cols=2,
    figsize=(9, 4)
)
Figura 9.31: Confronto tra l’immagine originale con rumore sale e pepe e l’immagine dopo l’applicazione del Filtro Mediano (3x3). Le bounding box in formato YOLO rimangono invariate.
9.5.2.2.4 Bloco 4: Pre-elaborazione del Dataset e Fine-Tuning di YOLOv8

Questo blocco applica il Filtro Mediano all’insieme di immagini ed esegue il fine-tuning del rilevatore YOLOv8n pre-addestrato sull’insieme COCO. La filtrazione riduce l’effetto del rumore impulsivo introdotto nella generazione delle immagini, mentre l’addestramento adatta i parametri della rete al nuovo dominio delle forme geometriche.

  1. Filtraggio in batch: Il codice scorre le directory train e val e applica cv2.medianBlur con finestra \(3 \times 3\) su tutte le immagini, mantenendo le annotazioni YOLO originali.

  2. Fine-tuning del rilevatore: La rete YOLO("yolov8n.pt"), inizialmente addestrata su COCO, viene adattata all’insieme geometrico tramite la funzione .train(). L’addestramento utilizza immagini con risoluzione \(320 \times 320\) pixel per \(30\) epoche.

  3. Valutazione del modello: La funzione .val() calcola le metriche di rilevamento sull’insieme di validazione, includendo precisione (precision), revocazione (recall) e mAP50 (mean Average Precision con soglia IoU pari a \(0,5\)).

import logging

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

base_dir = "shapes_dataset"
base_dir_filt = "shapes_dataset_filtrado"

# 1. Crea una CÓPIA filtrata del dataset in una cartella separata
#    (il dataset originale in base_dir rimane rumoroso, intatto)
for split in ["train", "val"]:
    pasta_imgs_orig = f"{base_dir}/images/{split}"
    pasta_labels_orig = f"{base_dir}/labels/{split}"
    pasta_imgs_filt = f"{base_dir_filt}/images/{split}"
    pasta_labels_filt = f"{base_dir_filt}/labels/{split}"

    os.makedirs(pasta_imgs_filt, exist_ok=True)
    os.makedirs(pasta_labels_filt, exist_ok=True)

    for nome_arq in os.listdir(pasta_imgs_orig):
        if nome_arq.endswith(".jpg"):
            img_ruidosa = cv2.imread(f"{pasta_imgs_orig}/{nome_arq}")
            img_filtrada = cv2.medianBlur(img_ruidosa, ksize=3)
            # salva la versione filtrata nella cartella NUOVA, non sovrascrive l'originale
            cv2.imwrite(f"{pasta_imgs_filt}/{nome_arq}", img_filtrada)

    # copia le etichette (non cambiano con il filtro)
    for nome_arq in os.listdir(pasta_labels_orig):
        shutil.copy(f"{pasta_labels_orig}/{nome_arq}", f"{pasta_labels_filt}/{nome_arq}")

# 2. data.yaml che punta al dataset FILTRATO
with open(f"{base_dir_filt}/data.yaml", "w") as f:
    f.write(
        f"path: {os.path.abspath(base_dir_filt)}\n"
        "train: images/train\nval: images/val\nnames:\n"
    )
    for i, nome in enumerate(CLASSES):
        f.write(f"  {i}: {nome}\n")

print("Pre-elaborazione completata: dataset filtrato salvato in una cartella separata.\n")

# Scaricare il modello YOLOv8 pre-addestrato (yolov8n.pt) se non è già presente
with contextlib.redirect_stdout(io.StringIO()), \
    contextlib.redirect_stderr(io.StringIO()):
    modelo_yolo = YOLO("yolov8n.pt")
print("Modello YOLOv8 caricato.")
Pre-elaborazione completata: dataset filtrato salvato in una cartella separata.

Modello YOLOv8 caricato.
# 3. Callback personalizzato per stampare solo l'epoca in esecuzione
def on_train_epoch_start(trainer):
    epoch_atual = trainer.epoch + 1
    total_epochs = trainer.epochs
    # Scrive direttamente sullo stdout originale (bypassando il silenziatore)
    sys.__stdout__.write(f"🔄 Processando Época {epoch_atual}/{total_epochs}...\n")
    sys.__stdout__.flush()

# Aggiunge il callback al modello
modelo_yolo.add_callback("on_train_epoch_start", on_train_epoch_start)

# 4. Gestore di contesto per silenziare la spazzatura di Ultralytics (C/C++ e Python)
@contextlib.contextmanager
def silenciar_logs():
    logger = logging.getLogger("ultralytics")
    disabled_state = logger.disabled
    logger.disabled = True
    
    with open(os.devnull, "w") as fnull:
        old_stdout_fd = os.dup(1)
        old_stderr_fd = os.dup(2)
        try:
            os.dup2(fnull.fileno(), 1)
            os.dup2(fnull.fileno(), 2)
            with contextlib.redirect_stdout(fnull), contextlib.redirect_stderr(fnull):
                yield
        finally:
            os.dup2(old_stdout_fd, 1)
            os.dup2(old_stderr_fd, 2)
            os.close(old_stdout_fd)
            os.close(old_stderr_fd)
            logger.disabled = disabled_state

# Esecuzione dell'Addestramento
print("--- Avvio Addestramento YOLOv8 ---")
with silenciar_logs():
    resultados_treino = modelo_yolo.train(
        data=f"{base_dir_filt}/data.yaml",   # <-- addestra sul dataset filtrato
        epochs=30,
        imgsz=320,
        batch=16,
        device=device,
        verbose=False,
        plots=False
    )
    metricas = modelo_yolo.val(verbose=False)

# 5. Metriche Finali
precision = metricas.results_dict["metrics/precision(B)"]
recall = metricas.results_dict["metrics/recall(B)"]
map50 = metricas.results_dict["metrics/mAP50(B)"]

print("\n--- Prestazioni Ottimizzate del Modello YOLOv8 ---")
print(f"Precisione: {precision*100:.2f}%")
print(f"Revocazione (Recall): {recall*100:.2f}%")
print(f"mAP al 50% (IoU 0.50): {map50*100:.2f}%")
--- Avvio Addestramento YOLOv8 ---

--- Prestazioni Ottimizzate del Modello YOLOv8 ---
Precisione: 73.26%
Revocazione (Recall): 81.14%
mAP al 50% (IoU 0.50): 86.49%
9.5.2.2.5 Blocco 5: Confronto di Inferenza: Immagine Rumorosa e Immagine Ripristinata

Dopo la messa a punto della YOLOv8 sull’insieme ripristinato, si esegue un confronto visivo tra il rilevamento applicato direttamente a un’immagine degradata dal rumore sale e pepe e la stessa immagine dopo il Filtro Mediano.

L’obiettivo è osservare come una semplice fase di preelaborazione possa influenzare la qualità delle previsioni di un rilevatore già adattato al nuovo dominio.

  1. Inferenza con la YOLO: La funzione modello_yolo.predict() esegue il rilevamento nelle due versioni dell’immagine, utilizzando una soglia di confidenza del \(25\%\) (conf=0.25).

  2. Visualizzazione delle Previsioni: La funzione plot() genera le immagini annotate con i riquadri delimitatori e le etichette previste dal modello. La Figura 9.32 presenta il confronto tra i due scenari.

# 1. Caricamento di un campione di test originale (senza il filtro salvato in batch)
caminho_teste = f"{base_dir}/images/val/0002.jpg"
img_ruidosa_teste = mm.read(caminho_teste)

# 2. Applicazione puntuale del Filtro Mediano (3x3) per il confronto
img_filtrada_teste = cv2.medianBlur(img_ruidosa_teste, ksize=3)

# 3. Inferenza con il modello YOLOv8 addestrato
pred_ruidosa = modelo_yolo.predict(img_ruidosa_teste, conf=0.25, verbose=False)[0]
pred_filtrada = modelo_yolo.predict(img_filtrada_teste, conf=0.25, verbose=False)[0]

# 4. Estrazione delle matrici annotate dal generatore di YOLO (conversione BGR -> RGB)
img_pred_ruid = cv2.cvtColor(pred_ruidosa.plot(), cv2.COLOR_BGR2RGB)
img_pred_filt = cv2.cvtColor(pred_filtrada.plot(), cv2.COLOR_BGR2RGB)

# 5. Visualizzazione comparativa standardizzata tramite mm.show
mm.show(
    [img_pred_ruid, img_pred_filt],
    titles=[
        f"Inferenza sull'Immagine Rumorosa ({len(pred_ruidosa.boxes)} oggetti)",
        f"Inferenza sull'Immagine Filtrata ({len(pred_filtrada.boxes)} oggetti)"
    ],
    cols=2,
    figsize=(10, 4)
)
Figura 9.32
# Pulizia esplicita dei dati scaricati e liberazione della memoria
if FLAG_LIMPAR_DADOS:
    if os.path.exists(base_dir):
        shutil.rmtree(base_dir)
        print('🧹 Diretório de dados temporários {} removido com sucesso.'.format(base_dir))

    if os.path.exists(base_dir_filt):
        shutil.rmtree(base_dir_filt)
        print('🧹 Diretório de dados temporários {} removido com sucesso.'.format(base_dir_filt))

    if torch.cuda.is_available():
        torch.cuda.empty_cache()
Nota🧠 Un dominio molto più distante di quello delle cifre

Nell’esperimento di transfer learning tra cifre scritte a mano (domini A e B), il compito di origine e quello di destinazione condividevano statistiche visive molto simili: entrambi erano tratti in scala di grigi su sfondo uniforme. Qui, la distanza tra i domini è molto maggiore — YOLO è stato pre-addestrato su fotografie naturali a colori di COCO (persone, animali, veicoli, oggetti quotidiani), e il compito di destinazione consiste in forme geometriche sintetiche, di colore pieno e contorno ben definito, senza texture, illuminazione o sfondo complesso.

Ciononostante, il transfer learning risulta vantaggioso: i primi strati di un rilevatore addestrato su COCO apprendono filtri generici — rilevatori di bordi, angoli e regioni di contrasto — che restano utili per delimitare il contorno di un triangolo o di una stella, anche se il contenuto visivo finale è piuttosto diverso. È per questo che consentire il fine-tuning di tutti gli strati, combinato con un preprocessamento coerente tra addestramento e inferenza per attenuare il rumore sale e pepe, rende possibili tassi di accuratezza elevati nel rilevamento di oggetti del nuovo dominio.

9.5.2.2.6 Utilizzando un Set di Dati Reale

Il pipeline sopra descritto è stato costruito interamente attorno al formato di annotazione YOLO (classe, \(x_{centro}\), \(y_{centro}\), larghezza, altezza, normalizzati per larghezza e altezza dell’immagine) esattamente affinché possa essere riutilizzato senza modifiche qualora il lettore abbia accesso a un set di immagini reali annotate nello stesso modo — ad esempio, un set di immagini di oggetti geometrici fotografati o renderizzati, ciascuno con un file .txt corrispondente nello stesso formato usato qui. A tal fine, basterebbe:

  1. Organizzare le immagini reali in shapes_dataset/images/train e shapes_dataset/images/val, e i file .txt di annotazione corrispondenti nelle cartelle labels/train e labels/val (un file di annotazione per immagine, stesso nome di base, estensione .txt);
  2. Modificare il file data.yaml qualora il numero o i nomi delle classi fossero diversi;
  3. Eseguire le stesse celle di addestramento, ottimizzazione e visualizzazione già presentate, senza alcun’altra modifica al codice.

Questa separazione tra generazione/organizzazione dei dati e addestramento del modello è, in pratica, il motivo per cui formati di annotazione standardizzati (come quello di YOLO) sono così ampiamente adottati: essi consentono di sostituire il set di dati di input — da sintetico a reale, da un dominio a un altro — mantenendo invariato tutto il resto del pipeline di transfer learning.

9.5.3 Segmentazione degli Oggetti

Lo stesso principio di trasferimento dell’apprendimento è alla base anche delle architetture di segmentazione delle immagini, in cui un estrattore di caratteristiche pre-addestrato fornisce rappresentazioni visive generali, mentre una testa specializzata esegue la classificazione densa, pixel per pixel.

Le sezioni successive presentano DeepLabV3 come esempio di segmentatore pre-addestrato utilizzato direttamente per l’inferenza e, successivamente, l’architettura U-Net, addestrata da zero e confrontata con una baseline morfologica classica.

9.5.3.1 DeepLabV3: Segmentatore Pre-addestrato

Nella segmentazione semantica, l’obiettivo non si limita alla localizzazione degli oggetti tramite bounding box. La rete assegna una classe a ogni pixel dell’immagine, producendo una mappa di etichette con la stessa risoluzione dell’input. Architetture come la DeepLabV3, con backbone ResNet-50, utilizzano un estrattore di caratteristiche pre-addestrato e una testa specializzata per eseguire questa classificazione densa.

  1. Caricamento e inferenza: Il modello deeplabv3_resnet50(weights="DEFAULT") carica pesi pre-addestrati sul dataset Pascal VOC, che definisce \(21\) classi di segmentazione. Il codice converte l’immagine in tensore, aggiunge la dimensione del batch (unsqueeze(0)) ed esegue l’inferenza.

  2. Mappa delle classi: L’output del modello ha dimensioni \((1, 21, H, W)\), contenente un valore per ogni classe in ogni pixel. L’operazione .argmax(dim=1) seleziona la classe con la risposta più alta in ciascuna posizione, generando una matrice bidimensionale di etichette con dimensioni \((H, W)\).

  3. Visualizzazione: Il codice converte la mappa delle etichette nel formato atteso da mm.show(), che mostra il risultato della segmentazione nella Figura 9.33.

# 1. Caricamento dell'immagine (restituisce numpy.ndarray)
url_imagem = "https://raw.githubusercontent.com/pytorch/hub/master/images/dog.jpg"
url_imagem = "http://images.cocodataset.org/val2017/000000039769.jpg"
img = mm.read(url_imagem)

# 2. Caricamento del modello DeepLabV3 pre-addestrato in modalità di valutazione
modelo_segmentacao = deeplabv3_resnet50(weights="DEFAULT").eval()

# 3. Esecuzione dell'inferenza senza calcolo dei gradienti
with torch.no_grad():
    tensor_entrada = to_tensor(img).unsqueeze(0)  # Formato (1, C, H, W)
    saida = modelo_segmentacao(tensor_entrada)["out"]
    
    # Selezione della classe con probabilità maggiore per pixel (argmax sull'asse dei canali)
    mapa_classes = saida.argmax(dim=1).squeeze(0).byte().cpu().numpy()

# 4. Visualizzazione della mappa di segmentazione semantica
mm.show(
    [img,mapa_classes],
    title=["Immagine originale","Segmentazione Semantica (DeepLabV3)"]
)
Figura 9.33

9.5.3.2 Segmentazione Semantica con Architettura U-Net

La sottosezione precedente ha presentato un modello pre-addestrato (DeepLabV3) che produce direttamente un’etichetta di classe per pixel. Questa sezione completa la sequenza di progetti pratici — classificazione e rilevamento — affrontando la segmentazione semantica implementata e addestrata da zero con la U-Net, l’architettura di riferimento introdotta da Ronneberger (2015).

Nella classificazione, la mappa delle caratteristiche finale veniva appiattita (flatten) in un vettore, scartando l’informazione spaziale a favore di un’unica etichetta per immagine. La U-Net, invece, produce un’uscita con la stessa risoluzione spaziale dell’ingresso: una mappa bidimensionale in cui ogni pixel riceve la propria classificazione. Questo requisito — preservare il dettaglio spaziale ad alta risoluzione mentre si costruisce il contesto semantico negli strati profondi — motiva l’architettura encoder-decoder con connessioni di salto (skip connections).

Lo scenario utilizzato simula la segmentazione di noduli in esami medici sintetici: immagini in scala di grigi contengono una regione circolare (“nodulo”) sovrapposta a uno sfondo, entrambi contaminati da rumore gaussiano e con medie di intensità molto vicine — una sfida intenzionale a basso contrasto, ideale per dimostrare il guadagno dell’apprendimento spaziale rispetto alla sogliatura puntuale.

9.5.3.2.1 Bloco 1: Generatore dell’Insieme Sintetico di Noduli e Visualizzazione Iniziale

Il generatore seguente produce coppie (immagine, maschera): l’immagine contiene una regione circolare di intensità leggermente superiore a quella dello sfondo, entrambe affette dalla stessa deviazione standard del rumore gaussiano. La maschera binaria delimita esattamente la regione del nodulo e funge da verità di riferimento (ground truth).

  1. Costruzione del Nodulo: La funzione gera_imagem_com_nodulo sovrappone il nodulo allo sfondo su una matrice \(64 \times 64\) e applica rumore gaussiano.
  2. Visualizzazione con mm.show: La Figura 9.34 illustra i primi due campioni e le rispettive maschere.
TAM_IMG = 64


def gera_imagem_com_nodulo(
    tam=TAM_IMG,
    raio_min=7,
    raio_max=15,
    media_fundo=95,
    media_nodulo=118,
    sigma_ruido=26,
    rng=None,
):
    rng = rng or np.random.default_rng()
    fundo = rng.normal(media_fundo, sigma_ruido, (tam, tam))
    nodulo = rng.normal(media_nodulo, sigma_ruido, (tam, tam))
    mascara = np.zeros((tam, tam), dtype=np.uint8)

    raio = int(rng.integers(raio_min, raio_max))
    cx = int(rng.integers(raio + 4, tam - raio - 4))
    cy = int(rng.integers(raio + 4, tam - raio - 4))

    cv2.circle(mascara, (cx, cy), raio, 255, -1)
    imagem = np.clip(np.where(mascara > 0, nodulo, fundo), 0, 255).astype(
        np.uint8
    )
    return imagem, mascara


# Generazione dei set di training e validazione
rng_dados = np.random.default_rng(42)
N_TREINO, N_VAL = 160, 40

imgs_treino, masks_treino = zip(
    *[gera_imagem_com_nodulo(rng=rng_dados) for _ in range(N_TREINO)]
)
imgs_val, masks_val = zip(
    *[gera_imagem_com_nodulo(rng=rng_dados) for _ in range(N_VAL)]
)

print(
    f"Set di training: {N_TREINO} immagini | Set di validazione: {N_VAL} immagini\n"
)

# Visualizzazione dei campioni iniziali 
mm.show(
    [imgs_treino[0], masks_treino[0], imgs_treino[1], masks_treino[1]],
    titles=["Immagine 1", "Maschera 1", "Immagine 2", "Maschera 2"],
    cols=4,
    figsize=(11, 3),
)
Set di training: 160 immagini | Set di validazione: 40 immagini
Figura 9.34: Campioni del dataset sintetico di noduli: immagine in scala di grigi sotto rumore e rispettiva maschera binaria di riferimento mostrate.
9.5.3.2.2 Bloco 2: Baseline Classica (Filtraggio, Otsu e Morfologia)

Prima di impiegare la U-Net, si valuta le prestazioni di un pipeline morfologico classico costruito con la libreria morph: uno smorzatore gaussiano (mm.blur), una soglia di Otsu (mm.threshold) e un’apertura morfologica (mm.open) per l’eliminazione di rumori isolati.

  1. Metrica di Intersezione su Unione (IoU): La funzione iou_mascaras calcola il grado di sovrapposizione pixel per pixel tra la predizione e la maschera reale.
  2. Esecuzione e Confronto: La Figura 9.35 mostra il risultato della segmentazione classica su un’immagine di test, evidenziando le limitazioni della soglia globale in condizioni di basso contrasto.
def iou_mascaras(predita, referencia):
    p, r = predita > 0, referencia > 0
    intersecao = np.logical_and(p, r).sum()
    uniao = np.logical_or(p, r).sum()
    return intersecao / uniao if uniao else 1.0


def segmenta_classico(imagem, elemento_estrutural):
    suavizada = mm.blur(imagem, 7)
    binaria = mm.threshold(suavizada)
    return mm.open(binaria, elemento_estrutural)


elemento_estrutural = mm.sedisk(5)
ious_classico = [
    iou_mascaras(segmenta_classico(img, elemento_estrutural), mask)
    for img, mask in zip(imgs_val, masks_val)
]
iou_classico_medio = float(np.mean(ious_classico))
print(
    f"IoU medio (linea di base classica) sulla validazione: {iou_classico_medio:.4f}\n"
)

predicao_classica_exemplo = segmenta_classico(imgs_val[0], elemento_estrutural)

mm.show(
    [imgs_val[0], masks_val[0], predicao_classica_exemplo],
    titles=["Immagine", "Maschera di Riferimento", "Predizione Classica"],
    cols=3,
    figsize=(9, 3.2),
)
IoU medio (linea di base classica) sulla validazione: 0.7516
Figura 9.35: Linea di base classica di segmentazione: smoothing, sogliatura di Otsu e apertura morfologica mostrate.
9.5.3.2.3 Bloco 3: Costruzione dell’architettura U-Net e funzioni di perdita

La U-Net è un’architettura a forma di “U” (da cui il nome), pensata specificamente per la segmentazione delle immagini. È composta da due percorsi che lavorano insieme:

  • 🔽 Codificatore (encoder): scende attraverso l’immagine, riducendo la risoluzione spaziale a ogni passo mentre estrae caratteristiche sempre più astratte (bordi → trame → forme → contesto).
  • 🔼 Decodificatore (decoder): risale, ricostruendo la risoluzione originale attraverso convoluzioni trasposte (upsampling), fino a generare una maschera delle stesse dimensioni dell’immagine di input.

L’elemento che rende la U-Net speciale sono le connessioni di salto (skip connections): esse trasportano le mappe delle caratteristiche dal codificatore direttamente alla fase corrispondente del decodificatore, alla stessa risoluzione. Questo evita che i dettagli fini — come contorni e bordi — si perdano durante la compressione spaziale.

Flusso generale dell’architettura:

Input
  │
  ▼
Codificatore (Conv → Conv → Pool) × 3
  │
  ├──── le connessioni di salto reintroducono mappe ad alta risoluzione  ────┐
  ▼                                                                          │
Base (collo di bottiglia)                                                    │
  │                                                                          │
  ▼                                                                          │
Decodificatore (Upsample → Concat → Conv → Conv) × 3  ◄──────────────────────┘
  │
  ▼
Output 1×1 (logits)

Componenti principali:

  1. Blocco convoluzionale base (BloccoConv) L’unità fondamentale ripetuta in tutta la rete. Applica due convoluzioni \(3 \times 3\) in sequenza, ciascuna seguita da attivazione ReLU, con padding che preserva le dimensioni spaziali dell’input. È questo blocco che appare sia nel codificatore che nel decodificatore.

  2. Convoluzione trasposta (nn.ConvTranspose2d) È l’operazione responsabile dell’upsampling nel decodificatore: invece di ridurre la risoluzione spaziale (come fa il MaxPool2d nel codificatore), la aumenta, apprendendo i pesi necessari per “annullare” la compressione e recuperare gradualmente la dimensione originale dell’immagine.

  3. Perdita combinata (BCE + Dice) La funzione perdita_segmentazione somma due metriche complementari:

    • Entropia incrociata binaria (BCE): valuta l’accuratezza pixel per pixel.
    • Coefficiente di Dice: valuta la sovrapposizione globale tra la maschera prevista e quella reale.

    Insieme, esse bilanciano la precisione locale con la fedeltà della forma segmentata nel suo complesso.

class BlocoConv(nn.Module):

    def __init__(self, canais_entrada, canais_saida):
        super().__init__()
        self.rede = nn.Sequential(
            nn.Conv2d(canais_entrada, canais_saida, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(canais_saida, canais_saida, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
        )

    def forward(self, x):
        return self.rede(x)


class UNetCompacta(nn.Module):

    def __init__(self, canais_entrada=1, base=8):
        super().__init__()
        self.enc1 = BlocoConv(canais_entrada, base)
        self.enc2 = BlocoConv(base, base * 2)
        self.enc3 = BlocoConv(base * 2, base * 4)
        self.pool = nn.MaxPool2d(2)

        self.fundo = BlocoConv(base * 4, base * 8)

        self.up3 = nn.ConvTranspose2d(
            base * 8, base * 4, kernel_size=2, stride=2
        )
        self.dec3 = BlocoConv(base * 8, base * 4)
        self.up2 = nn.ConvTranspose2d(
            base * 4, base * 2, kernel_size=2, stride=2
        )
        self.dec2 = BlocoConv(base * 4, base * 2)
        self.up1 = nn.ConvTranspose2d(
            base * 2, base, kernel_size=2, stride=2
        )
        self.dec1 = BlocoConv(base * 2, base)

        self.saida = nn.Conv2d(base, 1, kernel_size=1)

    def forward(self, x):
        e1 = self.enc1(x)
        e2 = self.enc2(self.pool(e1))
        e3 = self.enc3(self.pool(e2))
        f = self.fundo(self.pool(e3))

        d3 = self.dec3(torch.cat([self.up3(f), e3], dim=1))
        d2 = self.dec2(torch.cat([self.up2(d3), e2], dim=1))
        d1 = self.dec1(torch.cat([self.up1(d2), e1], dim=1))
        return self.saida(d1)


def para_tensores(imagens, mascaras):
    X = (
        torch.tensor(np.stack(imagens), dtype=torch.float32).unsqueeze(1)
        / 255.0
    )
    Y = (
        torch.tensor(np.stack(mascaras), dtype=torch.float32).unsqueeze(1)
        / 255.0
    )
    return X, Y


def perda_dice(logits, alvo, eps=1e-6):
    probs = torch.sigmoid(logits)
    intersecao = (probs * alvo).sum(dim=(1, 2, 3))
    uniao = probs.sum(dim=(1, 2, 3)) + alvo.sum(dim=(1, 2, 3))
    dice = (2 * intersecao + eps) / (uniao + eps)
    return 1 - dice.mean()


def perda_segmentacao(logits, alvo):
    return nn.functional.binary_cross_entropy_with_logits(
        logits, alvo
    ) + perda_dice(logits, alvo)
9.5.3.2.4 Blocco 4: Addestramento della U-Net e Valutazione delle Prestazioni

L’addestramento viene eseguito per \(35\) epoche utilizzando l’ottimizzatore Adam. Ad ogni epoca, si monitorano la Perdita di Addestramento e l’indice IoU medio sul set di validazione.

  1. Ciclo di Addestramento: I parametri vengono aggiornati con mini-batches di \(16\) campioni.
  2. Evoluzione Grafica: La Figura 9.36 mostra il grafico con il progresso della perdita e dell’IoU.
modelo_unet = UNetCompacta()
print(
    f"Parametri addestrabili della U-Net: {sum(p.numel() for p in modelo_unet.parameters())}"
)

X_treino_unet, Y_treino_unet = para_tensores(imgs_treino, masks_treino)
X_val_unet, Y_val_unet = para_tensores(imgs_val, masks_val)

otimizador_unet = optim.Adam(modelo_unet.parameters(), lr=1e-3)
n = X_treino_unet.size(0)
tam_lote = 16
epocas_unet = 35
historico_perda_unet, historico_iou_unet = [], []

for epoca in range(epocas_unet):
    if epoca % 5 == 0:  # Stampa ogni 5 epoche
        print(epoca + 1, "/", epocas_unet)
    modelo_unet.train()
    perm = torch.randperm(n)
    perda_epoca = 0.0

    for i in range(0, n, tam_lote):
        idx = perm[i : i + tam_lote]
        otimizador_unet.zero_grad()
        logits = modelo_unet(X_treino_unet[idx])
        perda = perda_segmentacao(logits, Y_treino_unet[idx])
        perda.backward()
        otimizador_unet.step()
        perda_epoca += perda.item() * len(idx)

    modelo_unet.eval()
    with torch.no_grad():
        predicao_val = (torch.sigmoid(modelo_unet(X_val_unet)) > 0.5).float()
        intersecao = (predicao_val * Y_val_unet).sum(dim=(1, 2, 3))
        uniao = ((predicao_val + Y_val_unet) > 0).float().sum(dim=(1, 2, 3))
        iou_epoca = (intersecao / uniao.clamp(min=1e-6)).mean().item()

    historico_perda_unet.append(perda_epoca / n)
    historico_iou_unet.append(iou_epoca)

iou_unet_final = historico_iou_unet[-1]
print(f"IoU medio finale della U-Net nella validazione: {iou_unet_final:.4f}")

# Grafico dell'evoluzione dell'allenamento
r = mm.showTrainCurves(historico_perda_unet, historico_iou_unet,
        titulo="Treinamento da U-Net — Segmentação de Nódulos Sintéticos",
        subtitulo="Perda no conjunto de treino e IoU médio no conjunto de validação \
            ao longo de 35 épocas")
Parametri addestrabili della U-Net: 120681
1 / 35
6 / 35
11 / 35
16 / 35
21 / 35
26 / 35
31 / 35
IoU medio finale della U-Net nella validazione: 0.8876
Figura 9.36: Evoluzione dell’allenamento della U-Net compatta: riduzione della perdita e aumento dell’indice IoU medio sul set di validazione lungo 35 epoche.
9.5.3.2.5 Blocco 5: Confronto Quantitativo e Qualitativo (Classico vs. U-Net)

Il confronto tra l’approccio classico e la U-Net rende esplicita la superiorità dell’apprendimento di rappresentazioni in scenari di basso contrasto.

  1. Pannello delle metriche: Il grafico a barre in Figura 9.37 contrappone lo IoU medio di entrambi i metodi in validazione.
  2. Visualizzazione qualitativa: Il confronto visivo su tre campioni dimostra come le connessioni di shortcut recuperino il contorno del nodulo anche in presenza di rumore accentuato.
# 1.  confronto 
print(f"IoU medio (classico Smoothing + Otsu): {iou_classico_medio:.4f}")
print(f"IoU medio (U-Net): {iou_unet_final:.4f}")

# 2. Visualizzazione qualitativa affiancata su 3 campioni tramite mm.show
imgs_comparativas = []
titulos_comparativos = []

for i in range(3):
    with torch.no_grad():
        pred_unet = (
            (torch.sigmoid(modelo_unet(X_val_unet[i : i + 1])) > 0.5)
            .float()
            .squeeze()
            .numpy()
            * 255
        )

    pred_classico = segmenta_classico(imgs_val[i], elemento_estrutural)

    imgs_comparativas.extend(
        [imgs_val[i], masks_val[i], pred_classico, pred_unet.astype(np.uint8)]
    )

    t_prefix = f"Amostra {i+1}"
    titulos_comparativos.extend(
        [
            f"{t_prefix}: Imagem",
            f"{t_prefix}: Referência",
            f"{t_prefix}: Clássico",
            f"{t_prefix}: U-Net",
        ]
    )

mm.show(
    imgs_comparativas,
    titles=titulos_comparativos,
    cols=4,
    figsize=(11, 7.5),
)
IoU medio (classico Smoothing + Otsu): 0.7516
IoU medio (U-Net): 0.8876
Figura 9.37: Confronto quantitativo (IoU medio) e qualitativo tra l’approccio classico e la U-Net addestrata su tre campioni di validazione.
Nota🧠 Perché la U-Net supera la sogliatura fissa?

La sogliatura di Otsu applica un valore di taglio globale sull’intensità locale. Quando la differenza di media tra il nodulo e lo sfondo è piccola rispetto al rumore gaussiano, questa regola commette errori sistematici ai bordi.

La U-Net supera questa limitazione combinando l’ampio contesto semantico estratto dall’encoder con i dettagli spaziali fini preservati dalle connessioni di salto. Ciò consente di identificare la presenza del nodulo e di delinearne i contorni con precisione, anche in presenza di rumore intenso.

9.5.4 Ingegneria dei Dati per la Visione Artificiale (Roboflow)

Una U-Net può essere addestrata a partire da immagini annotate su piattaforme di ingegneria dei dati per la Visione Artificiale (VA), come Roboflow. Queste piattaforme consentono di organizzare set di dati, eseguire annotazioni, applicare fasi di pre-elaborazione e data augmentation, addestrare modelli ed esportare i dati in diversi formati. In questa sezione, tuttavia, l’esempio riprende la rilevazione di oggetti geometrici, utilizzando set di dati già presentati in questo libro.

ImportanteDipendenza da connessione e chiave API

Le celle di questa sezione richiedono una connessione a Internet e una chiave API gratuita di Roboflow (app.roboflow.com). Nel Workspace del progetto, accedi a ⚙ → Roboflow API e copia la Private API Key.

Crea, in questa cartella, il file chave_roboflow.txt contenente solo la chiave, senza virgolette. Un modello di questo file è disponibile in chave_roboflow.txt.exemplo.

Aggiungi chave_roboflow.txt al file .gitignore, poiché contiene una credenziale di accesso che non deve essere versionata né condivisa.

9.5.4.1 Rilevamento di oggetti utilizzando Roboflow

Roboflow consente di eseguire inferenze su immagini locali, permettendo di valutare le prestazioni del modello ospitato nell’identificazione degli oggetti di interesse.

Oltre all’inferenza, il dataset può essere esportato nel formato png-mask-semantic, in cui ogni immagine è accompagnata da una maschera di segmentazione semantica. In questa maschera, ogni pixel rappresenta la classe a cui appartiene l’oggetto corrispondente. Le coppie immagine-maschera vengono utilizzate come dati di addestramento per la UNetCompacta.

9.5.4.2 Connessione, download e verifica del dataset

Il codice stabilisce una connessione con il Workspace mctest e il progetto geometric-test00, versione 6, ed esegue il download del dataset in dados/datasetRoboFlow. Successivamente, verifica la shape delle immagini in ciascuno split. La funzione di verifica viene riutilizzata successivamente nella sezione.

from roboflow import Roboflow
from pathlib import Path
from PIL import Image
from collections import Counter

def contar_shapes(raiz, splits=("train", "valid", "test")):
    """Conta la shape (altezza, larghezza, canali) delle immagini per split."""
    for split in splits:
        pasta = raiz / split / "images"
        if not pasta.exists():
            print(f"{split}: cartella non trovata")
            continue

        shapes = Counter()
        for arquivo in pasta.iterdir():
            if arquivo.is_file():
                with Image.open(arquivo) as img:
                    shapes[(img.height, img.width, len(img.getbands()))] += 1

        txt = ", ".join(f"{s}: {n}" for s, n in shapes.items())
        print(f"{split}: {txt}")


chave = Path("chave_roboflow.txt")

if not chave.exists():
    print("Chiave Roboflow non trovata: chiave_roboflow.txt")
else:
    with open(chave) as f:
        api_key = f.read().strip()

    # Progetto:
    # https://app.roboflow.com/mctest/geometric-test00/models
    # geometric-test00/6

    rf = Roboflow(api_key=api_key)
    projeto = rf.workspace("mctest").project("geometric-test00")
    versao = projeto.version(6)

    print(
        f"ID: {versao.version} | Nome: {versao.name} | "
        f"Immagini: {versao.images}"
    )

    raiz = Path("dados/datasetRoboFlow")
    versao.download("yolov8", location=str(raiz))

    print("Dataset:", raiz)
    contar_shapes(raiz)

9.5.4.3 Scaricare il dataset in modo riproducibile (alternativa)

In alternativa al dataset ottenuto tramite Roboflow, è possibile utilizzare un dataset reso disponibile in un repository GitHub, anch’esso organizzato negli stessi splits e contenente le stesse classi di oggetti. I set di dati, tuttavia, non sono identici: le immagini su GitHub hanno una risoluzione di 608×608 pixel, mentre le immagini esportate da Roboflow hanno 640×640 pixel.

Il codice seguente esegue il download del dataset da GitHub, nel caso in cui non sia già disponibile localmente, e riutilizza contar_shapes per verificare le dimensioni delle immagini in ciascuno split.

import os

if not os.path.exists("dados/dataset"):
    cmd = (
        "git clone --no-checkout --depth 1 --filter=blob:none "
        "https://github.com/fzampirolli/pdi-vc.git tmp_repo && "
        "cd tmp_repo && git sparse-checkout set all/cap09/dados/dataset "
        "&& git checkout && cd .. && mkdir -p dados && "
        "cp -r tmp_repo/all/cap09/dados/dataset dados/dataset && "
        "rm -rf tmp_repo"
    )
    !{cmd}

if not chave.exists():
    print("Chave do Roboflow não encontrada: chave_roboflow.txt")
else:
  versao_recente = projeto.versions()[-1]
  print(f"Versão mais recente: {versao_recente.version.split('/')[-1]}")

  contar_shapes(Path("dados/dataset"))

9.5.4.4 Confronto di un’immagine da ciascun dataset

I due dataset contengono immagini con risoluzioni diverse: 608×608 su GitHub e 640×640 su Roboflow. Per un confronto visivo diretto, le immagini vengono ridimensionate alla stessa dimensione prima di essere mostrate affiancate (Figura 9.38).

import cv2

if not chave.exists():
    print("Chiave Roboflow non trovata: chave_roboflow.txt")
else:
    caminho1 = next((raiz / "train/images").iterdir())
    caminho2 = next((Path("dados/dataset") / "train/images").iterdir())

    img1 = mm.read(str(caminho1))
    img2 = mm.read(str(caminho2))

    # Ridimensiona entrambe alla stessa dimensione (la più piccola tra le due)
    largura = min(img1.shape[1], img2.shape[1])
    altura = min(img1.shape[0], img2.shape[0])
    img1_r = cv2.resize(img1, (largura, altura))
    img2_r = cv2.resize(img2, (largura, altura))

    mm.show(
        [img1_r, img2_r],
        title=[f"Roboflow {img1.shape}", f"GitHub {img2.shape}"],
    )
Figura 9.38

9.5.4.5 Inferenza con il modello addestrato

Il modello addestrato nella versione 6 viene utilizzato per eseguire l’inferenza su un’immagine di test locale. La previsione considera le soglie di confidenza e di sovrapposizione impiegate dalla soppressione non massima (Non-Maximum Suppression, NMS), e il risultato viene presentato nell’immagine annotata della Figura 9.39.

# version.model è deprecato; usare version.models()

if not chave.exists():
    print("Chiave Roboflow non trovata: chave_roboflow.txt")
else:
    modelo = versao.models()[0]

    img_path = "dados/dataset/test/images/00001.jpg"
    pred = modelo.predict(img_path, confidence=40, overlap=30)
    resp = pred.json()  # include le caselle rilevate in resp["predictions"]

    altura, largura, _ = mm.read(img_path).shape
    print("Dimensioni dell'immagine di test:", (altura, largura))

    pred.save("resultado.jpg")  # immagine annotata

    mm.show(
        mm.read("resultado.jpg"),
        title="Risultato dell'inferenza con il modello di Roboflow",
        figsize=(6, 6)
    )
Figura 9.39

9.5.4.6 Valutando le predizioni con IoU e classe

Roboflow restituisce ogni riquadro con le coordinate del centro (x, y) in pixel e la classe prevista, mentre le etichette locali (dati/dataset/test/labels/00001.txt) seguono il formato YOLO, con centro e dimensioni normalizzati nell’intervallo [0, 1]. Prima del confronto tramite mm.IoU, i riquadri devono essere convertiti nello stesso formato, con le coordinate dell’angolo superiore sinistro e le dimensioni espresse in pixel.

Una predizione è considerata corretta solo quando la classe prevista coincide con la classe del riquadro reale e la sua Intersection over Union (IoU) è maggiore o uguale alla soglia definita, adottando, in questo esempio, 0,5 (50%) come valore predefinito.

ImportanteIl class_id di Roboflow non corrisponde all’indice delle label locali

Nell’esportazione, Roboflow riordina le classi in ordine alfabetico nel data.yaml, indipendentemente dall’ordine utilizzato nel progetto originale, mantenuto nel data.yaml del GitHub. Così, class_id = 0 corrisponde a Circulo nella risposta dell’API, mentre lo stesso indice corrisponde a Triangulo nelle label locali.

Pertanto, il confronto deve essere effettuato tramite il nome della classe (p["class"]), convertendolo successivamente nell’indice corrispondente nella lista locale. I class_id non devono essere confrontati direttamente.

# resp, largura e altura sono stati definiti nella cella precedente

# Ordine delle classi usato nelle etichette locali (dati/dataset/*/labels/*.txt)
CLASSES_LOCAIS = ["Triangulo", "Quadrado", "Pentagono", "Hexagono",
                   "Heptagono", "Circulo", "Elipse"]

def predicao_correta(pred: tuple, real: tuple, limiar: float = 0.5) -> bool:
    """Vero se stessa classe e mm.IoU(scatola_pred, scatola_reale) >= soglia."""
    classe_pred, caixa_pred = pred
    classe_real, caixa_real = real
    return classe_pred == classe_real and mm.IoU(caixa_pred, caixa_real) >= limiar

def caixa_roboflow(p: dict) -> tuple:
    """Converte la predizione di Roboflow in (classe, (x, y, w, h))."""
    caixa = (p["x"] - p["width"] / 2, p["y"] - p["height"] / 2,
             p["width"], p["height"])
    # usa il nome della classe (non il class_id!) per corrispondere all'ordine locale
    classe = CLASSES_LOCAIS.index(p["class"])
    return (classe, caixa)

def carrega_labels_yolo(caminho_txt: str, largura: int, altura: int) -> list:
    """Legge etichette YOLO (normalizzate) e le converte in (classe, (x, y, w, h))."""
    caixas = []
    with open(caminho_txt) as f:
        for linha in f:
            classe, xc, yc, w, h = map(float, linha.split())
            w_px, h_px = w * largura, h * altura
            x_px = xc * largura - w_px / 2
            y_px = yc * altura - h_px / 2
            caixas.append((int(classe), (x_px, y_px, w_px, h_px)))
    return caixas

if not chave.exists():
    print("Chiave Roboflow non trovata: chiave_roboflow.txt")
else:
    caixas_pred = [caixa_roboflow(p) for p in resp["predictions"]]
    caixas_real = carrega_labels_yolo(
        "dados/dataset/test/labels/00001.txt", largura, altura
    )

    acertos = sum(
        any(predicao_correta(cp, cr, limiar=0.5) for cr in caixas_real)
        for cp in caixas_pred
    )
    print(f"{acertos}/{len(caixas_pred)} predizioni corrette (classe + IoU >= 50%)")

Per visualizzare il risultato, ogni previsione viene disegnata sull’immagine: in verde quando è un successo (classe + IoU ≥ soglia) e in rosso quando è un errore, come mostra la Figura 9.40.

import cv2

VERDE, VERMELHO = (0, 255, 0), (255, 0, 0)

if not chave.exists():
    print("Chave do Roboflow não encontrada: chave_roboflow.txt")
else:
    img_acertos = mm.read(img_path).copy()

    if not chave.exists():
        print("Chave do Roboflow não encontrada: chave_roboflow.txt")
    else:
        for cp in caixas_pred:
            classe_pred, (x, y, w, h) = cp
            correta = any(predicao_correta(cp, cr, limiar=0.5) for cr in caixas_real)
            cor = VERDE if correta else VERMELHO

            p1, p2 = (int(x), int(y)), (int(x + w), int(y + h))
            cv2.rectangle(img_acertos, p1, p2, cor, 2)
            cv2.putText(img_acertos, str(classe_pred), (p1[0], p1[1] - 5),
                        cv2.FONT_HERSHEY_SIMPLEX, 0.5, cor, 2)

    mm.show(
        img_acertos,
        title=f"{acertos}/{len(caixas_pred)} predições corretas "
            f"(classe + IoU >= 50%)",
        figsize=(6, 6)
    )
Figura 9.40

9.5.5 Applicazioni Geometriche e Integrate

Il capitolo si conclude integrando due pilastri della VC: la geometria proiettiva (studiata nei Capitoli 6 e 8) e l’apprendimento profondo. La combinazione di questi approcci supporta applicazioni pratiche nel mondo reale, come illustrato di seguito.

9.5.5.1 Realtà Aumentata con Marcatori e Omografia

Immagina una telecamera puntata su un tavolo dove qualcuno ha incollato un piccolo marker ArUco. A seconda dell’angolazione della telecamera, questo marker appare ruotato, inclinato, in prospettiva — mai perfettamente quadrato. È proprio questa distorsione che l’omografia sa “leggere” e annullare (o, nel nostro caso, replicare per una nuova immagine).

Il flusso completo di un’applicazione di RA basata su marcatori segue tre passaggi:

  1. Ambientazione: il marker viene inserito in una scena reale, subendo una trasformazione di prospettiva (simulando l’angolazione della telecamera).
  2. Rilevamento: l’algoritmo localizza il marker nella scena e recupera le coordinate esatte dei suoi 4 angoli con cv2.aruco.ArucoDetector.
  3. Sostituzione: con l’omografia tra il marker “ideale” e il marker “rilevato”, si proietta una nuova immagine virtuale esattamente sull’area del marker — come se si fosse trasformato in una finestra verso un altro contenuto, come mostrato in Figura 9.41.
Nota

Dettaglio tecnico importante: l’ArUco necessita di un margine bianco attorno al pattern (la “zona di silenzio”) affinché il rilevatore possa distinguere il marker dallo sfondo. Per questo motivo, il codice seguente aggiunge un bordo con cv2.copyMakeBorder e utilizza l’interpolazione cv2.INTER_NEAREST quando deforma l’immagine, evitando che la rotazione sfumi i piccoli quadrati bianchi e neri e impedisca il rilevamento.

# 1. Generazione del marker ArUco sintetico, già con margine bianco (quiet zone)
# → questo margine è essenziale affinché il rilevatore riesca a "vedere" il marker
dic = cv2.aruco.getPredefinedDictionary(cv2.aruco.DICT_4X4_50)
aruco_bruto = cv2.aruco.generateImageMarker(dic, 7, 200)
aruco_gray = cv2.copyMakeBorder(
    aruco_bruto, 40, 40, 40, 40, cv2.BORDER_CONSTANT, value=255
)  # 200 -> 280px, con 40px di cornice bianca su ogni lato
aruco = cv2.cvtColor(aruco_gray, cv2.COLOR_GRAY2BGR)
lado = aruco.shape[0]  # 280

# 2. Scena reale di sfondo, usando un'immagine di esempio da skimage.data
fundo = cv2.cvtColor(skdata.coffee(), cv2.COLOR_RGB2BGR)
cena = cv2.resize(fundo, (640, 480))

# Angoli del marker "frontale" (src) e la sua posizione ruotata/inclinata nella scena (dst)
src = np.float32([[0, 0], [lado, 0], [lado, lado], [0, lado]])
dst = np.float32([[190, 160], [420, 70], [470, 330], [150, 370]])  # rotazione + prospettiva

# 3. Proietta il marker (con bordi nitidi) sulla scena reale
H_cena, _ = cv2.findHomography(src, dst)
mask_cena = cv2.warpPerspective(
    np.full((lado, lado), 255, np.uint8), H_cena, (640, 480),
    flags=cv2.INTER_NEAREST,
)
cena[mask_cena > 0] = cv2.warpPerspective(
    aruco, H_cena, (640, 480), flags=cv2.INTER_NEAREST
)[mask_cena > 0]

# 4. Rilevamento del marker all'interno della scena (come farebbe una telecamera)
det = cv2.aruco.ArucoDetector(dic, cv2.aruco.DetectorParameters())
corners, ids, _ = det.detectMarkers(cena)

assert ids is not None and len(corners) > 0, \
    "Marcador não detectado — confira iluminação/contraste da cena."

# 5. Immagine virtuale (un'altra immagine da skimage.data) che "sostituirà" il marker
# Nota: usiamo il quadrato INTERNO del marker (senza margine) come area di proiezione,
# quindi l'omografia dell'immagine virtuale usa 'src' originale (200x200), non il 'lato' con bordo
src_interno = np.float32([[0, 0], [200, 0], [200, 200], [0, 200]])
virtual = cv2.resize(
    cv2.cvtColor(skdata.camera(), cv2.COLOR_RGB2BGR), (200, 200)
)

# Gli angoli rilevati corrispondono al marker CON il margine (280x280),
# quindi ricalcoliamo H_ra usando 'src' con margine, per mantenere la proiezione coerente
H_ra, _ = cv2.findHomography(src, corners[0][0])

# L'omografia rilevata viene applicata all'immagine virtuale (ridimensionata a 'lato')
virtual_grande = cv2.resize(virtual, (lado, lado))
ra = cena.copy()
mask_ra = cv2.warpPerspective(
    np.full((lado, lado), 255, np.uint8), H_ra, (640, 480), flags=cv2.INTER_NEAREST
)
ra[mask_ra > 0] = cv2.warpPerspective(
    virtual_grande, H_ra, (640, 480), flags=cv2.INTER_NEAREST
)[mask_ra > 0]

# Visualizzazione: scena con marker vs. scena con Realtà Aumentata applicata
mm.show(
    [cv2.cvtColor(cena, cv2.COLOR_BGR2RGB), cv2.cvtColor(ra, cv2.COLOR_BGR2RGB)],
    titles=["Marker nella Scena Reale (ruotato)", "Sovrapposizione Virtuale tramite Omografia"],
    cols=2,
    figsize=(9, 4),
)
Figura 9.41: Realtà aumentata basata su marker ArUco: marker inserito in scena reale e ruotato, rilevato e sostituito con immagine virtuale tramite omografia.

Riepilogo del pipeline:

Fase Funzione Funzione chiave
1. Generazione Marker ArUco con margine bianco generateImageMarker + copyMakeBorder
2. Ambientazione Inserisce marker distorto nella scena findHomography + warpPerspective
3. Rilevamento Localizza marker e restituisce angoli ArucoDetector.detectMarkers
4. Sostituzione Proietta immagine virtuale sul marker findHomography + warpPerspective

💡 Lezione: è comune nella visione artificiale che il rilevatore “non trovi nulla”. Chiediti sempre: “ho fornito abbastanza contrasto e spazio?” — vale per ArUco, codici QR e riconoscimento facciale.

9.5.5.2 Fotogrammetria e Riferimento di Scala

La fotogrammetria consente di stimare le dimensioni fisiche degli oggetti a partire da immagini digitali. A tal fine, si utilizza un oggetto di riferimento con dimensioni note, posizionato nella stessa scena dell’oggetto di interesse. Questa procedura stabilisce una relazione tra le distanze misurate in pixel e le corrispondenti dimensioni nel mondo reale.

Si consideri, ad esempio, una carta di credito, le cui dimensioni seguono lo standard internazionale ISO/IEC 7810. Poiché la sua larghezza è esattamente 8,56 cm, è sufficiente determinare quanti pixel occupa tale larghezza nell’immagine per calcolare il fattore di conversione tra pixel e centimetri. Se la carta corrisponde a 140 pixel, allora ogni pixel rappresenterà approssimativamente 0,061 cm. Questo stesso fattore di scala può essere applicato per stimare le dimensioni di qualsiasi altro oggetto situato nello stesso piano della scena, come illustrato in Figura 9.42..

La procedura può essere suddivisa in due fasi principali:

  1. Segmentazione e bounding box: individuare nell’immagine sia l’oggetto di riferimento sia l’oggetto di interesse, utilizzando tecniche come la segmentazione per colore, la sogliatura, il rilevamento dei contorni o metodi di rilevamento degli oggetti.
  2. Conversione in dimensioni fisiche: calcolare il rapporto \(\mathrm{cm/pixel}\) a partire dalla larghezza nota dell’oggetto di riferimento e utilizzarlo per convertire le misure dell’oggetto di interesse da pixel a centimetri.
Nota

Condizione per misurazioni affidabili

La conversione tra pixel e centimetri presuppone che l’oggetto di riferimento e l’oggetto di interesse si trovino approssimativamente sullo stesso piano e alla stessa distanza dalla fotocamera. In queste condizioni, la scala rimane pressoché costante in tutta l’immagine. Differenze di profondità, inclinazione della fotocamera o distorsioni dell’obiettivo possono introdurre errori nelle misure stimate.

COR_REFERENCIA = (200, 200, 200)  # Carta di riferimento (grigia)
COR_OBJETO = (60, 60, 220)  # Oggetto bersaglio (rosso)

# Disegno della scena sintetica
cena_medicao = np.full((300, 500, 3), 255, dtype=np.uint8)
cv2.rectangle(
    cena_medicao, (30, 200), (30 + 140, 200 + 88), COR_REFERENCIA, -1
)
cv2.rectangle(cena_medicao, (250, 100), (250 + 220, 100 + 150), COR_OBJETO, -1)


def caixa_delimitadora_por_cor(imagem_bgr, cor_bgr, tolerancia=40):
    diferenca = np.abs(imagem_bgr.astype(int) - np.array(cor_bgr)).sum(axis=2)
    mascara = (diferenca < tolerancia).astype(np.uint8) * 255
    contornos, _ = cv2.findContours(
        mascara, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE
    )
    maior_contorno = max(contornos, key=cv2.contourArea)
    return cv2.boundingRect(maior_contorno)


x_ref, y_ref, w_ref_px, h_ref_px = caixa_delimitadora_por_cor(
    cena_medicao, COR_REFERENCIA
)
x_obj, y_obj, w_obj_px, h_obj_px = caixa_delimitadora_por_cor(
    cena_medicao, COR_OBJETO
)

# Calcolo della scala fisica
LARGURA_REFERENCIA_CM = 8.56
razao_cm_por_px = LARGURA_REFERENCIA_CM / w_ref_px
largura_obj_cm = w_obj_px * razao_cm_por_px
altura_obj_cm = h_obj_px * razao_cm_por_px

# Disegno delle scatole e delle misurazioni stimate
resultado = cena_medicao.copy()
cv2.rectangle(
    resultado, (x_ref, y_ref), (x_ref + w_ref_px, y_ref + h_ref_px), (0, 180, 0), 2
)
cv2.rectangle(
    resultado, (x_obj, y_obj), (x_obj + w_obj_px, y_obj + h_obj_px), (0, 180, 0), 2
)

cv2.putText(
    resultado,
    f"{LARGURA_REFERENCIA_CM:.2f} cm",
    (x_ref, y_ref - 8),
    cv2.FONT_HERSHEY_SIMPLEX,
    0.55,
    (0, 120, 0),
    2,
)

cv2.putText(
    resultado,
    f"{largura_obj_cm:.1f} x {altura_obj_cm:.1f} cm",
    (x_obj, y_obj - 8),
    cv2.FONT_HERSHEY_SIMPLEX,
    0.6,
    (0, 120, 0),
    2,
)

mm.show(
    [
        cv2.cvtColor(cena_medicao, cv2.COLOR_BGR2RGB),
        cv2.cvtColor(resultado, cv2.COLOR_BGR2RGB),
    ],
    titles=[
        "Scena Originale",
        "Misurazione tramite Riferimento di Scala (Centimetri)",
    ],
    cols=2,
    figsize=(9, 4),
)
Figura 9.42: Misurazione di dimensioni fisiche reali utilizzando una carta di riferimento di scala nota (8,56 cm) renderizzata. Il rettangolo grigio rappresenta la carta di riferimento e il rettangolo blu rappresenta l’oggetto bersaglio. Le dimensioni stimate dell’oggetto sono visualizzate in centimetri.

Sintesi del pipeline:

Fase Funzione Funzione chiave
1. Scena sintetica Disegna la carta di riferimento e l’oggetto target con colori distinti cv2.rectangle
2. Segmentazione Isola ciascun oggetto per colore e ne estrae il contorno cv2.findContours
3. Bounding Box Ottiene il riquadro delimitatore (posizione e dimensioni in pixel) di ciascun oggetto cv2.boundingRect
4. Ridimensionamento Converte i pixel in centimetri usando la larghezza nota della carta Regola del tre: \(\text{cm/pixel} = \dfrac{8{,}56}{w_{ref\_px}}\)
5. Annotazione Disegna i riquadri e mostra le misure stimate sull’immagine cv2.rectangle + cv2.putText

💡 Applicazione nel mondo reale: questa è esattamente la tecnica usata dalle app di e-commerce che stimano la dimensione di un prodotto a partire da una foto scattata accanto a una carta, da sistemi agricoli che misurano frutta su nastri trasportatori, e persino da perizie forensi che calcolano le dimensioni di tracce su scene del crimine — tutto con la stessa idea: un righello noto all’interno della stessa foto.

9.6 Riassunto

Questo capitolo, che chiude la Parte II del libro, ha presentato:

  • Convoluzione e pooling appresi: la stessa operazione matematica di convoluzione del Capitolo 3, ma con kernel trattati come parametri regolati mediante addestramento, anziché definiti manualmente;

  • Condivisione dei pesi e gerarchia delle caratteristiche come proprietà che rendono le CNN efficienti e capaci di apprendere rappresentazioni sempre più astratte in livelli successivi;

  • Addestramento di una CNN da zero, con prestazioni paragonabili — e non necessariamente superiori — ai classificatori classici del Capitolo 7 su una base piccola e semplice, a sottolineare che la scelta del metodo deve essere proporzionale alla complessità reale del problema;

  • Transfer learning, dimostrato sperimentalmente come una strategia efficace per compiti con pochi dati etichettati, riutilizzando un estrattore di caratteristiche già addestrato su un compito correlato, e le sue limitazioni, evidenziate dal transfer negativo tra domini molto diversi;

  • Applicazioni su larga scala con modelli pre-addestrati di classificazione, rilevamento (Faster R-CNN) e segmentazione (DeepLabV3), seguendo lo stesso principio di transfer learning su scala industriale;

  • Transfer learning applicato al rilevamento di oggetti, adattando un YOLO pre-addestrato su COCO per localizzare e classificare oggetti geometrici sintetici, illustrando lo stesso principio di congelamento parziale in un dominio di origine e destinazione ancora più distanti tra loro;

  • Segmentazione semantica con U-Net, implementata e addestrata da zero su un insieme sintetico a basso contrasto, superando una linea di base classica di sogliatura grazie alle connessioni di skip tra codificatore e decodificatore;

  • Ingegneria dei dati per la Visione Artificiale con Roboflow, utilizzando un dataset e un modello pre-addestrato per eseguire inferenza nel rilevamento di oggetti geometrici, oltre a confrontare insiemi di dati con diverse risoluzioni, ma con le stesse classi di oggetti;

  • L’integrazione di geometria computazionale (omografia e calibrazione) e deep learning in due applicazioni reali che chiudono il libro: realtà aumentata e fotogrammetria.

9.7 🤖 Uso del Gemini Notebook come Tutor Complementare

In questa edizione, l’uso del Gemini Notebook è incoraggiato come strumento complementare di apprendimento. Basato sull’intelligenza artificiale, il sistema utilizza esclusivamente i documenti forniti dall’autore come fonte di conoscenza, producendo risposte allineate ai contenuti e all’approccio adottato nel corso di questo capitolo.

Importante🎓 Studia con il Tutor Intelligente

🚀 ACCEDI AL GEMINI NOTEBOOK: CAPITOLO 09

🌐 Lingua e Linguaggio di Programmazione

Il progetto di questo capitolo nel Gemini Notebook è stato realizzato esclusivamente con il testo in portoghese e gli esempi di codice in Python. Se stai studiando utilizzando l’edizione in inglese o francese, o seguendo il percorso in C++, le risposte del tutor potrebbero non corrispondere esattamente alla versione che stai leggendo.

⚠️ Avvertenza sul Contenuto Generato dall’IA

Sebbene sia uno strumento prezioso di supporto allo studio, il Gemini Notebook può talvolta produrre risposte incomplete, imprecise o errate. Si consiglia di validare le informazioni consultando il materiale del capitolo, libri, articoli scientifici e altre fonti accademiche affidabili. Quando possibile, esegui e sperimenta gli esempi pratici presentati nel corso del testo per consolidare la comprensione dei concetti.

9.8 Elenco di Esercizi

Gli esercizi seguenti consolidano i concetti presentati in questo capitolo tramite adattamenti, esperimenti ed estensioni degli algoritmi sviluppati nel testo, utilizzando le librerie PyTorch, ultralytics e la libreria didattica morph.

  1. (10%) Indagare l’impatto della profondità in un’architettura convoluzionale. Partendo dalla rete a due strati del Progetto Pratico 1, aggiungere un terzo strato convoluzionale con 32 filtri prima degli strati completamente connessi. Addestrare la nuova architettura mantenendo lo stesso numero di epoche e la stessa suddivisione dei dati. Confrontare l’accuratezza sul set di test e il numero totale di parametri addestrabili rispetto alla rete originale, discutendo se l’aumento di profondità abbia apportato un beneficio misurabile per immagini di dimensione \(8 \times 8\).

  2. (15%) Valutare la soglia di dati necessari nel dominio di destinazione affinché l’addestramento di una CNN da zero diventi competitivo con il transfer learning. Variando il numero di campioni di addestramento disponibili nel dominio B tra \(\{5, 10, 20, 40, 80\}\), misurare l’accuratezza di test per entrambe le strategie. Presentare i risultati in un grafico a linee e determinare a partire da quale volume di dati l’addestramento da zero raggiunge prestazioni equivalenti all’estrattore pre-addestrato.

  3. (15%) Indagare la strategia di fine-tuning parziale rispetto al congelamento totale dei pesi. Nello scenario di transfer learning tra domini di cifre, scongelare il secondo strato convoluzionale (conv2) dell’estrattore affinché venga aggiornato insieme alla testa di classificazione durante l’addestramento nel dominio B. Confrontare l’accuratezza ottenuta con il congelamento totale e con l’addestramento da zero, discutendo il compromesso tra capacità di adattamento e rischio di overfitting.

  4. (20%) Valutare l’influenza della profondità del congelamento (freeze) sulle prestazioni dei rilevatori YOLO sottoposti a transfer learning. Utilizzando il set di dati sintetico di forme geometriche, eseguire il fine-tuning variando il parametro di congelamento del backbone per \(\{0, 5, 10, 15\}\). Registrare la metrica \(\text{mAP}_{50}\) sul set di validazione per ogni configurazione, presentare i dati in una tabella e discutere se il congelamento parziale sia vantaggioso quando i domini di origine (COCO) e di destinazione (forme geometriche) sono significativamente distinti.

  5. (20%) Studiare l’importanza delle connessioni di salto (skip connections) nell’architettura U-Net per la segmentazione semantica. Implementare una variazione UNetSenzaSalti che funzioni come un autoencoder convoluzionale tradizionale, rimuovendo le concatenazioni tra gli stadi dell’encoder e del decoder. Addestrare entrambi i modelli sulla stessa base di noduli sintetici, confrontare l’IoU medio sul set di validazione e presentare visivamente la differenza nella precisione dei bordi segmentati da ciascun metodo.

  6. (20%) — Sfida: segmentazione semantica con Roboflow. Utilizzare un progetto Roboflow di tipo instance segmentation, contenente le sette classi di forme geometriche utilizzate in questo capitolo. Esportare il dataset nel formato coco-segmentation e sviluppare una procedura per convertire i poligoni memorizzati nei file _annotations.coco.json in maschere semantiche multiclasse, in cui ogni pixel riceve l’indice della classe corrispondente e il valore 0 rappresenta lo sfondo. Utilizzare le immagini e le maschere risultanti per addestrare la UNetCompatta. Valutare l’IoU medio sul set di test e confrontare visivamente le maschere previste con le annotazioni originali. Discutere le principali difficoltà incontrate nella conversione delle annotazioni COCO in maschere e gli effetti di oggetti sovrapposti o appartenenti a classi diverse.

  7. (Bonus – 10%) Sviluppare un sistema interattivo che combini rilevamento di oggetti (YOLO) con misurazione tramite riferimento di scala (fotogrammetria). Addestrare il rilevatore per identificare due classi in una scena: una “Carta di Riferimento” (dimensione nota di \(8{,}56\text{ cm} \times 5{,}39\text{ cm}\)) e un “Oggetto Target”. Durante l’inferenza su una nuova immagine, utilizzare la dimensione in pixel della bounding box della carta rilevata per convertire le dimensioni della scatola dell’oggetto target in centimetri. Visualizzare l’immagine processata con le etichette di classe, la probabilità di confidenza e le dimensioni fisiche stimate sovrapposte.

  8. (Bonus – 10%) Sviluppare un sistema di stima della profondità tramite visione stereo a partire da due immagini della stessa scena acquisite da posizioni diverse, simulando una coppia di telecamere stereo. Considerare nota la distanza tra le due posizioni di acquisizione (baseline).

    Utilizzare uno dei metodi di rilevamento di oggetti presentati nel capitolo, come YOLO, per localizzare gli oggetti di interesse nelle due immagini. Per ogni rilevamento, stabilire la corrispondenza tra lo stesso oggetto nelle due posizioni e determinare la sua disparità. A partire dalla disparità, dalla baseline e dai parametri della telecamera, utilizzare la geometria stereo per stimare la distanza di ciascun oggetto rispetto alle telecamere.

    Come estensione della libreria didattica morph, modificare il metodo showBoundBox affinché, oltre alla classe e alla confidenza del rilevamento, presenti su ogni bounding box la distanza stimata dell’oggetto. Il risultato deve consentire di visualizzare, direttamente nelle immagini, la classe, l’accuratezza (confidenza) e la profondità di ciascun oggetto rilevato.

    Presentare le due immagini con i rilevamenti, le corrispondenze tra gli oggetti, l’immagine di disparità e una rappresentazione della profondità stimata. Discutere come la distanza tra le telecamere, la precisione del rilevamento e della corrispondenza, la risoluzione delle immagini e la posizione dell’oggetto nella scena influenzino la qualità della stima.

    Per la validazione, utilizzare almeno un oggetto la cui distanza dalla telecamera sia nota. Confrontare la profondità stimata con il valore reale e riportare l’errore assoluto e l’errore relativo. Discutere inoltre le limitazioni del metodo quando un oggetto non viene rilevato correttamente in entrambe le immagini o quando la corrispondenza tra le regioni osservate è ambigua.

9.9 Chiusura della Parte II

Questo capitolo conclude la Parte II del libro e chiude la sequenza di contenuti iniziata nel Capitolo 6, dedicata alla rappresentazione, rilevazione, descrizione e corrispondenza delle caratteristiche nelle immagini. Nel corso di questi capitoli, sono stati presentati metodi classici di CV basati su caratteristiche progettate manualmente, come Sobel, LBP, HOG, ORB e Haar Cascade, nonché metodi fondati su caratteristiche apprese automaticamente, rappresentati dalle CNN.

Gli esempi e gli esperimenti sviluppati evidenziano che nessuno di questi approcci è universalmente superiore. La scelta della tecnica più adeguata dipende dalle caratteristiche del problema, dalla disponibilità di dati per l’addestramento, dai requisiti di precisione e dai vincoli computazionali dell’applicazione. In problemi ben strutturati e con pochi dati, i descrittori classici offrono spesso soluzioni semplici ed efficienti. Al contrario, compiti più complessi tendono a trarre beneficio dalla capacità di apprendimento offerta dalle CNN.

Diverse direzioni di studio possono approfondire i concetti presentati in questa parte del libro, tra le quali si distinguono:

  • Architetture moderne di CNN, come ResNet, EfficientNet e Vision Transformers, che ampliano la capacità di rappresentazione e le prestazioni in compiti di classificazione e riconoscimento visivo;
  • Rilevazione e segmentazione di oggetti, con particolare attenzione alla famiglia YOLO e ai modelli di segmentazione basati su prompt, come Segment Anything;
  • Ricostruzione tridimensionale e SLAM (Simultaneous Localization and Mapping), che utilizzano più immagini per stimare la geometria della scena e la traiettoria di telecamere in movimento;
  • Modelli generativi di immagini, come le reti generative avversarie (GAN) e i modelli di diffusione, capaci di sintetizzare immagini realistiche a partire da esempi o descrizioni testuali.

Le basi sviluppate nel corso della Parte II costituiscono il fondamento per queste e altre aree avanzate della CV, nelle quali la rappresentazione adeguata delle informazioni visive rimane l’elemento centrale per l’analisi e la comprensione delle immagini.

Riferimenti del Capitolo

I concetti e gli algoritmi presentati in questo capitolo sono stati fondati su riferimenti classici e contemporanei della letteratura sul Deep Learning applicato alla VC:

  • Mcculloch (1943), per la proposta della prima astrazione matematica e logica del neurone artificiale, che getta le basi concettuali dell’elaborazione neurale computazionale.
  • Rosenblatt (1958), per la formulazione originale del Perceptron, modello precursore del neurone artificiale utilizzato nelle architetture moderne di deep learning.
  • Goodfellow (2016) e Lecun (2015), per i fondamenti delle reti neurali, della convoluzione, delle funzioni di attivazione e dell’addestramento di modelli profondi.
  • Bishop (2006), per i concetti rigorosi di riconoscimento di pattern, probabilità, stima di massima verosimiglianza e metodi statistici applicati al machine learning.
  • Ronneberger (2015) per l’architettura U-Net, utilizzata nella segmentazione semantica con connessioni di skip tra codificatore e decodificatore.
  • Redmon (2016), per l’architettura YOLO (You Only Look Once), utilizzata negli esperimenti di rilevamento degli oggetti con transfer learning.
  • Ren (2015), per l’architettura Faster R-CNN, impiegata come modello pre-addestrato per il rilevamento degli oggetti.
  • He (2016), per l’architettura ResNet, base di diversi estrattori di caratteristiche pre-addestrati utilizzati in questo capitolo.
  • Chen (2018), per l’architettura DeepLabV3, utilizzata come modello pre-addestrato per la segmentazione semantica.
  • Kirillov (2023), per il modello Segment Anything (SAM), menzionato come direzione di studio per la segmentazione promptable.
  • {google} (2025), relativo allo strumento Gemini Notebook, utilizzato nell’elaborazione dell’infografica di sintesi del capitolo e reso disponibile come supporto complementare allo studio.

9.10 💻 Parte Pratica con Esercizi di Programmazione

La presente lista di Esercizi di Programmazione (EP) consolida le formulazioni teoriche presentate nel Capitolo 9 — Deep Learning per la Visione Artificiale — tramite un percorso pratico applicato. Diversamente dall’addestramento di reti neurali complete con PyTorch, che richiede tempi di esecuzione e, talvolta, GPU, gli EP di questo capitolo isolano le grandezze intermedie di una pipeline reale di deep learning — l’output di un singolo strato convoluzionale, il risultato di un’operazione di pooling, il conteggio dei parametri addestrabili di un’architettura, la sovrapposizione tra bounding box candidate, la qualità di una maschera di segmentazione e il filtro di soppressione non-massima — consentendo di validare manualmente ogni fase del ragionamento senza dipendere da librerie di machine learning né da un addestramento reale.

L’incatenamento degli esercizi riproduce il flusso concettuale del capitolo e cresce in difficoltà a ogni passo: si inizia con il calcolo manuale dell’output di uno strato convoluzionale addestrato (🟢), a partire da un kernel e un bias già addestrati; si prosegue con l’operazione di pooling (🟢, massimo e media), che riduce la risoluzione spaziale tra blocchi convoluzionali; si continua con il conteggio dei parametri addestrabili (🟡) di un’architettura CNN completa, evidenziando perché la condivisione dei pesi rende queste reti così più economiche rispetto a uno strato completamente connesso equivalente; si approfondisce il calcolo dell’Intersezione su Unione (IoU) e della Soppressione Non-Massima (NMS) (🟡), fase di post-elaborazione comune a rilevatori come Faster R-CNN e YOLO; si passa alla valutazione delle maschere di segmentazione (🟠) con le stesse metriche IoU e Dice utilizzate per confrontare U-Net con la baseline morfologica classica; e si conclude con una pipeline integrata (🔴), unendo l’output di un rilevatore di oggetti (dopo NMS) a una misurazione del mondo reale tramite riferimento di scala — lo stesso principio della fotogrammetria studiato nell’integrazione finale del capitolo.

Ogni volta che ha senso, ciascun esercizio indica i metodi della libreria didattica morph.py (la stessa utilizzata nel capitolo, importata come mm) che risolvono una fase del problema o che servono da riferimento per verificare i propri calcoli — senza, tuttavia, sostituire il ragionamento che devi implementare.

ImportanteLinee Guida per la Risoluzione degli Esercizi di Programmazione

In tutti gli esercizi di questo capitolo, le fasi di discretizzazione o arrotondamento numerico devono impiegare l’arrotondamento standard all’intero più vicino (round half away from zero), mitigando le ambiguità in valori con frazione esattamente uguale a \(0{,}5\). Salvo indicazione esplicita contraria: (i) l’operazione di “convoluzione” segue la convenzione adottata dai framework di deep learning — correlazione incrociata, senza inversione spaziale del kernel, esattamente come presentato nella Sezione “Strato Convoluzionale”; (ii) il riempimento (padding) è effettuato con zeri; (iii) le bounding box sono specificate nel formato angolo-a-angolo \((x_1, y_1, x_2, y_2)\), con \(x_1 < x_2\) e \(y_1 < y_2\); e (iv) vettori/matrici seguono l’indicizzazione a partire da \(0\), con la convenzione [riga][colonna] per strutture bidimensionali.

🎯 Obiettivo di questo Quaderno

Il quaderno consente di sviluppare, validare, organizzare e testare soluzioni di Esercizi di Programmazione (EPs) in ambienti interattivi, come Colab, con gli stessi casi di test di Moodle, copiandoli lì solo al momento di registrare il voto ufficiale.

Download

Scarica morph.py e testsuite.py eseguendo la cella sottostante:

import os, urllib.request

url = "https://raw.githubusercontent.com/fzampirolli/pdi-vc/master/morph/config.py"
if not os.path.exists("config.py"):
    urllib.request.urlretrieve(url, "config.py")

import config
config.setup(testsuite=True)
from morph import mm
from testsuite import TestSuite
✅ Ambiente pronto. Morph: 1.1.9 | OpenCV: 5.0.0 | TestSuite: 1.1.2

Esecuzione dei Test

Per valutare i test, esegui TestSuite("EP09_01.extensão").run() in una nuova cella, sostituendo l’estensione con quella del linguaggio utilizzato (.py, .java, .c, .cpp, .js o .r). Il sistema scarica i casi di test da GitHub, esegue il programma e calcola automaticamente il voto.

Per testare direttamente il codice Python, senza salvare il file, usa run_code(codigo) passando il codice come stringa in una variabile codigo:

codigo = """
# ... il tuo codice qui ...
"""
TestSuite("EP09_01").run_code(codigo)

9.10.1 EP09_01 🟢 Convoluzione 2D Manuale (Forward di un Livello Appreso)

Il PyTorch, presentato in questo capitolo, esegue nn.Conv2d(x) in un’unica chiamata — ma dietro di essa c’è solo la correlazione incrociata tra un kernel (già addestrato) e un intorno dell’input, seguita dalla somma di un bias e di un’attivazione, esattamente come formalizzato nella Sezione “Livello Convoluzionale”. La differenza essenziale rispetto alla convoluzione con kernel fissi del Capitolo 3 è che, qui, i valori del kernel e del bias sono già pronti (come se fossero stati appresi per gradiente), e spetta a te riprodurre manualmente il passaggio diretto (forward pass) che il framework esegue internamente.

Prima di addestrare una vera CNN, ti è stato affidato il compito di implementare questo passaggio diretto da zero, per un singolo livello convoluzionale con un singolo canale di input e un singolo filtro di output, incluso il supporto a padding e stride arbitrari.

9.10.1.1 📋 Linee Guida di Implementazione

  1. Input: Leggere le dimensioni \(H \times W\) della mappa delle caratteristiche di input e, successivamente, i suoi \(H \times W\) valori reali.

  2. Kernel e bias: Leggere le dimensioni \(k_h \times k_w\) del kernel (già addestrato), i suoi valori reali, e il bias \(b\) (reale, scalare).

  3. Iperparametri: Leggere il padding \(p\) (intero, numero di zeri aggiunti su ciascun bordo) e lo stride \(s\) (intero, passo dello scorrimento).

  4. Riempimento: Aggiungere \(p\) zeri su ciascuno dei quattro bordi della mappa di input prima della correlazione.

  5. Correlazione incrociata: Per ogni posizione di output \((i, j)\), calcolare \[ z(i,j) = b + \sum_{u=0}^{k_h-1} \sum_{v=0}^{k_w-1} K(u,v) \cdot X_{pad}(i \cdot s + u,\; j \cdot s + v), \] scorrendo l’input senza invertire il kernel (convenzione dei framework di deep learning, diversa dalla convoluzione matematica classica).

  6. Attivazione: Applicare ReLU a ogni valore: \(a(i,j) = \max(0, z(i,j))\).

  7. Dimensioni di output: \(O_h = \lfloor (H + 2p - k_h)/s \rfloor + 1\) e \(O_w = \lfloor (W + 2p - k_w)/s \rfloor + 1\).

  8. Output: Stampare \(O_h\) e \(O_w\) nella prima riga, seguiti da \(O_h\) righe con \(O_w\) valori reali ciascuna (la mappa delle caratteristiche di output, già con ReLU applicata), formattati con 4 cifre decimali.

9.10.1.2 📌 Vincoli Computazionali

  • Un canale di input, un filtro di output: non è necessario gestire più canali o più filtri in questa versione semplificata.
  • Senza inversione del kernel: implementare la correlazione incrociata, non la convoluzione matematica classica con kernel invertito — è questa l’operazione che PyTorch (e la maggior parte dei framework) chiama “convoluzione”.
  • Riempimento con zeri: i \(p\) pixel aggiunti su ciascun bordo valgono sempre \(0\).
  • Formattazione: tutti i valori di output devono avere esattamente 4 cifre decimali, anche quando il valore è un intero (es.: 2.0000).

9.10.1.3 🧠 Fondamenti Teorici

Elemento Ruolo nel livello convoluzionale
Kernel \(K\) Parametri appresi per gradiente, analoghi ai coefficienti di un filtro fisso del Capitolo 3, ma regolati tramite backpropagation
Bias \(b\) Offset appreso, sommato dopo la correlazione — consente al neurone di “attivarsi” anche con input nullo
Padding Controlla la dimensione spaziale dell’output e previene la perdita di informazioni ai bordi a ogni livello
Stride Controlla il passo dello scorrimento; valori \(> 1\) riducono la risoluzione spaziale, come una forma di sottocampionamento integrato nella convoluzione stessa
ReLU Introduce non linearità dopo la combinazione lineare, esattamente come nella Sezione “Funzione di Attivazione”

9.10.1.4 🧩 Metodi di morph.py che possono aiutare

  • mm.readImg(h, w, dtype='float') — legge direttamente una matrice \(h \times w\) di valori reali dall’input standard, evitando il parsing manuale della mappa delle caratteristiche e del kernel.
  • mm.correlacao0(f, kernel, bias) — implementa la stessa somma di correlazione incrociata + bias che dovrai calcolare a mano, ma senza supporto per padding o stride, e converte il risultato in uint8 (tronca valori negativi e decimali). Può servire come riferimento concettuale o per verificare il caso più semplice (\(p=0\), \(s=1\)), ma non sostituisce la tua implementazione completa — che deve preservare segno, cifre decimali, padding, stride e ReLU.

9.10.1.5 📦 Specifica di Input e Output (VPL)

Input:

  • Riga 1: Interi \(H\) e \(W\).
  • Prossime \(H\) righe: \(W\) valori reali ciascuna (mappa di input).
  • Riga successiva: Interi \(k_h\) e \(k_w\).
  • Prossime \(k_h\) righe: \(k_w\) valori reali ciascuna (kernel).
  • Riga successiva: Reale \(b\) (bias).
  • Riga successiva: Interi \(p\) e \(s\).

Output:

  • Riga 1: Interi \(O_h\) e \(O_w\).
  • Prossime \(O_h\) righe: \(O_w\) valori reali ciascuna, con 4 cifre decimali.

9.10.1.6 📌 Esempi

Input Output Osservazione
3 3
1 2 0
0 1 2
1 0 1
2 2
1 1
1 1
-2
0 1
2 2
2.0000 3.0000
0.0000 2.0000
Padding 0, stride 1: output \(2\times2\) senza riempimento.
3 3
1 2 0
0 1 2
1 0 1
2 2
1 0
0 1
0
1 2
2 2
1.0000 0.0000
1.0000 2.0000
Padding 1, stride 2: input riempito con zeri prima della correlazione.
🎮 Simulatore: Convoluzione 2D Manuale 🟢 correlazione incrociata + bias + ReLU

Ingresso 4×4 fisso, kernel 2×2 fisso (evidenziato in blu) — regola padding (p), stride (s) e bias (b), esattamente i parametri che l'EP09_01 richiede in ingresso, e osserva come cambiano la dimensione e i valori dell'uscita.

Padding (p)
Stride (s)
Bias (b)
(0,0)
Ingresso X imbottito (con padding)
originale padding (0) finestra corrente
Kernel K (2×2)
Uscita Y = ReLU(X⊛K + b)

💡 Ogni posizione dello slider rivela una cella della matrice di uscita. Percorri tutte le posizioni per completare la mappa di uscita. Cambiare p, s o b riavvia l'esplorazione, perché la mappa di uscita cambia dimensione e/o valori.

Figura 9.43: Simulatore EP09_01: Convoluzione 2D Manuale (correlazione incrociata + bias + ReLU, con padding e stride regolabili)
%%writefile EP09_01.py
# Codice Python
Overwriting EP09_01.py
TestSuite("EP09_01.py").run()
✔️ EP09_01.cases esiste già in casos/
📋 3 caso/i caricato/i da casos/EP09_01.cases

🔍 Test di Python: EP09_01.py
⚠️ EP09_01.py: file vuoto (meno di 3 righe). Test saltati.

9.10.2 EP09_02 🟢 Pooling Manuale (Massimo e Media)

Tra i blocchi convoluzionali, l’architettura tipica di una CNN intercala livelli di pooling, che riducono la risoluzione spaziale della mappa delle caratteristiche senza introdurre nuovi parametri addestrabili — a differenza della convoluzione, il pooling non ha pesi: si limita a riassumere ogni finestra dell’ingresso in un singolo valore, tramite un massimo o una media, esattamente come formalizzato nella Sezione “Pooling”.

Sei stato incaricato di implementare questa operazione a partire da una finestra scorrevole quadrata, senza sovrapposizione parziale sui bordi (solo finestre complete), supportando i due tipi più comuni: max (preserva il valore più saliente, tipicamente usato per mantenere bordi e texture forti) e avg (smussa la regione, preservando l’informazione di intensità media).

9.10.2.1 📋 Linee Guida di Implementazione

  1. Ingresso: Leggere le dimensioni \(H \times W\) della mappa delle caratteristiche di ingresso e i suoi \(H \times W\) valori reali.
  2. Finestra: Leggere gli interi \(k\) (dimensione della finestra quadrata \(k \times k\)) e \(s\) (stride).
  3. Tipo: Leggere una stringa, max o avg, che indica il tipo di pooling.
  4. Senza riempimento: Questa operazione non utilizza padding; le finestre che supererebbero il bordo dell’ingresso vengono scartate.
  5. Calcolo: Per ogni posizione di uscita \((i,j)\), calcolare il massimo o la media dei \(k \times k\) valori della finestra corrispondente, iniziando da \((i \cdot s,\, j \cdot s)\).
  6. Dimensioni di uscita: \(O_h = \lfloor (H - k)/s \rfloor + 1\) e \(O_w = \lfloor (W - k)/s \rfloor + 1\).
  7. Uscita: Stampare \(O_h\) e \(O_w\) nella prima riga, seguiti da \(O_h\) righe con \(O_w\) valori reali ciascuna, formattati con 4 cifre decimali.

9.10.2.2 📌 Vincoli Computazionali

  • Finestra quadrata: \(k \times k\), senza supporto per finestre rettangolari in questa versione.
  • Senza padding: solo le finestre interamente contenute nell’ingresso sono considerate — le dimensioni che “avanzeranno” sono semplicemente scartate.
  • avg usa divisione reale: la media è sempre \(\text{somma}/k^2\), anche quando il risultato ha molte cifre decimali — arrotondare solo nella formattazione finale, secondo la linea guida generale del capitolo.
  • Formattazione: tutti i valori di uscita con esattamente 4 cifre decimali.

9.10.2.3 🧠 Fondamento Teorico

Elemento Ruolo nell’architettura
Pooling massimo Preserva l’attivazione più forte della finestra; comune dopo livelli convoluzionali per mantenere bordi e texture salienti
Pooling medio Smussa la regione, preservando l’intensità media; comune nei livelli finali (global average pooling)
Assenza di parametri Differenzia il pooling dalla convoluzione: riduce la risoluzione spaziale senza costi aggiuntivi di addestramento
Riduzione della risoluzione Contribuisce all’invarianza rispetto a piccole traslazioni e alla riduzione del costo computazionale dei livelli successivi

9.10.2.4 🧩 Metodi di morph.py che possono aiutare

Il morph.py non implementa il pooling con sottocampionamento direttamente, ma due famiglie di operazioni mostrano la stessa idea sotto un’altra ottica, utile per verificare la tua intuizione:

  • mm.dil(f, Bc) / mm.dil0(f, B) — dilatazione morfologica: sostituisce ogni pixel con il massimo del suo intorno definito dall’elemento strutturante \(B\) (es.: mm.sebox(n) per una finestra \((2n+1)\times(2n+1)\)). È concettualmente un “max-pooling senza sottocampionamento” (produce un’immagine della stessa dimensione, invece che ridotta).
  • mm.blur(f, N) — smussatura per media in una finestra \(N \times N\), analoga all’avg-pooling, anch’essa senza riduzione della risoluzione.
  • mm.readImg(h, w, dtype='float') — utile per leggere la mappa di ingresso in virgola mobile.

9.10.2.5 📦 Specifica di Ingresso e Uscita (VPL)

Ingresso:

  • Riga 1: Interi \(H\) e \(W\).
  • Prossime \(H\) righe: \(W\) valori reali ciascuna.
  • Riga successiva: Interi \(k\) e \(s\).
  • Riga successiva: max o avg.

Uscita:

  • Riga 1: Interi \(O_h\) e \(O_w\).
  • Prossime \(O_h\) righe: \(O_w\) valori reali ciascuna, con 4 cifre decimali.

9.10.2.6 📌 Esempi

Ingresso Uscita Osservazione
4 4
1 3 2 4
5 6 1 2
2 1 0 3
4 2 5 1
2 2
max
2 2
6.0000 4.0000
4.0000 5.0000
Pooling massimo, finestra \(2\times2\), stride 2.
4 4
1 3 2 4
5 6 1 2
2 1 0 3
4 2 5 1
2 2
avg
2 2
3.7500 2.2500
2.2500 2.2500
Pooling medio sulle stesse finestre.
🎮 Simulatore: Pooling Manuale 🟢 senza padding, finestre complete

Ingresso 4×4 fisso — regola la dimensione della finestra (k), lo stride (s) e il tipo, esattamente i parametri che EP09_02 legge in ingresso, e guarda come cambiano la dimensione e i valori dell'uscita.

Finestra (k)
Stride (s)
Tipo
(0,0)
Ingresso X (4×4)
fuori dalla finestra finestra corrente scartato (avanzo)
Uscita Y (pooling)

💡 Ogni posizione dello slider rivela una cella della matrice di uscita. Le celle grigio tratteggiate nell'ingresso sono "avanzi" che nessuna finestra raggiunge — nota come ciò accade quando (H−k) non è multiplo di s. Cambiare k, s o il tipo riavvia l'esplorazione.

Figura 9.44: Simulatore EP09_02: Pooling Manuale (massimo vs. media, con finestra k e stride s regolabili)
%%writefile EP09_02.py
# Codice Python
Overwriting EP09_02.py
TestSuite("EP09_02.py").run()
✔️ EP09_02.cases esiste già in casos/
📋 4 caso/i caricato/i da casos/EP09_02.cases

🔍 Test di Python: EP09_02.py
⚠️ EP09_02.py: file vuoto (meno di 3 righe). Test saltati.

9.10.3 EP09_03 🟡 Conteggio dei Parametri Addestrabili di una CNN

Questo EP formalizza il conteggio dei parametri addestrabili di una CNN. Data la descrizione testuale di una piccola architettura, composta da layer convoluzionali, di pooling e completamente connessi, determinare, per ogni layer, il numero di parametri addestrabili e il totale della rete.

L’architettura deve essere interpretata sequenzialmente: l’uscita di un layer convoluzionale diventa l’ingresso del layer successivo compatibile. Pertanto, il numero di canali prodotti da un layer CONV determina il numero di canali di ingresso (cin) del layer convoluzionale successivo.

In un layer convoluzionale, è importante distinguere canali di ingresso e canali di uscita:

  • \(c_{in}\) (channels in) è il numero di canali che entrano nel layer. Un’immagine in scala di grigi ha \(c_{in}=1\), mentre un’immagine RGB ha \(c_{in}=3\). In un layer convoluzionale intermedio, cin è normalmente uguale al numero di canali prodotti dal layer CONV precedente.
  • \(c_{out}\) (channels out) è il numero di canali prodotti dal layer. È uguale al numero di filtri utilizzati. Pertanto, se un layer ha 16 filtri, produce \(c_{out}=16\) canali.

Ad esempio, si consideri la sequenza:

CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1
POOL
FC 784 10 1

La prima convoluzione riceve un’immagine con un canale e produce 8 canali. Dopo il pooling, la seconda convoluzione riceve questi 8 canali e ne produce 16. Il layer POOL non altera il numero di canali, può solo ridurre le dimensioni spaziali. Il layer FC riceve la quantità di ingressi indicata nella propria descrizione.

Ogni filtro convoluzionale ha dimensioni

\[ k_h \times k_w \times c_{in}. \]

Pertanto, un layer con \(c_{out}\) filtri ha

\[ k_h \cdot k_w \cdot c_{in} \cdot c_{out} \]

pesi. Se c’è un bias, si aggiunge un parametro per ogni filtro, totalizzando altri \(c_{out}\) parametri.

Il punto centrale di questo esercizio è osservare che la quantità di parametri di un layer convoluzionale non dipende dalle dimensioni spaziali (\(H \times W\)) della mappa delle caratteristiche. Ciò è dovuto alla condivisione dei pesi: lo stesso filtro viene riutilizzato in diverse posizioni dell’ingresso.

9.10.3.1 📋 Linee Guida di Implementazione

  1. Ingresso: Leggere l’intero \(L\) (numero di layer dell’architettura, nell’ordine in cui vengono applicati).

  2. Layer: Leggere \(L\) righe, ciascuna descrive un layer in uno dei tre formati:

    • CONV kh kw cin cout bias — layer convoluzionale con kernel \(k_h \times k_w\), \(c_{in}\) canali di ingresso, \(c_{out}\) canali di uscita e bias (0 o 1), che indica se c’è un bias per filtro;
    • POOL — layer di pooling (massimo o medio), che non ha parametri addestrabili e preserva il numero di canali;
    • FC in out bias — layer completamente connesso con in ingressi, out uscite e bias (0 o 1), che indica se c’è un bias per neurone.
  3. Coerenza tra layer CONV: in una sequenza di layer convoluzionali, il cin di un layer deve corrispondere al cout del layer convoluzionale precedente. Un layer POOL non altera questo numero di canali.

    Ad esempio:

    CONV 3 3 1 8 1
    POOL
    CONV 3 3 8 16 1

    La prima CONV produce 8 canali, che vengono ricevuti dalla seconda CONV. Pertanto, nel secondo layer, cin=8 e cout=16.

  4. Parametri di un layer CONV:

    Ciascuno dei \(c_{out}\) filtri ha \(k_h \cdot k_w \cdot c_{in}\) pesi. Pertanto,

    \[ P_{\mathrm{CONV}} = k_h \cdot k_w \cdot c_{in} \cdot c_{out} + c_{out}\cdot\text{bias}. \]

  5. Parametri di un layer FC:

    \[ P_{\mathrm{FC}} = \text{in}\cdot\text{out} + \text{out}\cdot\text{bias}. \]

  6. Parametri di un layer POOL: sempre \(0\).

  7. Totale della rete: sommare i parametri addestrabili di tutti i layer.

  8. Uscita: Per ogni layer, nell’ordine di lettura, stampare Camada i: P, dove \(i\) inizia da \(1\) e \(P\) è il numero di parametri di quel layer. Alla fine, stampare Total: T.

9.10.3.2 📐 Esempio per capire cin e cout

Si consideri la sequenza:

CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1

Nel primo layer:

  • cin=1: entra un canale;
  • cout=8: ci sono 8 filtri e, quindi, escono 8 canali.

Ogni filtro ha

\[ 3\cdot3\cdot1=9 \]

pesi. Poiché ci sono 8 filtri:

\[ 9\cdot8=72 \]

pesi. Con un bias per filtro:

\[ 72+8=80. \]

Nel secondo layer:

  • cin=8: entrano gli 8 canali prodotti dalla prima CONV;
  • cout=16: ci sono 16 filtri e, quindi, escono 16 canali.

Ogni filtro ha

\[ 3\cdot3\cdot8=72 \]

pesi. Poiché ci sono 16 filtri:

\[ 72\cdot16=1152 \]

pesi. Con 16 bias:

\[ 1152+16=1168. \]

Pertanto, i due layer hanno, rispettivamente, 80 e 1168 parametri addestrabili.

Si noti che cout non è \(cin\) moltiplicato per il numero di filtri. Il numero di filtri è esattamente cout: ogni filtro combina tutti i canali di ingresso e produce un singolo canale di uscita.

9.10.3.3 📌 Vincoli Computazionali

  • Indipendenza dalla dimensione spaziale: l’ingresso non fornisce \(H \times W\). Il conteggio di un layer CONV dipende solo da kh, kw, cin e cout.
  • Coerenza dei canali: per due layer CONV consecutivi, il cin del secondo deve essere uguale al cout del primo. Un layer POOL preserva il numero di canali.
  • bias sempre 0 o 1: moltiplicare direttamente il termine di bias per questo valore.
  • Layer POOL senza argomenti aggiuntivi: la riga contiene solo la parola POOL.
  • Layer FC: il numero di ingressi in è fornito esplicitamente. Non è necessario calcolare le dimensioni spaziali prodotte dai layer precedenti.
  • Tutti i valori numerici di ingresso sono interi non negativi.

9.10.3.4 🧠 Fondamenti Teorici

Elemento Ruolo nel conteggio dei parametri
\(c_{in}\) Numero di canali ricevuti dal layer
\(c_{out}\) Numero di filtri e, quindi, di canali prodotti dal layer
Filtro convoluzionale Ogni filtro ha \(k_h \cdot k_w \cdot c_{in}\) pesi e produce un canale di uscita
Condivisione dei pesi Lo stesso filtro viene riutilizzato in diverse posizioni dell’ingresso, rendendo il conteggio indipendente da \(H \times W\)
Bias Un singolo parametro aggiuntivo per filtro (CONV) o per neurone (FC)
Pooling Può alterare \(H \times W\), ma non ha parametri addestrabili e preserva il numero di canali
Layer FC Ha un peso per ogni combinazione tra ingresso e neurone di uscita

9.10.3.5 🧩 Metodi di morph.py che possono aiutare

Questo esercizio è puramente aritmetico e non utilizza direttamente le funzioni di morph.py. Il conteggio può, tuttavia, essere verificato in un’architettura reale implementata in PyTorch tramite:

sum(p.numel() for p in modelo.parameters())

Questa espressione calcola i parametri del modello, inclusi pesi e bias.

9.10.3.6 📦 Specifica di Ingresso e Uscita (VPL)

Ingresso:

  • Riga 1: Intero \(L\).
  • Prossime \(L\) righe: descrizione di ogni layer, nel formato CONV kh kw cin cout bias, POOL o FC in out bias.

Uscita:

  • \(L\) righe nel formato Camada i: P.
  • Ultima riga: Total: T.

9.10.3.7 📌 Esempi

Ingresso Uscita Osservazione
3
CONV 3 3 1 8 1
POOL
FC 1352 10 1
Camada 1: 80
Camada 2: 0
Camada 3: 13530
Total: 13610
Rete semplice con una convoluzione, pooling e layer di classificazione.
5
CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1
POOL
FC 400 10 1
Camada 1: 80
Camada 2: 0
Camada 3: 1168
Camada 4: 0
Camada 5: 4010
Total: 5258
Piccola CNN con due convoluzioni, due pooling e un layer completamente connesso.
6
CONV 3 3 1 8 1
POOL
CONV 3 3 8 16 1
POOL
FC 256 32 1
FC 32 10 1
Camada 1: 80
Camada 2: 0
Camada 3: 1168
Camada 4: 0
Camada 5: 8224
Camada 6: 330
Total: 9802
Piccola CNN con due convoluzioni, pooling intermedio e due layer completamente connessi per la classificazione.
🎮 Simulatore: Conteggio dei Parametri 🟡 condivisione dei pesi
CONV Blocco blu POOL Cilindro verde FC Rombo arancione BATCH Pila rossa 🖱️ Trascina per spostare i livelli
32×32
1
4
3
🧠 Visualizzazione 3D
🖱️ Trascina livelli | Scroll zoom | P pausa
Figura 9.45: Simulatore EP09_03: Conteggio dei Parametri — Convoluzione vs. Strato Totalmente Connesso
%%writefile EP09_03.py
# Codice Python
Overwriting EP09_03.py
TestSuite("EP09_03.py").run()
✔️ EP09_03.cases esiste già in casos/
📋 3 caso/i caricato/i da casos/EP09_03.cases

🔍 Test di Python: EP09_03.py
⚠️ EP09_03.py: file vuoto (meno di 3 righe). Test saltati.

9.10.4 EP09_04 🟡 Intersezione su Unione (IoU) e Soppressione dei Non-Massimi (NMS)

I modelli di rilevamento degli oggetti possono produrre diverse bounding box candidate per lo stesso oggetto, con posizioni e punteggi di confidenza differenti. La fase di post-elaborazione responsabile dell’eliminazione di queste rilevazioni ridondanti è la Soppressione dei Non-Massimi (NMS), la cui operazione fondamentale utilizza la metrica di Intersezione su Unione (IoU).

La NMS utilizza questa misura per decidere quali box devono essere mantenute. In generale, la box con la confidenza più alta viene selezionata per prima; successivamente, le box che presentano un’IoU superiore a una certa soglia con la box selezionata sono considerate ridondanti e vengono rimosse. Il processo viene ripetuto finché non rimangono box candidate.

In questo esercizio, dovrai implementare l’algoritmo NMS da zero, calcolando l’IoU tra le box e applicando successivamente il criterio di selezione e soppressione per produrre l’insieme finale di rilevazioni.

9.10.4.1 📋 Linee Guida di Implementazione

  1. Input: Leggere l’intero \(N\) (numero di box candidate) e la soglia reale \(\tau\) (soglia IoU per la soppressione), sulla stessa riga.

  2. Box: Leggere \(N\) righe, ciascuna con cinque valori reali:

    x1 y1 x2 y2 score

    dove \((x_1,y_1)\) rappresenta l’angolo superiore sinistro, \((x_2,y_2)\) l’angolo inferiore destro e score il punteggio di confidenza.

  3. Intersezione su Unione: Per due box \(A\) e \(B\),

    \[ IoU(A,B)= \frac{\operatorname{Area}(A\cap B)} {\operatorname{Area}(A\cup B)}. \]

    L’area di intersezione deve essere calcolata dalla sovrapposizione degli intervalli in \(x\) e \(y\). Se non c’è sovrapposizione, l’area di intersezione è zero.

  4. Algoritmo greedy di NMS:

    1. Ordina le box per score decrescente. In caso di parità, mantieni l’ordine originale di lettura.

    2. Seleziona la box con il punteggio più alto tra le box rimanenti e aggiungila all’insieme di output.

    3. Calcola l’IoU tra la box selezionata e tutte le box ancora rimanenti. Sopprimi le box per cui

    \[ \text{IoU} > \tau. \]

    1. Ripeti i passaggi (b) e (c) finché non rimangono box.
  5. Output: Per ogni box mantenuta, nell’ordine in cui è stata selezionata, stampa il suo indice originale (posizione di lettura, a partire da \(0\)) e il suo score, formattato con 4 cifre decimali. Alla fine, stampa:

    Totale mantenute: X

9.10.4.2 📌 Vincoli Computazionali

  • Soppressione stretta: solo le box con \(\text{IoU} > \tau\) vengono soppresse. Le box con \(\text{IoU}=\tau\) vengono mantenute.
  • Indici originali: l’output fa riferimento alla posizione in cui ogni box è stata letta nell’input (a partire da \(0\)), non alla sua posizione dopo l’ordinamento.
  • Ordinamento stabile: in caso di score uguali, deve essere preservato l’ordine originale di lettura.
  • Rettangoli allineati agli assi: tutte le box sono specificate da due angoli, con \(x_1 < x_2\) e \(y_1 < y_2\) garantiti nell’input.
  • Coordinate e punteggi: i valori reali possono essere positivi o negativi, secondo i limiti definiti dall’input, ma le dimensioni delle box sono sempre positive.

9.10.4.3 🧠 Fondamento Teorico

Elemento Ruolo nella post-elaborazione della rilevazione
IoU Quantifica la sovrapposizione spaziale tra due box; \(\text{IoU}=1\) per box identiche e \(\text{IoU}=0\) per box senza sovrapposizione
Ordinamento per confidenza Fa sì che la box con score più alto venga analizzata per prima
Soglia \(\tau\) Definisce la quantità di sovrapposizione necessaria affinché una box sia considerata ridondante
Soppressione Rimuove le box che presentano una grande sovrapposizione con una box già selezionata
Box distanti Hanno IoU vicina a zero e, in generale, non vengono soppresse da questa regola

9.10.4.4 🧩 Metodi di morph.py che possono aiutare

  • mm.IoU(boxA, boxB) — calcola la metrica IoU, ma si aspetta le box nel formato \((x,y,w,h)\), cioè angolo superiore sinistro, larghezza e altezza. L’input di questo esercizio utilizza il formato \((x_1,y_1,x_2,y_2)\). La conversione è diretta:

    \[ w=x_2-x_1,\qquad h=y_2-y_1. \]

    L’uso di questa funzione è facoltativo. L’obiettivo principale dell’esercizio è implementare correttamente il processo di selezione e soppressione della NMS.

9.10.4.5 📦 Specifica di Input e Output (VPL)

Input:

  • Riga 1: intero \(N\) e reale \(\tau\).
  • Prossime \(N\) righe: \(x_1\ y_1\ x_2\ y_2\ \text{score}\).

Output:

  • Una riga per box mantenuta, nell’ordine di selezione: indice score.
  • Ultima riga: Totale mantenute: X.
🎮 Simulatore: IoU e Soppressione Non-Massimale 🟡 NMS
Casella selezionata Casella mantenuta Casella soppressa Casella candidata
5
0.50
Predefinito
🎯 Visualizzazione delle caselle
📋 Procedura passo passo della NMS
Figura 9.46: Simulatore EP09_04: IoU e Soppressione Non-Massima (NMS)
%%writefile EP09_04.py
# Codice Python
Overwriting EP09_04.py
TestSuite("EP09_04.py").run()
✔️ EP09_04.cases esiste già in casos/
📋 3 caso/i caricato/i da casos/EP09_04.cases

🔍 Test di Python: EP09_04.py
⚠️ EP09_04.py: file vuoto (meno di 3 righe). Test saltati.

9.10.5 EP09_05 🟠 Valutazione della Segmentazione: IoU e Dice Pixel per Pixel

Il Blocco 2 della sezione “Segmentazione Semantica con Architettura U-Net” definisce, in poche righe, la funzione iou_mascaras, utilizzata per misurare la qualità della baseline morfologica classica (smoothing + Otsu + apertura) e, più avanti, della stessa U-Net addestrata. Diversamente dall’IoU dell’EP09_04 — calcolato su bounding box (regioni rettangolari descritte da quattro numeri) —, l’IoU di segmentazione è calcolato pixel per pixel: ogni posizione dell’immagine viene confrontata individualmente tra la maschera predetta e la maschera di riferimento.

Ti è stato affidato il compito di generalizzare questa valutazione, implementando non solo l’IoU pixel per pixel, ma anche il coefficiente di Dice, un’altra metrica di sovrapposizione ampiamente utilizzata in segmentazione medica (inclusa nella funzione perda_dice, menzionata nello stesso blocco del capitolo come base della funzione di perdita utilizzata per addestrare la U-Net).

9.10.5.1 📋 Linee Guida di Implementazione

  1. Input: Leggere le dimensioni \(H \times W\) delle maschere.

  2. Maschera predetta: Leggere \(H\) righe con \(W\) valori interi (0 o 1) ciascuna — ad esempio, l’output di una U-Net dopo la sogliatura a \(0{,}5\) sulla sigmoide, come nel Blocco 4 del capitolo.

  3. Maschera di riferimento: Leggere altre \(H\) righe con \(W\) valori interi (0 o 1) ciascuna — il ground truth.

  4. Intersezione e unione: Considerando ogni pixel come appartenente all’oggetto quando il suo valore è diverso da zero, \[ \text{intersezione} = \sum_{i,j} \mathbb{1}[P_{ij}=1 \wedge R_{ij}=1], \qquad \text{unione} = \sum_{i,j} \mathbb{1}[P_{ij}=1 \vee R_{ij}=1]. \]

  5. IoU pixel per pixel: \[ \text{IoU} = \frac{\text{intersezione}}{\text{unione}}. \]

  6. Coefficiente di Dice: \[ \text{Dice} = \frac{2 \cdot \text{intersezione}}{|P| + |R|}, \] dove \(|P|\) e \(|R|\) sono il numero totale di pixel dell’oggetto in ciascuna maschera.

  7. Convenzione per maschere vuote: se entrambe le maschere non hanno alcun pixel dell’oggetto (unione \(= 0\) e \(|P|+|R|=0\)), considera la corrispondenza banalmente perfetta: \(\text{IoU} = \text{Dice} = 1{,}0\).

  8. Output: Due righe, IoU: X.XXXX e Dice: X.XXXX, ciascun valore con 4 cifre decimali.

9.10.5.2 📌 Vincoli Computazionali

  • Qualsiasi valore non nullo conta come oggetto: tratta i valori diversi da \(0\) (non solo \(1\)) come appartenenti alla maschera, replicando il controllo predita > 0 usato in iou_mascaras nel capitolo.
  • Stesse dimensioni: le due maschere hanno sempre esattamente \(H \times W\) elementi.
  • Convenzione del vuoto: applica la regola del punto 7 solo quando entrambe le maschere sono completamente vuote; se solo una è vuota, l’intersezione è \(0\) e l’IoU/Dice risultante sarà anch’esso \(0\).

9.10.5.3 🧠 Fondamento Teorico

Elemento Ruolo nella valutazione della segmentazione
IoU pixel per pixel Generalizza la metrica dell’EP09_04 a regioni di forma arbitraria — non solo rettangoli — confrontando la maschera predetta e il riferimento posizione per posizione
Coefficiente di Dice Metrica correlata all’IoU (sempre \(\text{Dice} \ge \text{IoU}\)), più sensibile a piccole intersezioni e ampiamente utilizzata come funzione di perdita in segmentazione (funzione perda_dice del capitolo)
Convenzione per maschere vuote Evita la divisione per zero e riconosce che “nessun oggetto previsto, nessun oggetto reale” è, per definizione, un successo
Confronto classico vs. U-Net Il capitolo usa esattamente questo tipo di metrica per giustificare, numericamente, perché la U-Net supera la baseline morfologica in scenari a basso contrasto

9.10.5.4 🧩 Metodi di morph.py che possono aiutare

  • mm.readImg(h, w, dtype='uint8') — legge direttamente ogni maschera binaria \(h \times w\) dall’input standard (i valori \(0/1\) rientrano perfettamente nel tipo intero standard).
  • La stessa funzione iou_mascaras, definita nel Blocco 2 della sezione U-Net del capitolo (non fa parte di morph.py, ma del codice del capitolo), è l’ispirazione diretta di questo esercizio — vale la pena rileggere quelle poche righe prima di programmare.
  • Per un’estensione opzionale (non richiesta da questo EP), mm.connectedComponents o mm.label0 (visti nel contesto dell’analisi delle componenti connesse) permetterebbero di etichettare ogni nodulo individualmente e calcolare l’IoU per componente, invece che sull’intera maschera.

9.10.5.5 📦 Specifica di Input e Output (VPL)

Input:

  • Riga 1: Interi \(H\) e \(W\).
  • Prossime \(H\) righe: \(W\) valori interi (0 o 1) — maschera predetta.
  • Prossime \(H\) righe: \(W\) valori interi (0 o 1) — maschera di riferimento.

Output:

  • Riga 1: IoU: X.XXXX.
  • Riga 2: Dice: X.XXXX.
Consiglio💡 Esempio Illustrativo

Considera una maschera predetta con un quadrato \(2\times2\) di pixel attivi e un riferimento spostato di una colonna, sovrapponendosi solo per metà dell’area:

Predetta        Riferimento
0 0 0 0         0 0 0 0
0 1 1 0         0 0 1 1
0 1 1 0         0 0 1 1
0 0 0 0         0 0 0 0

Intersezione \(=2\) pixel, unione \(=6\) pixel (\(4+4-2\)), quindi \(\text{IoU}=2/6\approx0{,}3333\) e \(\text{Dice}=2\cdot2/(4+4)=0{,}5000\) — nota che il Dice è sempre uguale o maggiore dell’IoU per la stessa sovrapposizione.

9.10.5.6 📌 Esempi

Input Output Osservazione
4 4
0 0 0 0
0 1 1 0
0 1 1 0
0 0 0 0
0 0 0 0
0 0 1 1
0 0 1 1
0 0 0 0
IoU: 0.3333
Dice: 0.5000
Maschere \(4\times4\) con sovrapposizione parziale di 2 pixel.
🎮 Simulatore: IoU e Dice Pixel per Pixel 🟠 Segmentazione
Intersezione (VP) Solo previsto (FP) Solo riferimento (FN) Sfondo (VN)
5×5
Quadrato
🔵 Maschera Prevista
🟡 Maschera di Riferimento
🎯 Confronto Visivo
📊 Calcoli e Formule
Figura 9.47: Simulatore EP09_05: Valutazione della Segmentazione — IoU e Dice Pixel per Pixel
%%writefile EP09_05.py
# Codice Python
Overwriting EP09_05.py
TestSuite("EP09_05.py").run()
✔️ EP09_05.cases esiste già in casos/
📋 4 caso/i caricato/i da casos/EP09_05.cases

🔍 Test di Python: EP09_05.py
⚠️ EP09_05.py: file vuoto (meno di 3 righe). Test saltati.

9.10.6 EP09_06 🔴 Pipeline Integrato: Dalla Rilevazione alla Misurazione nel Mondo Reale

Questo esercizio finale integra i due esercizi di rilevazione e il principio di fotogrammetria presentato nella sezione “Fotogrammetria e Riferimento di Scala” — esattamente lo stesso calcolo implementato nella figura di misurazione per riferimento di scala di questo capitolo. Lo scenario riproduce una situazione realistica: un rilevatore (Faster R-CNN o YOLO) genera diverse scatole candidate sovrapposte per lo stesso oggetto di interesse; dopo averle filtrate tramite NMS, la scatola sopravvissuta con maggiore confidenza viene utilizzata, insieme a una scatola di riferimento di larghezza reale nota (come la carta da \(8{,}56\) cm), per stimare le dimensioni reali dell’oggetto rilevato.

9.10.6.1 📋 Linee Guida di Implementazione

  1. Riferimento noto: Leggere il valore reale \(L_{ref}\) (larghezza reale dell’oggetto di riferimento, in cm) e successivamente i quattro reali \(x_1\ y_1\ x_2\ y_2\) della sua scatola delimitante in pixel (già nota, senza necessità di rilevazione).
  2. Candidati dell’oggetto da misurare: Leggere l’intero \(N\) (numero di scatole candidate prodotte dal rilevatore per l’oggetto di interesse) e la soglia reale \(\tau\); successivamente, leggere le \(N\) righe di scatole candidate, ciascuna con \(x_1\ y_1\ x_2\ y_2\ \text{score}\).
  3. Fase 1 — NMS: Applicare esattamente l’algoritmo di Soppressione Non Massima dell’EP09_04 alle \(N\) scatole candidate, utilizzando la soglia \(\tau\), per eliminare rilevazioni ridondanti dello stesso oggetto.
  4. Fase 2 — Selezione della scatola finale: Dopo il NMS, la scatola con il score più alto tra quelle mantenute è la rilevazione finale dell’oggetto (l’input garantisce che tutte le scatole candidate corrispondano a un singolo oggetto fisico, quindi la prima scatola selezionata dal NMS è già il risultato finale).
  5. Fase 3 — Misurazione per riferimento di scala: Calcolare il rapporto \(\text{cm/pixel} = L_{ref} / \text{larghezza del riferimento in pixel}\) e applicarlo sia alla larghezza che all’altezza (in pixel) della scatola finale dell’oggetto, ottenendo le sue dimensioni reali stimate in centimetri.
  6. Output: Prima, una riga per ogni scatola mantenuta dopo il NMS (stesso formato dell’EP09_04): índice score. Successivamente, la riga Total mantidas: X. Infine, la riga Objeto: L x A cm, dove \(L\) e \(A\) sono la larghezza e l’altezza stimate dell’oggetto, ciascuna con 2 cifre decimali.

9.10.6.2 📌 Vincoli Computazionali

  • Riutilizzare integralmente il NMS dell’EP09_04 — stessa regola di parità, stesso criterio di soppressione (\(\text{IoU} > \tau\)).
  • Il riferimento non passa attraverso il NMS: la sua scatola è data direttamente, senza candidati concorrenti.
  • Rapporto unico per larghezza e altezza: così come nella figura di fotogrammetria del capitolo, lo stesso rapporto cm/pixel (derivato dalla larghezza del riferimento) viene applicato sia alla larghezza che all’altezza dell’oggetto — non vi è calibrazione verticale separata.

9.10.6.3 🧠 Fondamenti Teorici

Fase Concetto del capitolo
Multiple scatole candidate Output grezzo di un rilevatore come Faster R-CNN o YOLO, prima della post-elaborazione
NMS (EP09_04) Filtra le rilevazioni ridondanti, preservando solo la più affidabile per l’oggetto
Riferimento di scala noto Stesso principio della carta da \(8{,}56\) cm utilizzata nella sezione “Fotogrammetria e Riferimento di Scala”
Conversione pixel → centimetro Regola del tre semplice: \(\text{cm/pixel} = L_{ref} / w_{ref\_px}\), applicata alla scatola finale dell’oggetto

9.10.6.4 🧩 Metodi di morph.py che possono aiutare

  • mm.IoU(boxA, boxB) — la stessa funzione suggerita nell’EP09_04, qui riutilizzata all’interno della fase di NMS di questo pipeline integrato (ricordarsi della conversione di formato: \(w = x_2-x_1\), \(h = y_2-y_1\)).
  • Se hai già risolto l’EP09_04 incapsulando il NMS in una funzione propria, questo è il momento ideale per riutilizzare quel codice — l’integrazione di moduli già testati singolarmente è esattamente la pratica ingegneristica che questo esercizio vuole rafforzare.

9.10.6.5 📦 Specifica di Input e Output (VPL)

Input:

  • Riga 1: Reale \(L_{ref}\).
  • Riga 2: \(x_1\ y_1\ x_2\ y_2\) della scatola di riferimento.
  • Riga 3: Intero \(N\) e reale \(\tau\).
  • Prossime \(N\) righe: \(x_1\ y_1\ x_2\ y_2\ \text{score}\) delle scatole candidate dell’oggetto.

Output:

  • Una riga per ogni scatola mantenuta dopo il NMS: índice score.
  • Riga successiva: Total mantidas: X.
  • Ultima riga: Objeto: L x A cm.

9.10.6.6 📌 Esempi

Input Output Osservazione
8.56
30 200 170 288
3 0.5
250 100 470 250 0.92
255 105 468 245 0.88
600 600 650 650 0.40
0 0.9200
2 0.4000
Total mantidas: 2
Objeto: 13.45 x 9.17 cm
La scatola 1 viene soppressa perché si sovrappone fortemente alla scatola 0; la rilevazione finale dell’oggetto è la scatola 0.
🎮 Simulatore: Pipeline Integrato — Dal Rilevamento alla Misurazione 🔴 Fotogrammetria
Casella selezionata Casella soppressa Riferimento Oggetto finale
8.56
0.50
Modello
🎯 Visualizzazione del Pipeline
📋 Pipeline Passo dopo Passo
Figura 9.48: Simulatore EP09_06: Pipeline Integrato — Rilevamento alla Misurazione del Mondo Reale
%%writefile EP09_06.py
# Codice Python
Overwriting EP09_06.py
TestSuite("EP09_06.py").run()
✔️ EP09_06.cases esiste già in casos/
📋 3 caso/i caricato/i da casos/EP09_06.cases

🔍 Test di Python: EP09_06.py
⚠️ EP09_06.py: file vuoto (meno di 3 righe). Test saltati.