Annexe A — À propos de MCTest
MCTest est un système open source pour la création et la correction automatique d’examens paramétrés (Zampirolli, 2023). Il prend en charge les questions à choix multiples, dissertatives et de programmation, ces dernières intégrées au VPL de Moodle, décrit à l’Annexe B.
La version de MCTest utilisée dans ce livre est la 5.4, disponible sur https://github.com/fzampirolli/mctest. Le sous-dossier book du dépôt contient les versions 5.3, décrite dans (Zampirolli, 2023), et 5.4, utilisée pour générer les épreuves présentées dans ce livre et actuellement en production à l’UFABC (https://mctest.ufabc.edu.br).
A.1 Installation de MCTest
L’installation recommandée utilise VirtualBox avec Ubuntu 22.04. Dans le terminal Ubuntu, en tant que root, exécutez :
wget https://raw.githubusercontent.com/fzampirolli/mctest/master/_setup-all.shRemplacez ensuite yourLogin par le nom d’utilisateur local et exécutez :
sed -i 's/\/home\/fz\//\/home\/yourLogin\//g' _setup-all.sh
source _setup-all.sh
pip install mysqlclient
Après quelques minutes, MCTest sera configuré. Pour l’exécuter :
source /home/yourLogin/PycharmProjects/runDjango.shLe système est alors accessible à l’adresse http://127.0.0.1:8000.
A.2 Créer un examen dans MCTest
Dans MCTest, chaque examen est configuré sur un écran Exam, qui réunit les classes, les sujets (associés à une matière, comme PDI-VC) et les questions — chaque question appartient à un seul sujet. Outre les attributs habituels de base de données, l’examen possède ses propres paramètres, comme le nombre de questions tirées et le nombre de variantes générées.
Pour les deux examens décrits dans cette annexe, un ensemble de questions paramétrées a été défini par examen, dont un sous-ensemble est tiré aléatoirement pour chaque variante, totalisant 110 variantes distinctes — une par étudiant inscrit dans les classes.
Le bouton Create-Variations génère un nouvel ensemble de variantes à chaque activation. Lorsque les questions sont liées à des activités VPL, l’enseignant reçoit par e-mail un fichier *linker.json contenant tous les cas de test des variantes générées. Le bouton Create-PDF génère, pour chaque classe, un PDF avec les examens tirés par étudiant, ainsi qu’un fichier *students_variations.csv indiquant le nom, l’e-mail et la variante tirée de chaque étudiant.
Chaque activation du bouton Create-Variations génère un nouvel ensemble de variantes d’examen. Après avoir imprimé le PDF, il est essentiel de ne pas modifier les attributs de l’examen, sous peine d’invalider la correction automatique des examens déjà imprimés ou passés.
A.3 Créer une question paramétrique
Une question paramétrique dans MCTest combine trois éléments :
- Description — l’énoncé de la question, écrit en LaTeX, contenant des variables entre
[[code:variable]], remplacées par la valeur tirée pour chaque étudiant ; - Bloc de définition (
[[def: ... ]]) — un extrait de code Python, intégré à la question elle-même, chargé de tirer les paramètres, de calculer la solution de référence et de construire les cas de test ; - Cas de test pour Moodle (bloc
moodle_cases) — un dictionnaire sérialisé en JSON contenant les entrées et sorties attendues, consommé par l’activité VPL.
Un exemple simplifié de définition de question (adapté de la génération d’un échiquier h × w) est :
[[code:texto]]

\vspace{2mm}\noindent\textbf{Exemple d'entrée :}\vspace{-2mm}\
\begin{verbatim}
[[code:caso0_inp]]
\end{verbatim}
\vspace{-2mm}\noindent\textbf{Exemple de sortie :}\vspace{-2mm}\
\begin{verbatim}
[[code:caso0_out]]
\end{verbatim}

\begin{comment}
[[code:moodle_cases]]
\end{comment}

[[def:
import json
import numpy as np
from topic.morph import mm # DOIT inclure "topic." dans MCTest

def chess(h, w):
    m = np.zeros((h, w), dtype='int')
    for i in range(h):
        for j in range(w):
            if (i + j) % 2:
                m[i][j] = 1
    return m

# PARAMÈTRES UTILISÉS DANS L'ÉNONCÉ DE LA QUESTION
height = int(np.random.randint(5, 15))

# ÉNONCÉ COMPLET, AVEC LA VALEUR DE height DÉJÀ INTERPOLÉE
texto = (
    r"\vspace{2mm}\noindent\textbf{Description :}\vspace{-2mm} "
    r"Écrivez un programme qui lit un entier \texttt{W}, représentant la "
    r"largeur (nombre de colonnes) d'un plateau, et affiche ce plateau sous "
    r"la forme d'un échiquier, en utilisant les chiffres \texttt{0} et \texttt{1}. "
    r"Le plateau affiché aura toujours une hauteur (nombre de lignes) égale à "
    f"\\textbf{{{height}}} "
    r"et une largeur égale à la valeur \texttt{W} lue en entrée. "
    r"En considérant la position $(i, j)$ du plateau (indexée à partir de 0, "
    r"$i$ représentant la ligne et $j$ la colonne), la valeur affichée à "
    r"cette position doit être \texttt{1} si $i + j$ est impair, et \texttt{0} sinon. "
    r"Chaque ligne du plateau doit être affichée sur une ligne séparée, avec "
    r"les valeurs de chaque colonne séparées par un espace."
)

inp_list, out_list, test_cases = [], [], 4
for i in range(test_cases):
    width = int(np.random.randint(500, 1500) / 100)
    inp = str(width) + '\n'
    out = mm.drawImg(chess(height, width)) + '\n'
    inp_list.append(inp)
    out_list.append(out)

cases = {}
cases['skills']      = ["matrices", "boucles", "formatage de la sortie"]
cases['description'] = [{"text": latex_to_text(texto)}]
cases['input']       = inp_list
cases['output']      = out_list

moodle_cases = json.dumps(cases)

caso0_inp = cases['input'][0]
caso0_out = cases['output'][0]
]]
La valeur de height est tirée une seule fois par variante (pour apparaître dans l’énoncé), tandis que width est tirée à chaque cas de test, ce qui augmente la robustesse de la correction automatique.
Il convient de souligner le double rôle de la variable texto dans ce mécanisme. Elle est à la fois :
- le contenu de l’énoncé imprimé, inséré dans la description LaTeX de la question via la balise
[[code:texto]], apparaissant dans le PDF généré par le bouton Create-PDF ; et - une entrée du dictionnaire exporté vers Moodle, via la clé
cases['description'], qui vient composer le JSONmoodle_cases. C’est précisément ce champ que l’activité VPL affiche à l’étudiant lorsqu’il ouvre la question dans Moodle pour la consulter ou soumettre une solution.
Il existe toutefois une différence importante entre ces deux usages : le PDF est composé en LaTeX et interprète donc normalement des commandes comme \textbf{}, \texttt{} ou $...$. Le VPL de Moodle, lui, ne traite pas le LaTeX — il attend du texte brut. C’est pourquoi, lors de la construction de cases['description'], texto n’est pas inséré directement, mais passé par la fonction utilitaire propre à MCTest latex_to_text(), qui supprime (ou convertit) les commandes et symboles LaTeX de l’énoncé, produisant une version en texte simple équivalente. Ainsi, [[code:texto]] dans le PDF continue de recevoir le texto original, avec toute sa mise en forme LaTeX, tandis que cases['description'] reçoit latex_to_text(texto), garantissant que l’énoncé affiché dans Moodle reste lisible même sans prise en charge du LaTeX.
Comme texto est construite à l’intérieur même du bloc [[def: ...]] — dans la même portée où height, width et les autres paramètres sont tirés —, elle est recalculée à chaque variante. Cela garantit que l’énoncé vu par l’étudiant dans Moodle est toujours identique à celui imprimé sur l’épreuve papier, même lorsque le texte change d’un étudiant à l’autre avec les valeurs tirées. La Section A.4 reprend ce point sur un cas réel, dans lequel l’énoncé est nettement plus long et décrit, en plus des paramètres numériques, le scénario visuel lui-même généré pour chaque variante.
La Figure A.1 montre la question de l’échiquier réellement générée par MCTest pour l’une des variantes, avec l’énoncé contenant déjà la valeur tirée de height et l’exemple d’entrée/sortie correspondant au premier cas de test :
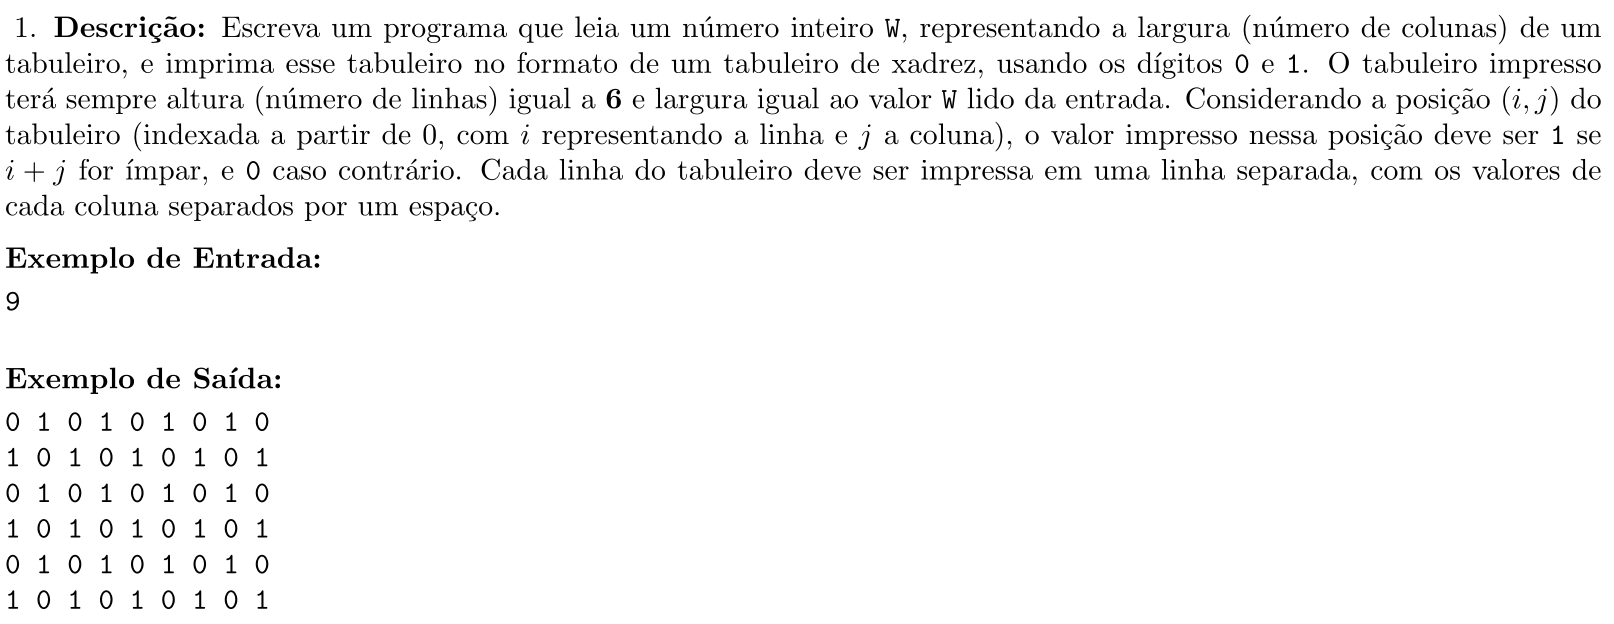
height tirée pour la variante et l’exemple d’entrée/sortie du premier cas de test.
En cliquant sur Create-PDF sur l’écran de la question, une nouvelle variante est générée à chaque clic, ce qui permet de vérifier l’énoncé avant de le publier.
Pour les deux examens du cours, ce mécanisme a été utilisé plus largement : chaque question paramétrique définit non seulement des valeurs numériques, mais aussi, dans certains cas, de petites variations structurelles dans l’énoncé (par exemple, quelle direction cardinale — Nord, Sud, Est, Ouest — doit être évaluée), rendant plus difficile la recherche de solutions toutes faites sur internet ou via des outils d’IA générative.
A.4 Exemple réel : une question du Simulado 4
Pour illustrer le mécanisme décrit dans la section précédente avec un cas concret, voici une question effectivement posée lors du Simulado 4 (sujet im4-Opérateurs morphologiques, difficulté 1, taxonomie de Bloom « se souvenir »), du type question de programmation paramétrée avec intégration Moodle+VPL.
La question demande à l’étudiant d’écrire un programme capable de :
- lire une image binaire, corrompue par un bruit poivre et sel, contenant au moins deux objets géométriques isolés ;
- appliquer un filtrage morphologique (ouverture suivie d’une fermeture) pour éliminer le bruit ;
- extraire, à partir de l’image filtrée, les mesures géométriques de chaque objet (aire, périmètre, centre, boîte englobante, circularité, solidité et nombre de sommets), à l’aide de la fonction auxiliaire
mm.measure; - trier les objets par position (coordonnée X de la boîte englobante, avec Y comme critère de départage) et réattribuer les identifiants séquentiellement ;
- afficher la matrice nettoyée et le tableau des mesures dans le format attendu par le correcteur automatique.
Dans le bloc [[def: ... ]] correspondant, un générateur de scène (gerarCena) tire aléatoirement la hauteur et la largeur de l’image, le type, la taille et la position de chaque objet (carré, rectangle, triangle ou bloc), en garantissant qu’ils ne se chevauchent pas, puis ajoute un bruit poivre et sel avec une probabilité de 3 % par pixel. Dix cas de test distincts sont ainsi générés pour chaque variante de l’examen, et la paire entrée/sortie du premier cas est réutilisée dans l’énoncé lui-même comme exemple pour l’étudiant. La bibliothèque de morphologie (mm) est importée directement depuis morph.py, également disponible comme module utilitaire de MCTest.
En résumé, l’énoncé demande à l’étudiant un programme qui :
- lit, sur la première ligne, deux entiers H et W (hauteur et largeur de l’image) ;
- lit les H lignes suivantes de la matrice binaire (0 et 1 séparés par des espaces), à l’aide de
mm.readImg(H, W); - applique un filtrage morphologique pour supprimer le bruit poivre et sel ;
- affiche la matrice déjà filtrée, en 0 et 1 séparés par des espaces ;
- extrait les mesures géométriques des objets avec
mm.measure(imgLimpa); - trie les objets et affiche le tableau des mesures dans le format attendu.
L’énoncé apporte encore deux observations importantes pour la correction automatique : (i) l’aire calculée par OpenCV (cv2.contourArea) correspond au polygone continu délimité par les centres des pixels de bord, et est donc inférieure au simple comptage des pixels à 1 (np.sum) ; et (ii) la liste des objets doit être triée par ordre croissant selon la coordonnée X de la boîte englobante (bbox[0]), avec la coordonnée Y (bbox[1]) comme critère de départage, les identifiants étant réattribués séquentiellement de 1 à N après le tri.
Comme dans l’exemple de la Section A.3, le texte de l’énoncé n’est pas non plus fixe ici : il est construit à l’intérieur même du bloc [[def: ... ]], dans la variable Python texto, et joue le même double rôle déjà décrit — il alimente le PDF via [[code:texto]] et est exporté, déjà converti par latex_to_text(), dans cases['description'] au sein de moodle_cases, cette dernière étant la version affichée à l’étudiant dans le VPL de Moodle. La différence est que, dans ce cas réel, c’est le scénario visuel (image bruitée, nombre et position des objets) qui change d’un étudiant à l’autre à chaque variante, tandis que la rédaction de texto reste fixe entre les variantes, puisque seules les données numériques (image et cas de test) sont tirées. L’idéal serait que la rédaction varie elle aussi à chaque génération, comme dans l’exemple précédent, où la valeur de height était interpolée directement dans le texte de la description. La structure réellement utilisée (avec les extraits de tirage du scénario omis par souci de concision) est :
[[code:texto]]

\vspace{2mm}\noindent\textbf{Exemple d'entrée :}\vspace{-2mm}\
\begin{verbatim}
[[code:caso0_inp]]
\end{verbatim}
\vspace{-2mm}\noindent\textbf{Exemple de sortie :}\vspace{-2mm}\
\begin{verbatim}
[[code:caso0_out]]
\end{verbatim}

\begin{comment}
[[code:moodle_cases]]
\end{comment}

[[def:
import json
import numpy as n
import cv2
from topic.morph import mm # DOIT inclure "topic." dans MCTest

# ... génération de la scène, du bruit et des 10 cas de test (inplist/outlist) ...

# ÉNONCÉ COMPLET, AVEC EXPLICATION DE L'AIRE ET DU TRI
texto = (
    "Une image binaire corrompue par un bruit poivre et sel contient au moins deux objets géométriques isolés.\n\n"
    "Écrivez un programme qui :\n"
    "1. Lit deux entiers ..."
)

cases = {}
cases['skills']      = ["morphologie mathematique", "suppression de bruit", "mm.measure", "tabulation"]
cases['description'] = [{"text": latex_to_text(texto)}]
cases['input']       = np.array(inplist).tolist()
cases['output']      = np.array(outlist).tolist()

moodle_cases = json.dumps(cases)
caso0_inp = cases['input'][0]
caso0_out = cases['output'][0]
]]
Ci-dessous, la photographie de la question effectivement générée et imprimée pour l’une des 110 variantes du Simulado 4, montrant l’énoncé, l’image d’entrée bruitée et l’exemple de sortie attendu (image filtrée et tableau des mesures) :
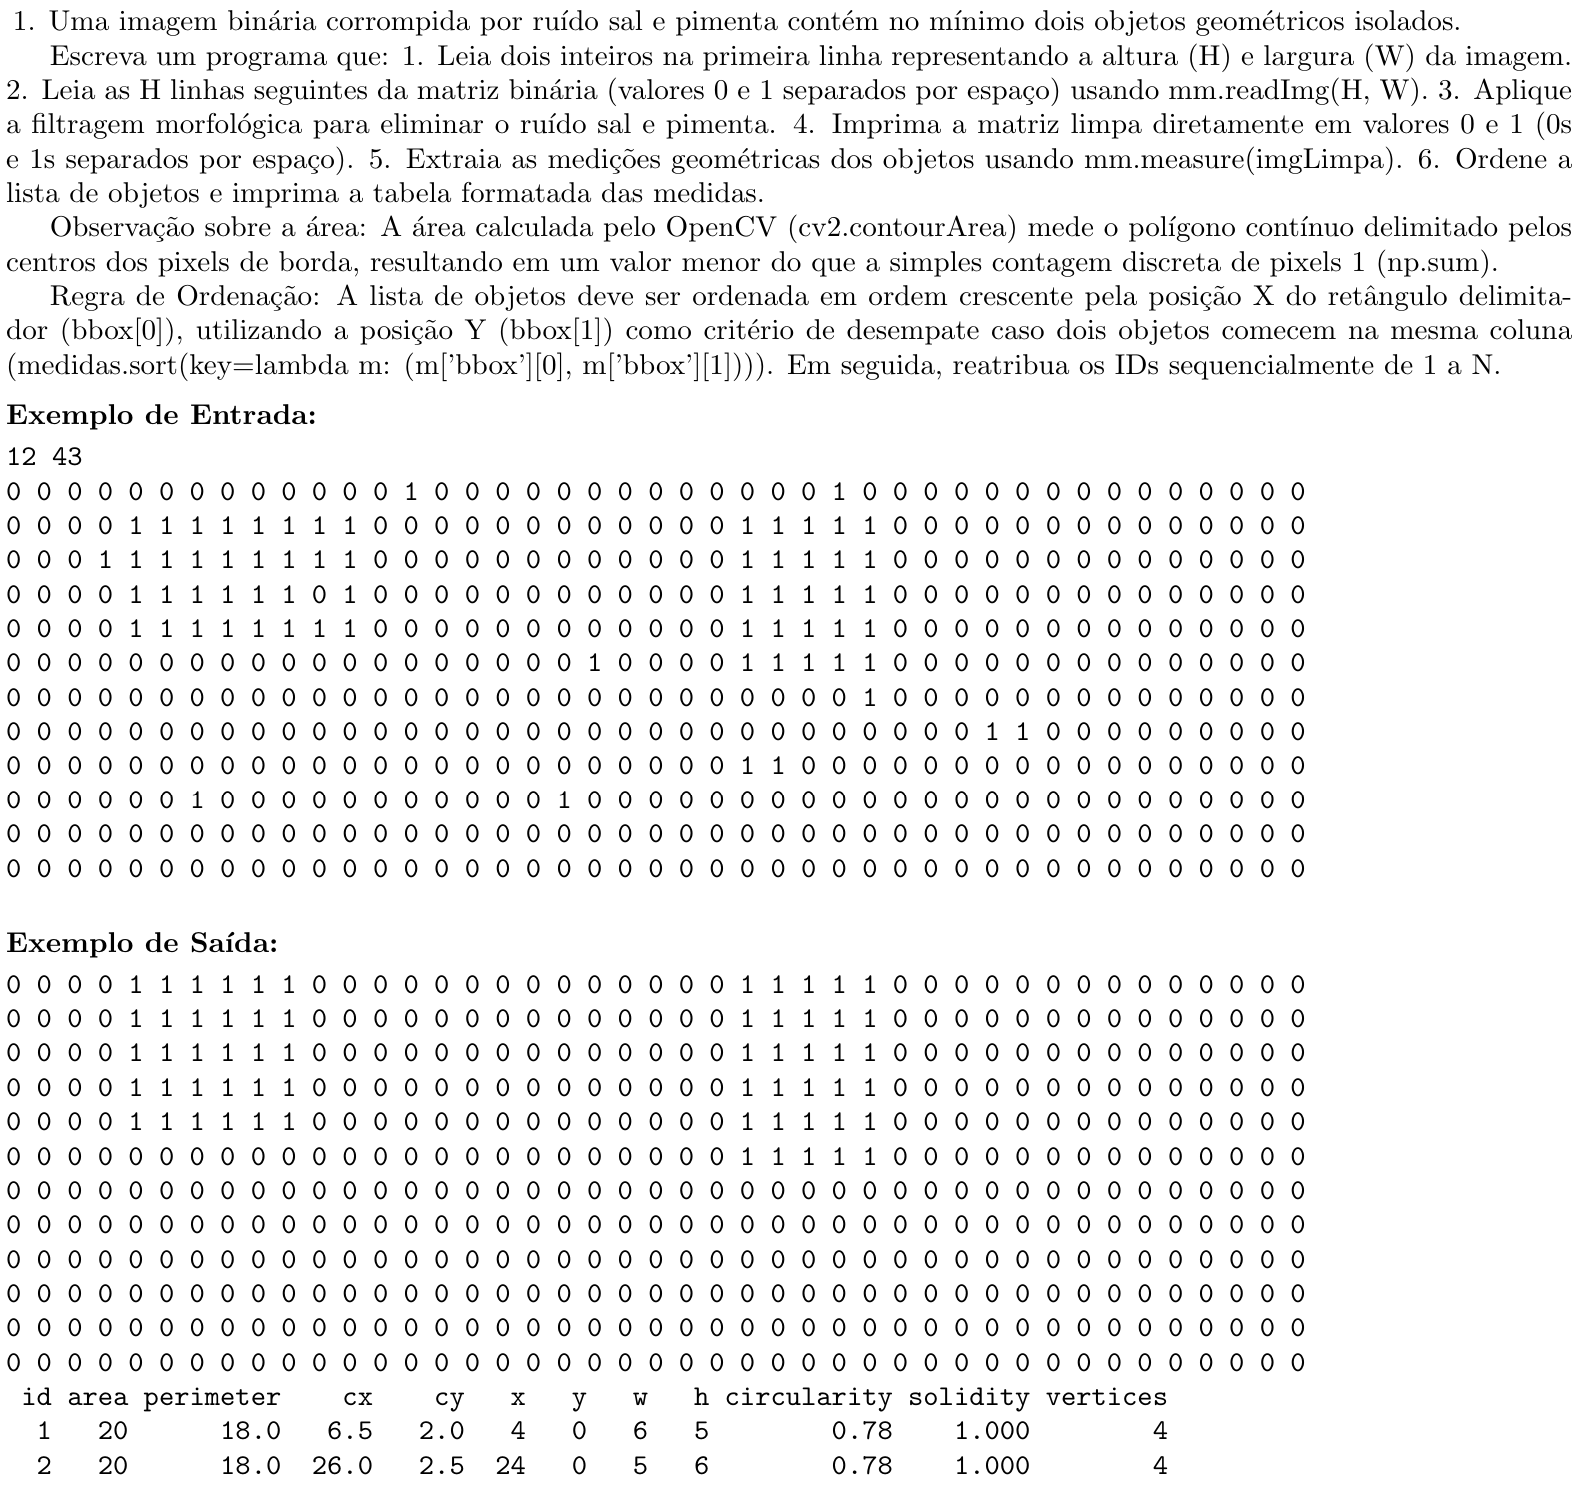
A.5 Remarques finales
Cette annexe a résumé les étapes pour installer MCTest, créer des examens et construire des questions paramétriques avec intégration au VPL de Moodle. L’utilisation combinée de variables tirées dans la description ([[code:...]]) et de code Python intégré à la question elle-même ([[def: ... ]]) permet de générer des centaines de variantes d’examen à partir d’un seul modèle, chacune corrigée automatiquement et de manière cohérente — la variable texto, en particulier, garantissant que le même énoncé est affiché aussi bien dans le PDF imprimé que lors de la consultation de la question par l’étudiant dans Moodle. L’exemple réel du Simulado 4 (Section A.4) illustre comment ce mécanisme est utilisé en pratique pour générer des questions de programmation avec des scénarios visuels différents pour chaque étudiant. L’Annexe B détaille comment ces variantes sont publiées et corrigées dans Moodle, et l’Annexe C décrit comment restreindre l’accès aux examens à l’aide de SEB.