CLASSES = [
    'Triangle', 'Square', 'Pentagon', 'Hexagon',
    'Heptagon', 'Circle', 'Ellipse', 'Star', 'Cross'
]
N_LADOS = {'Triangle': 3, 'Square': 4, 'Pentagon': 5, 'Hexagon': 6, 'Heptagon': 7}
def poligono_regular(cx, cy, r, n_lados, rot_graus):
ang0 = np.deg2rad(rot_graus - 90)
angs = ang0 + 2 * np.pi * np.arange(n_lados) / n_lados
return np.stack([cx + r * np.cos(angs), cy + r * np.sin(angs)], axis=1)
def poligono_estrela(cx, cy, r_externo, rot_graus, n_pontas=5):
r_interno = r_externo * 0.45
ang0 = np.deg2rad(rot_graus - 90)
angs = ang0 + np.pi * np.arange(2 * n_pontas) / n_pontas
raios = np.where(np.arange(2 * n_pontas) % 2 == 0, r_externo, r_interno)
return np.stack([cx + raios * np.cos(angs), cy + raios * np.sin(angs)], axis=1)
def poligono_cruz(cx, cy, r, rot_graus, espessura_rel=0.35):
w = r * espessura_rel
base = np.array([
(-w, -r), (w, -r), (w, -w), (r, -w), (r, w), (w, w),
(w, r), (-w, r), (-w, w), (-r, w), (-r, -w), (-w, -w),
])
theta = np.deg2rad(rot_graus)
R = np.array([[np.cos(theta), -np.sin(theta)], [np.sin(theta), np.cos(theta)]])
return base @ R.T + np.array([cx, cy])
def desenha_objeto(img, classe_idx, cx, cy, tamanho, rotacao, cor):
nome = CLASSES[classe_idx]
if nome in N_LADOS:
pts = poligono_regular(cx, cy, tamanho, N_LADOS[nome], rotacao)
cv2.fillPoly(img, [pts.astype(np.int32)], cor)
xs, ys = pts[:, 0], pts[:, 1]
elif nome == 'Star':
pts = poligono_estrela(cx, cy, tamanho, rotacao)
cv2.fillPoly(img, [pts.astype(np.int32)], cor)
xs, ys = pts[:, 0], pts[:, 1]
elif nome == 'Cross':
pts = poligono_cruz(cx, cy, tamanho, rotacao)
cv2.fillPoly(img, [pts.astype(np.int32)], cor)
xs, ys = pts[:, 0], pts[:, 1]
elif nome == 'Circle':
cv2.circle(img, (int(cx), int(cy)), int(tamanho), cor, -1)
xs, ys = np.array([cx - tamanho, cx + tamanho]), np.array([cy - tamanho, cy + tamanho])
else: # Ellipse
eixo = (int(tamanho), int(tamanho * 0.6))
cv2.ellipse(img, (int(cx), int(cy)), eixo, rotacao, 0, 360, cor, -1)
ang = np.deg2rad(rotacao)
dx = np.hypot(eixo[0] * np.cos(ang), eixo[1] * np.sin(ang))
dy = np.hypot(eixo[0] * np.sin(ang), eixo[1] * np.cos(ang))
xs, ys = np.array([cx - dx, cx + dx]), np.array([cy - dy, cy + dy])
return xs.min(), ys.min(), xs.max(), ys.max()
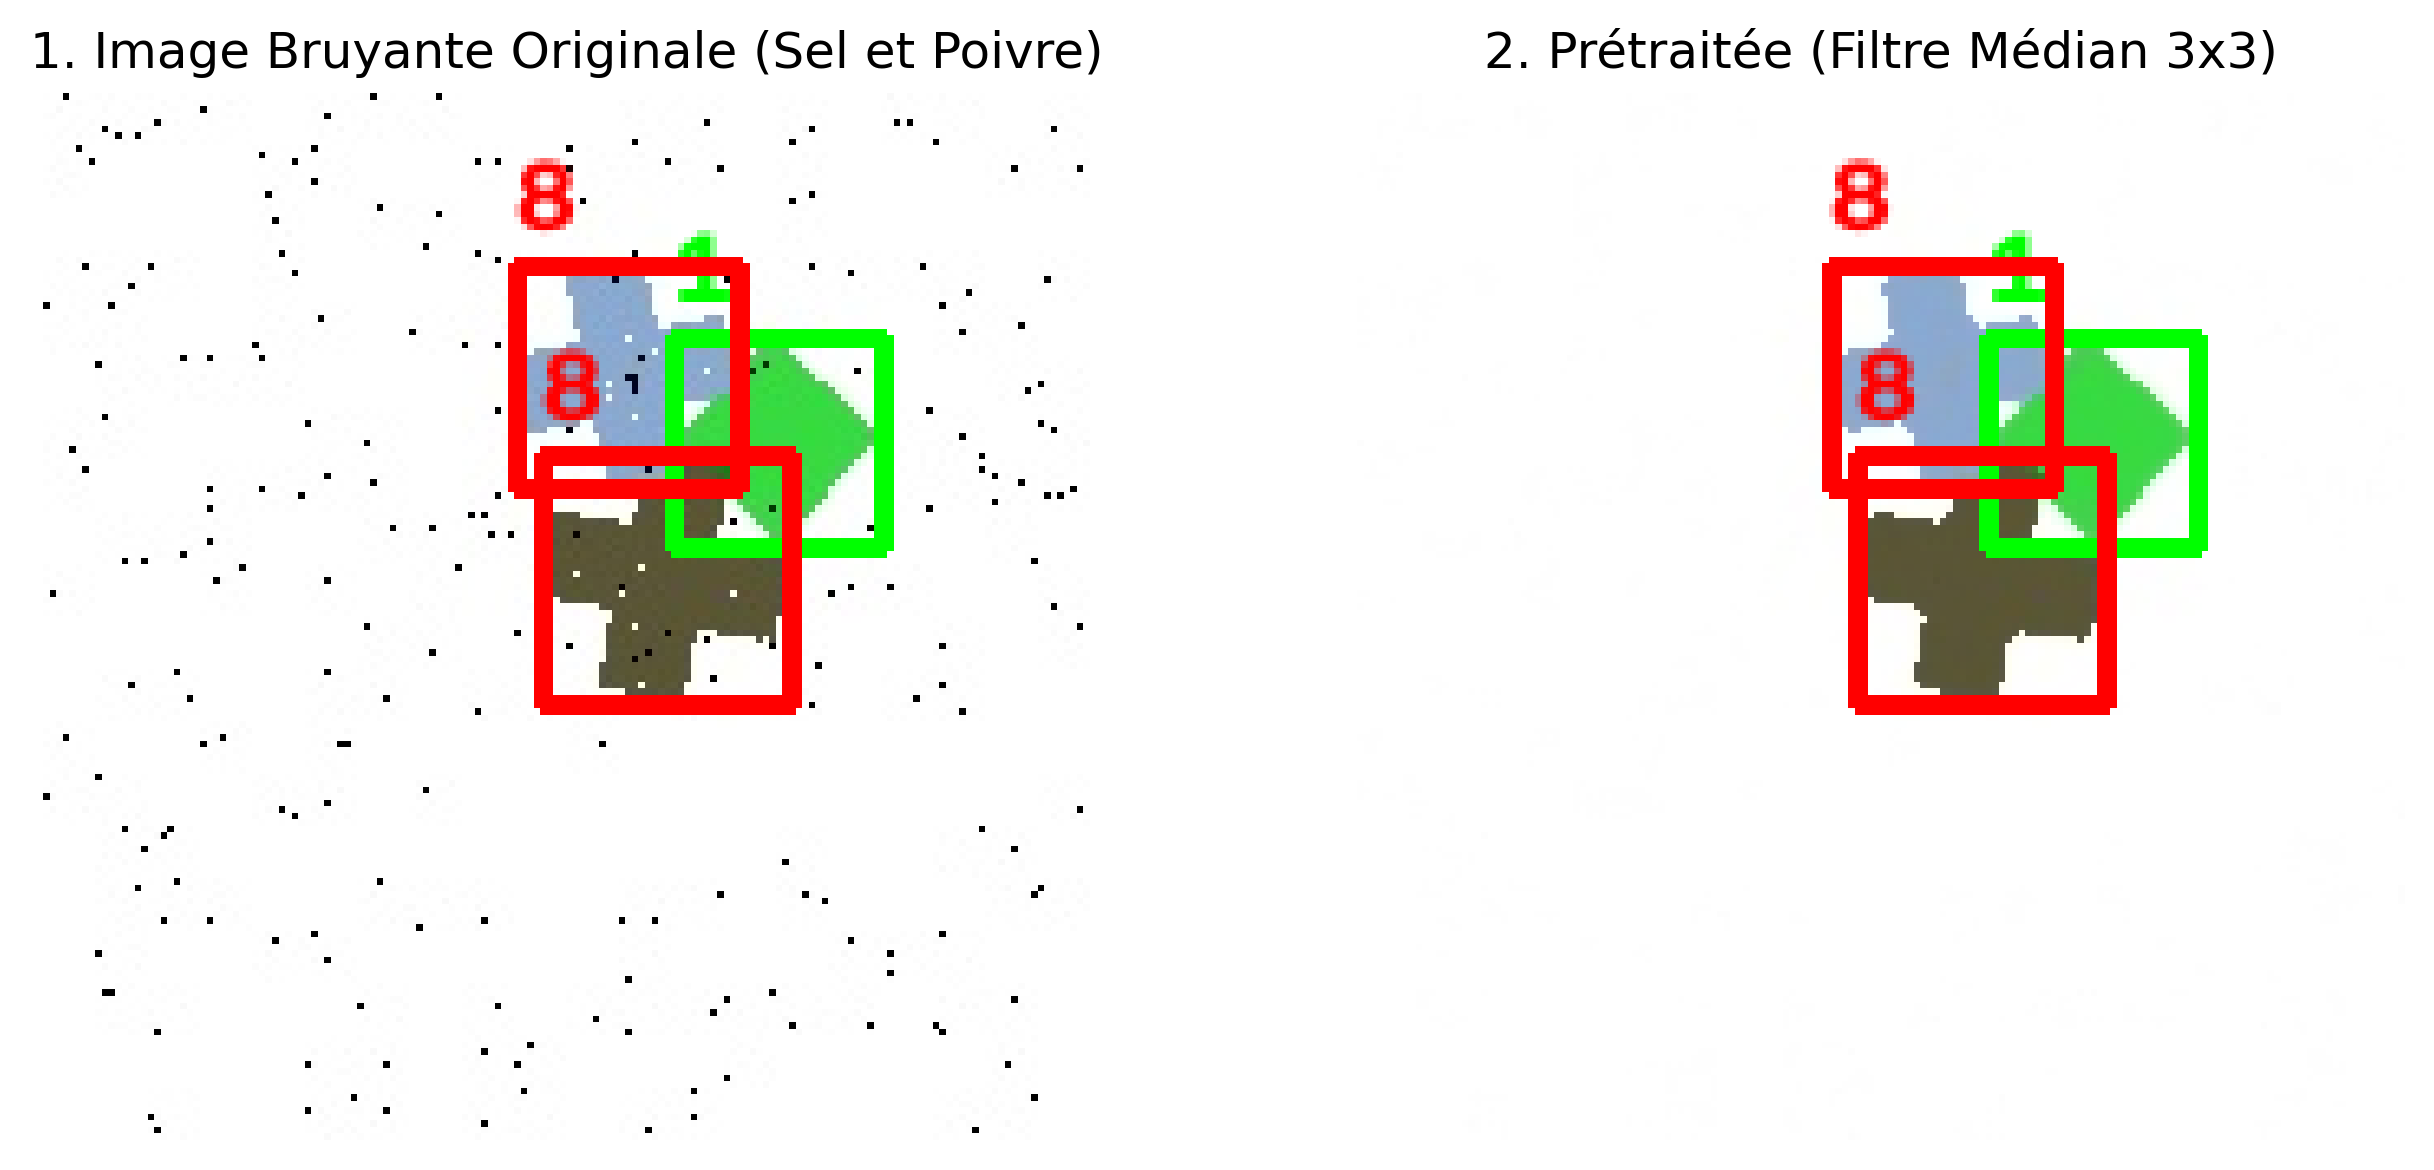
def adiciona_ruido_sal_pimenta(img, quantidade=0.05):
img_ruidosa = img.copy()
h, w, c = img_ruidosa.shape
num_ruido = int(quantidade * h * w)
# Sel (255, 255, 255)
coords_sal = [np.random.randint(0, i - 1, num_ruido) for i in (h, w)]
img_ruidosa[coords_sal[0], coords_sal[1]] = [255, 255, 255]
# Poivre (0, 0, 0)
coords_pimenta = [np.random.randint(0, i - 1, num_ruido) for i in (h, w)]
img_ruidosa[coords_pimenta[0], coords_pimenta[1]] = [0, 0, 0]
return img_ruidosa
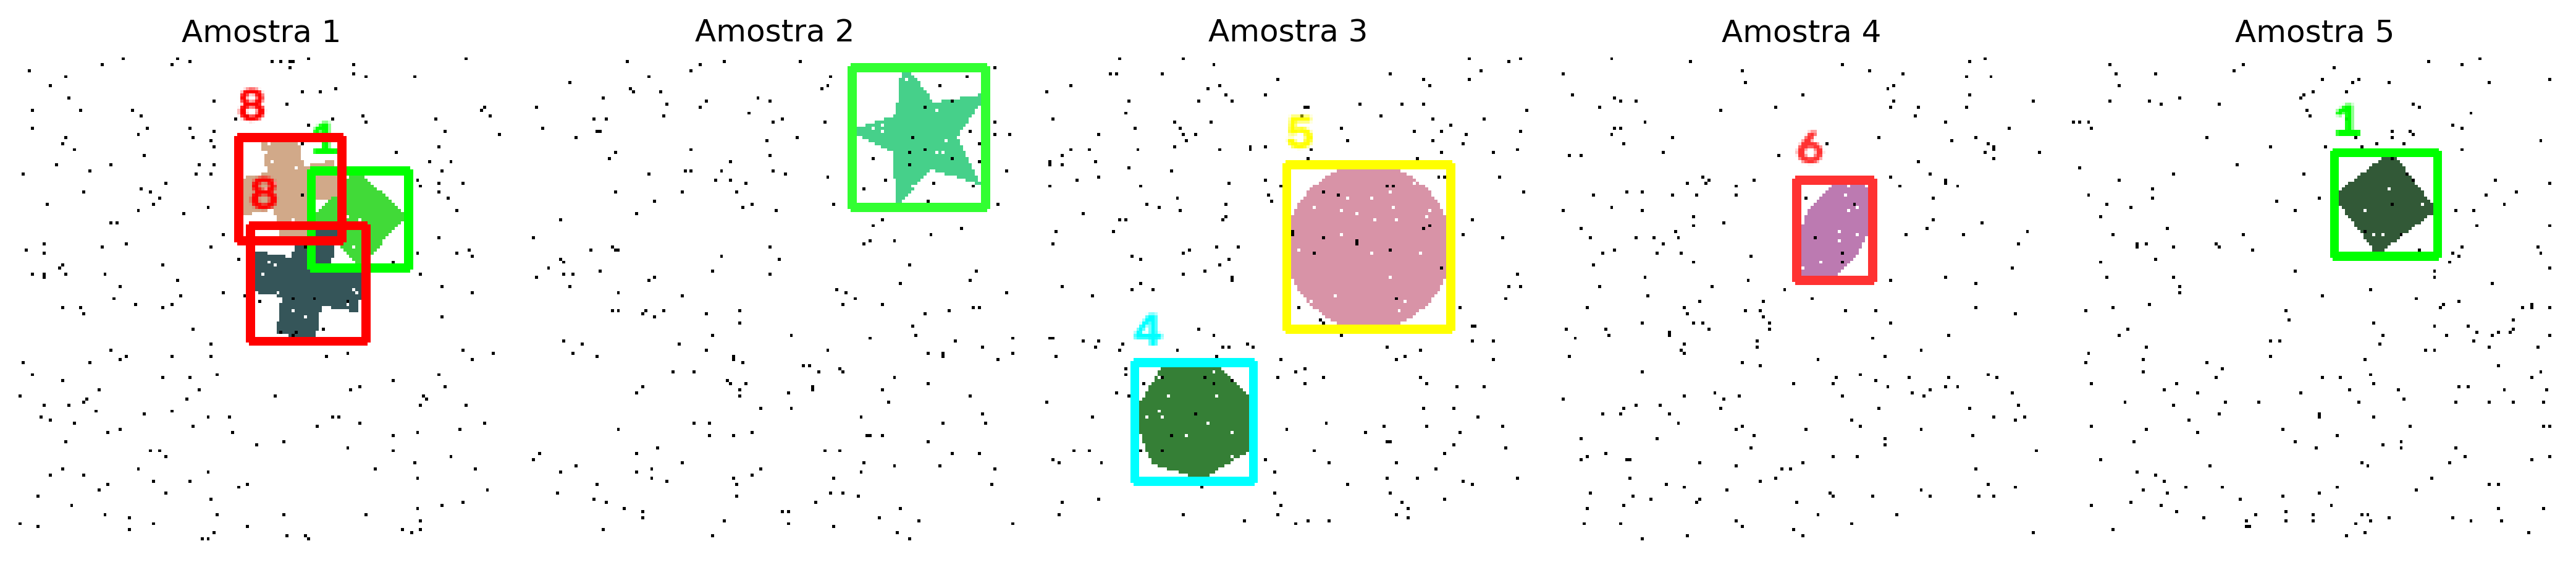
def gera_imagem_ruidosa(tam_img=160, n_objetos=(1, 3), taxa_ruido=0.01, rng=None):
rng = rng or random.Random()
img_limpa = np.full((tam_img, tam_img, 3), 255, dtype=np.uint8)
anotacoes = []
for _ in range(rng.randint(*n_objetos)):
classe_idx = rng.randrange(len(CLASSES))
tamanho = rng.randint(tam_img // 10, tam_img // 5)
cx = rng.randint(tamanho + 2, tam_img - tamanho - 2)
cy = rng.randint(tamanho + 2, tam_img - tamanho - 2)
rotacao = rng.uniform(0, 360)
cor = tuple(rng.sample(range(30, 226), 3))
x0, y0, x1, y1 = desenha_objeto(img_limpa, classe_idx, cx, cy, tamanho, rotacao, cor)
x0, y0 = max(x0, 0), max(y0, 0)
x1, y1 = min(x1, tam_img), min(y1, tam_img)
# Format YOLO : (classe, x_centre, y_centre, largeur, hauteur) normalisés
xc, yc = (x0 + x1) / 2 / tam_img, (y0 + y1) / 2 / tam_img
w, h = (x1 - x0) / tam_img, (y1 - y0) / tam_img
anotacoes.append((classe_idx, xc, yc, w, h))
img_ruidosa = adiciona_ruido_sal_pimenta(img_limpa, quantidade=taxa_ruido)
return img_ruidosa, anotacoes

9.4.9 Comment le Gradient Ajuste les Kernels de la Convolution
La compréhension du processus d’apprentissage dans un réseau neuronal convolutif (CNN) nécessite l’élucidation d’un mécanisme fondamental : comment les coefficients aléatoires d’un filtre initial se transforment-ils en détecteurs précis de bords, de textures et de motifs complexes ?
La réponse réside dans le principe du partage de poids (weight sharing). Pendant l’étape de propagation avant (forward pass), le même filtre de dimension \(3\times3\) glisse sur toute l’étendue de l’image d’entrée. Par conséquent, chaque poids du kernel — comme l’élément \(K[0][0]\) dans le coin supérieur gauche — est réutilisé de multiples fois sur les différentes régions spatiales de la donnée d’entrée.
Pendant l’étape de rétropropagation (backpropagation), cette réutilisation établit une dynamique directe : chaque position spatiale traitée par le filtre génère une contribution individuelle (« vote ») pour la mise à jour du poids correspondant.
9.4.9.1 L’Intuition Derrière le Calcul
Soit \(Z[r][c]\) la carte de caractéristiques pré-activation à la position \((r,c)\) de la fenêtre glissante, obtenue par corrélation croisée entre le kernel \(K\) et l’entrée \(X\) :
\[ Z[r][c] = \sum_{k_r} \sum_{k_c} K[k_r][k_c] \cdot X[r + k_r][c + k_c] \]
En appliquant la règle de la chaîne pour déterminer la contribution d’un poids spécifique \(K[k_r][k_c]\) à la fonction de perte \(L\), on obtient les étapes suivantes :
Erreur Locale (\(dZ\)) : À chaque position \((r,c)\), on calcule la dérivée partielle de la fonction de perte par rapport à la pré-activation : \[dZ[r][c] = \frac{\partial L}{\partial Z[r][c]}\] qui quantifie la responsabilité de cette position spécifique dans l’erreur totale du réseau (\(L\)).
Contribution du Poids : Comme \(\frac{\partial Z[r][c]}{\partial K[k_r][k_c]} = X[r + k_r][c + k_c]\), l’influence d’un poids spécifique \(K[k_r][k_c]\) sur l’erreur de la position \((r,c)\) est obtenue en multipliant l’erreur locale \(dZ[r][c]\) par la valeur du pixel d’entrée aligné sur ce poids au moment du calcul : \[dZ[r][c] \cdot X[r + k_r][c + k_c]\]
Accumulation des Gradients : Le gradient final du poids correspond à la somme des contributions (« votes ») de toutes les positions parcourues par la fenêtre glissante :
\[ \frac{\partial L}{\partial K[k_r][k_c]} = \sum_{(r,c)} dZ[r][c] \cdot X[r + k_r][c + k_c] \]
Cette formulation assure une parité directe entre la dérivation analytique et les valeurs calculées dans le simulateur d’inspection du gradient (Figure 9.12).
9.4.9.2 Le Rôle de la Fonction ReLU comme « Filtre de Pertinence »
L’application de la fonction d’activation ReLU (\(\max(0, z)\)) immédiatement après la convolution introduit une propriété de sélectivité au gradient :
9.4.9.3 Mise à Jour des Poids via la Descente de Gradient
Après la consolidation des gradients accumulés de toutes les positions, la mise à jour du poids se fait selon l’algorithme de la Descente de Gradient Stochastique (SGD) :
\[ K[k_r][k_c] \leftarrow K[k_r][k_c] - \eta \cdot \frac{\partial L}{\partial K[k_r][k_c]} \]
où \(\eta\) désigne le taux d’apprentissage (learning rate).
9.4.9.4 Exploration du Simulateur Interactif
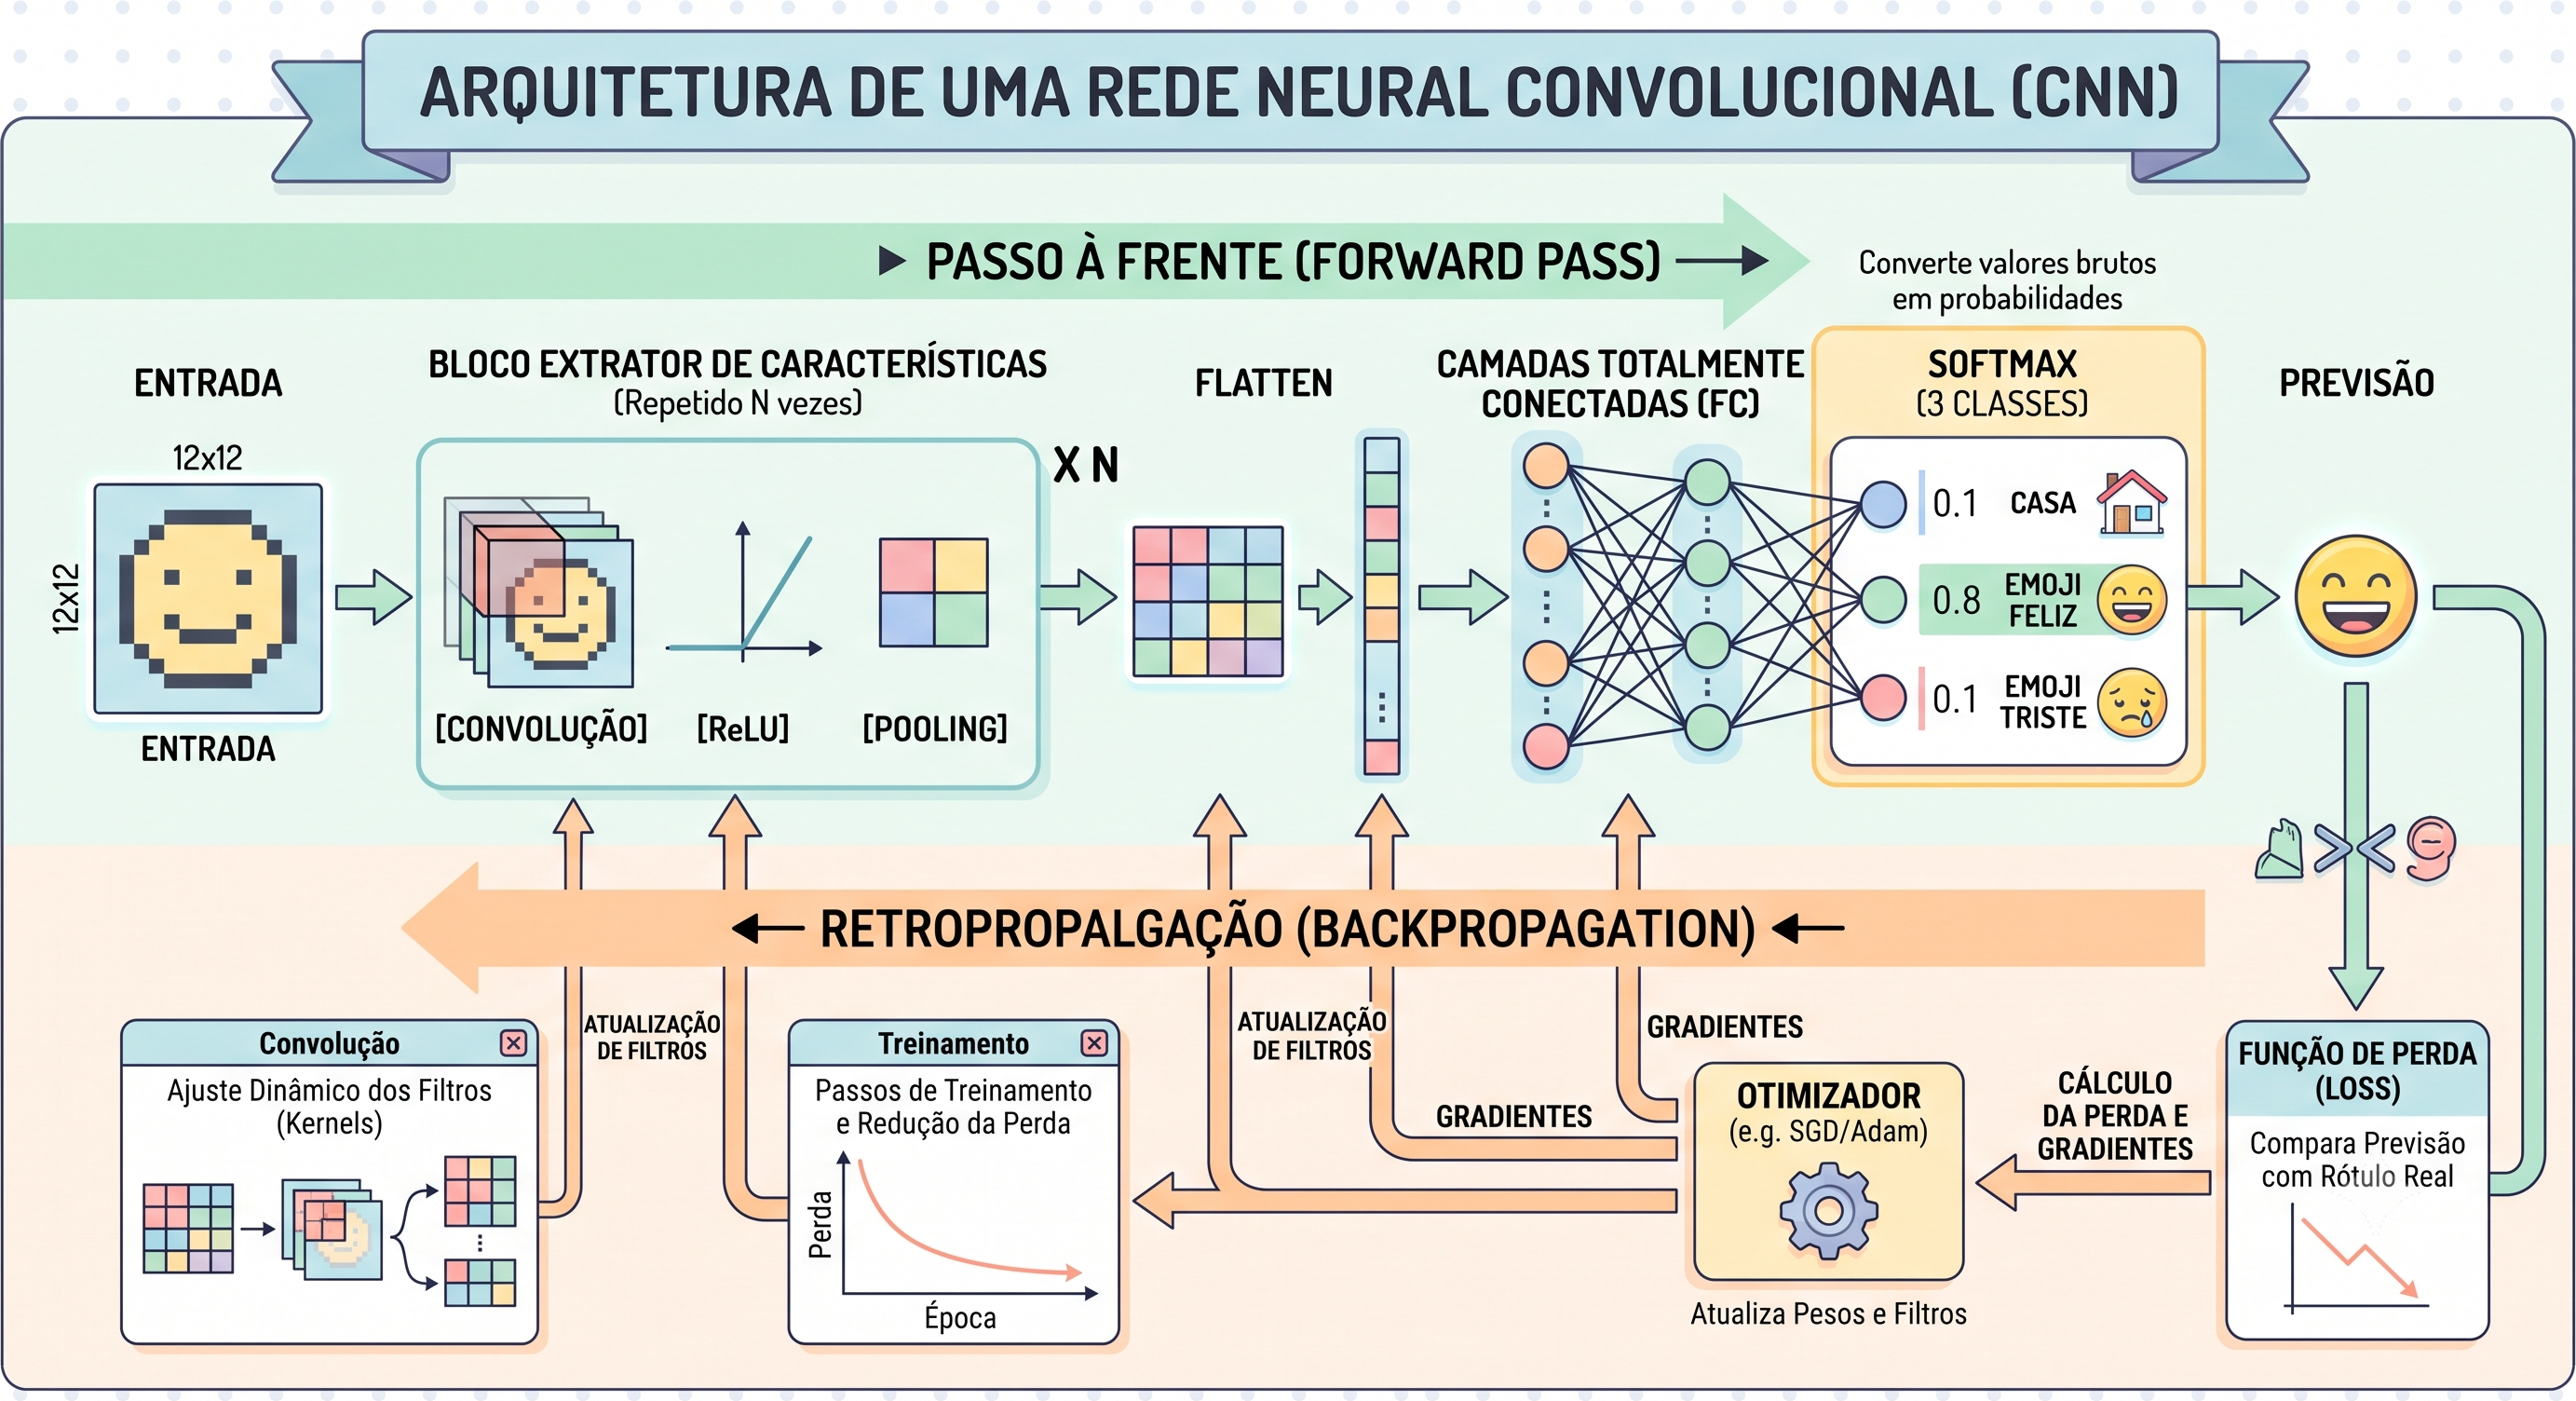
Dans le simulateur d’architecture (Figure 9.11), on observe l’erreur \(dZ\) dérivée de la rétropropagation multicouche complète, issue de la perte d’entropie croisée (Softmax) sur les images d’entrée \(12\times12\).
Pour permettre la vérification analytique du gradient sans la surcharge de \(100\) positions de convolution et de rétropropagation multicouche, le simulateur d’apprentissage du kernel (Figure 9.12) adopte un modèle d’inspection réduit (\(6\times6\)). Dans ce scénario, on simplifie le problème en remplaçant la classification complexe par une métadonnée de calibration scalaire : on ajuste le filtre pour produire une réponse accumulée prédéfinie (\(\text{cible} = 9\)) lors de l’identification d’un motif spécifique (comme un bord à 45 degrés). Le mécanisme d’accumulation des gradients (\(dZ \cdot X\)) reste rigoureusement identique dans les deux formulations.
Pour inspecter cette dynamique au niveau numérique, on utilise le simulateur sur Figure 9.12:
9.4.9.4.1 Roteiro Sugerido de Experimentação:
🔍 Comment est-il mis à jour ?
• ∇K = somme des 16 votes dZ × X.
🔍 Comment fonctionne X ?
🔍 Comment calcule Z ?
Multiplication point par point du filtre 3×3 sur X :
🔍 Comment calcule A ?
🔍 Comment calcule dZ, S et la Perte ?
• Objectif : L → 0 (S → cible).
• Si bloqué à L = 40.5 : Un "dépassement" (saut exagéré) s'est produit. Les poids sont devenus très négatifs, générant Z ≤ 0 (mort de ReLU). Avec S = 0, la perte reste bloquée à ½(0 − 9)² = 40.5.
Les simulateurs de cette section démontrent, de manière séquentielle, comment un CNN transforme une image d’entrée en une estimation probabiliste et comment ses paramètres sont optimisés lors de l’entraînement :
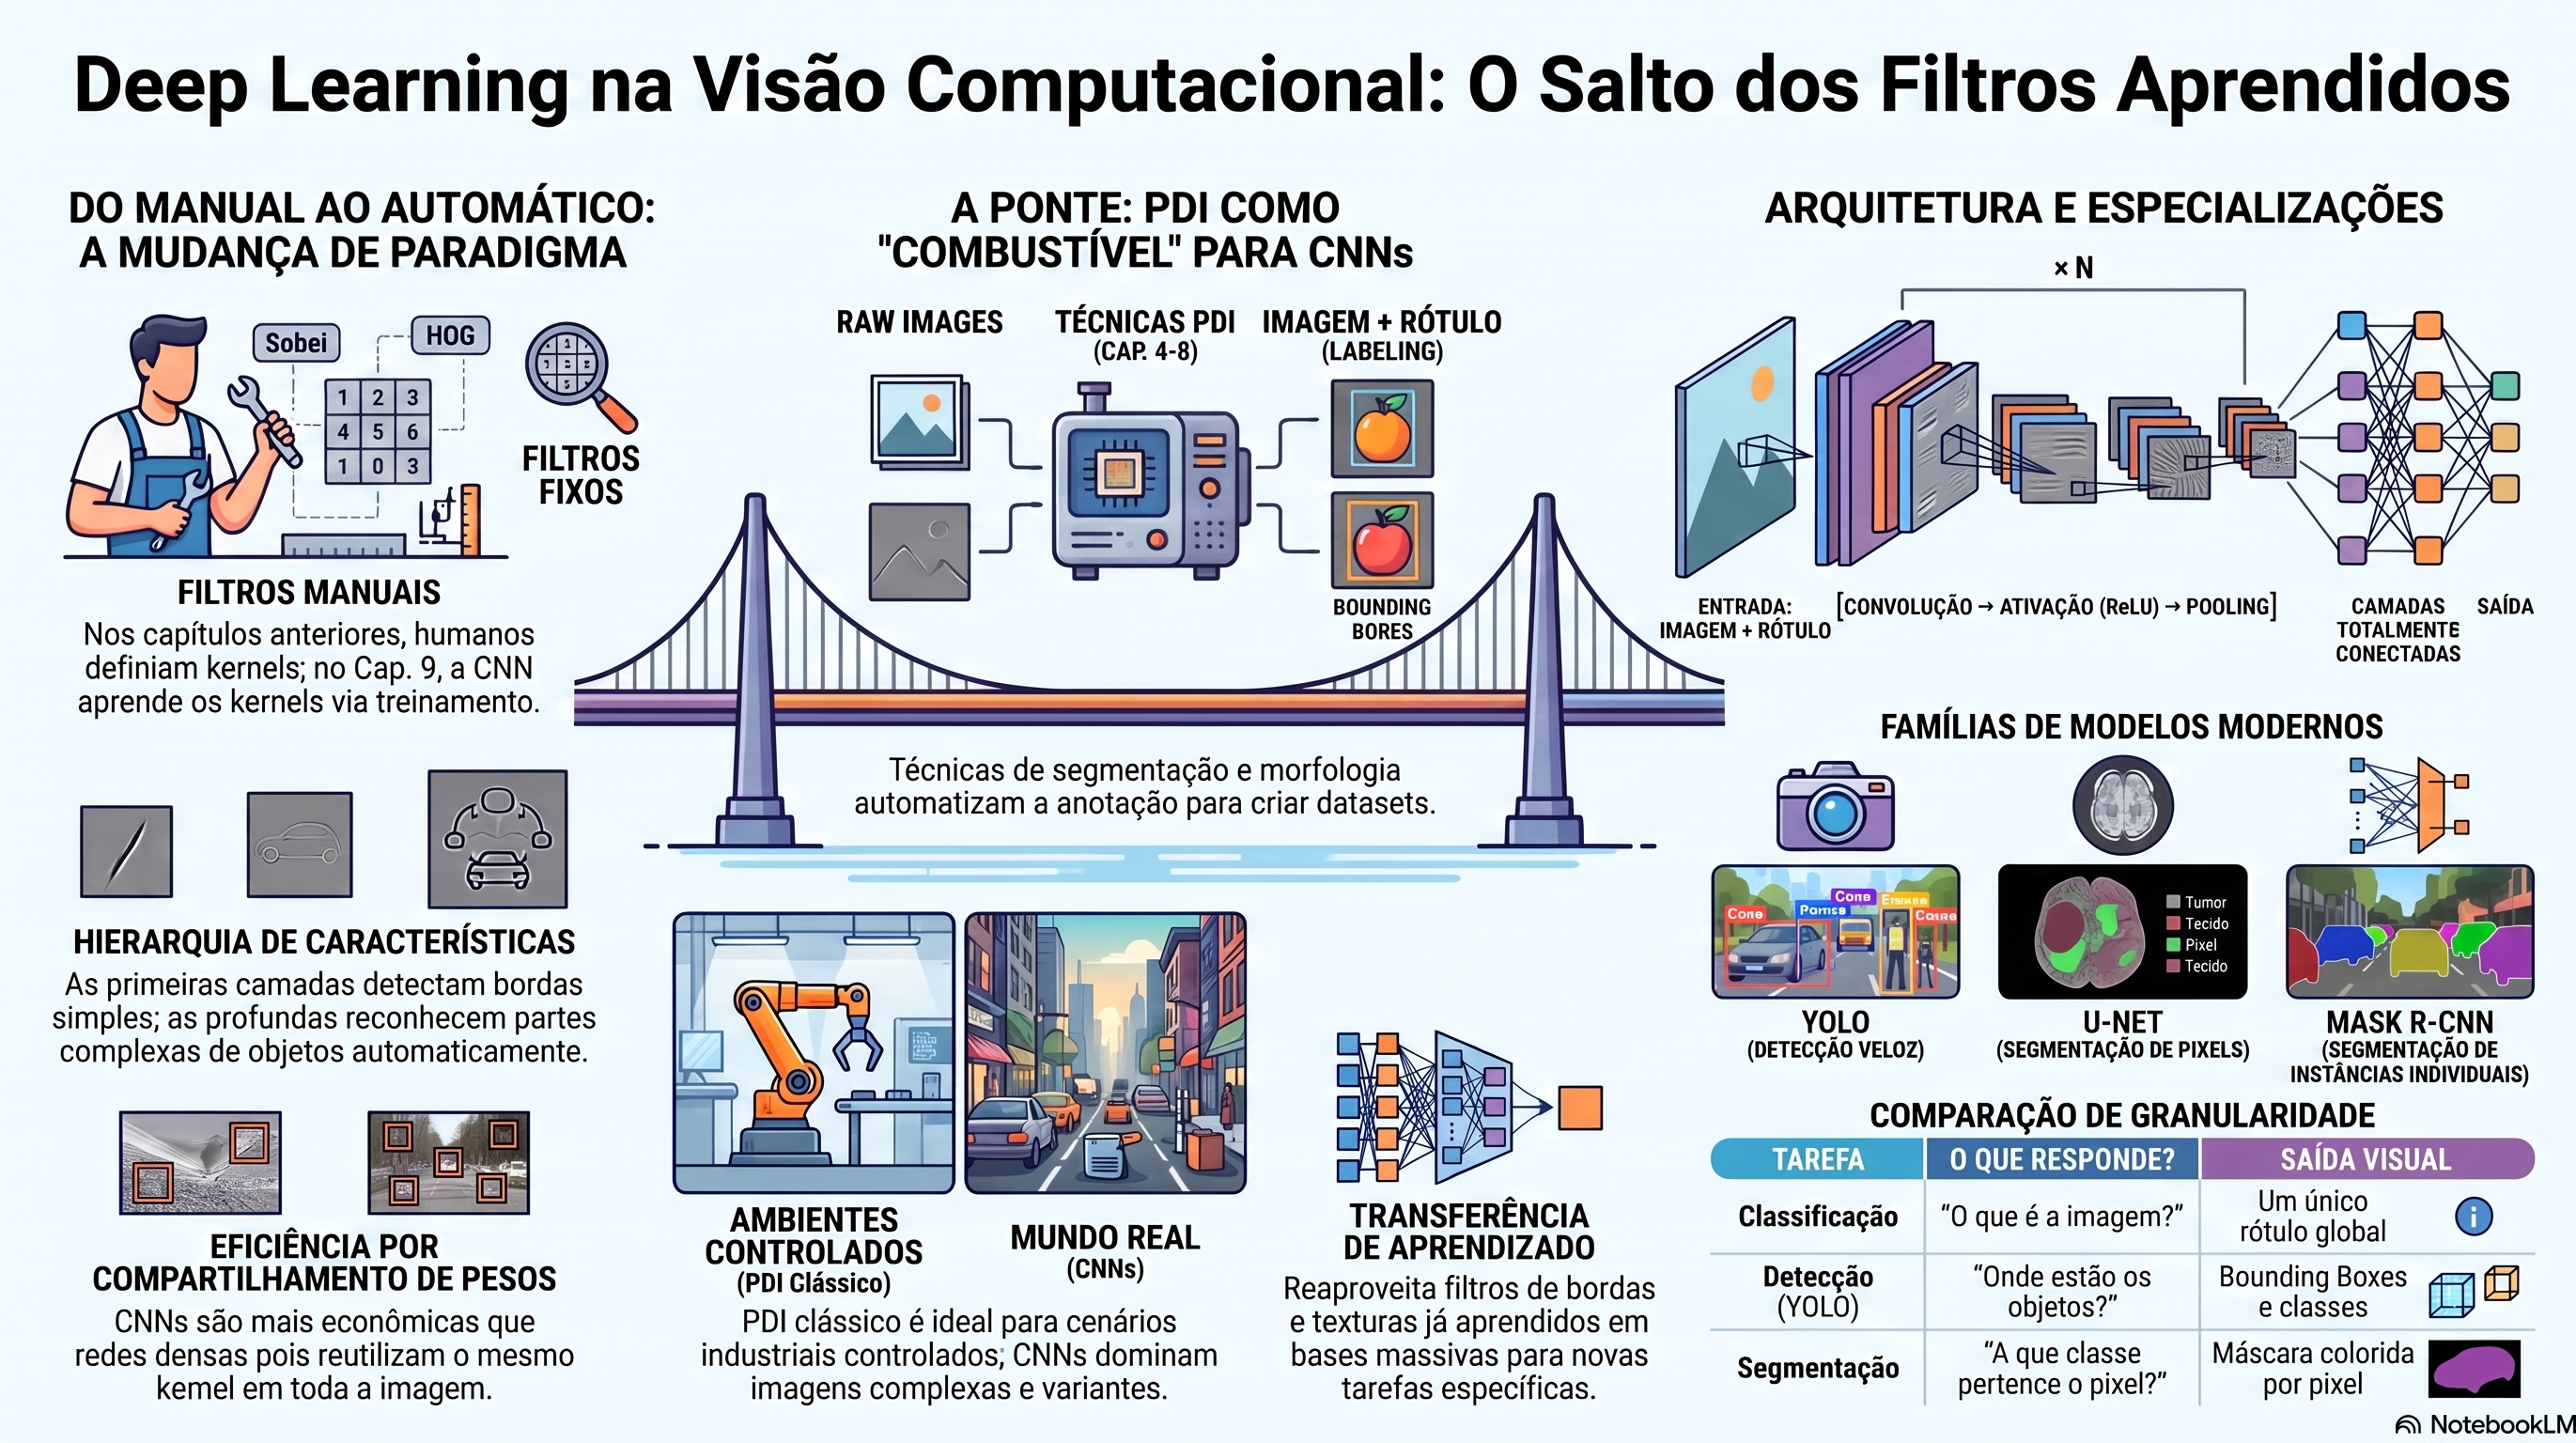
Au fil des itérations, les filtres convolutifs se transforment de valeurs stochastiques en détecteurs spécialisés : les couches initiales apprennent des primitives visuelles de bas niveau (comme les bords et les textures), tandis que les couches plus profondes consolident ces représentations en structures abstraites et sémantiques.